
多人游戏与网络同步 / 系统课时
快照与增量怎么组合更省流量
快照与增量怎么组合更省流量
断线恢复既不能每次都下发完整世界,也不能只依赖无限增长的增量日志。本篇用“基线快照 + 版本化增量 + 分段优先级”组合恢复,让短暂掉线走小包补齐,长时间掉线也能在可控流量内重新得到一致状态。
学习目标
- 区分全量快照、增量补齐与分段恢复各自适用的断线区间
- 根据客户端版本和服务端保留窗口选择恢复路径
- 用优先级、压缩和批次控制降低大世界恢复峰值
三种恢复材料各解决什么问题
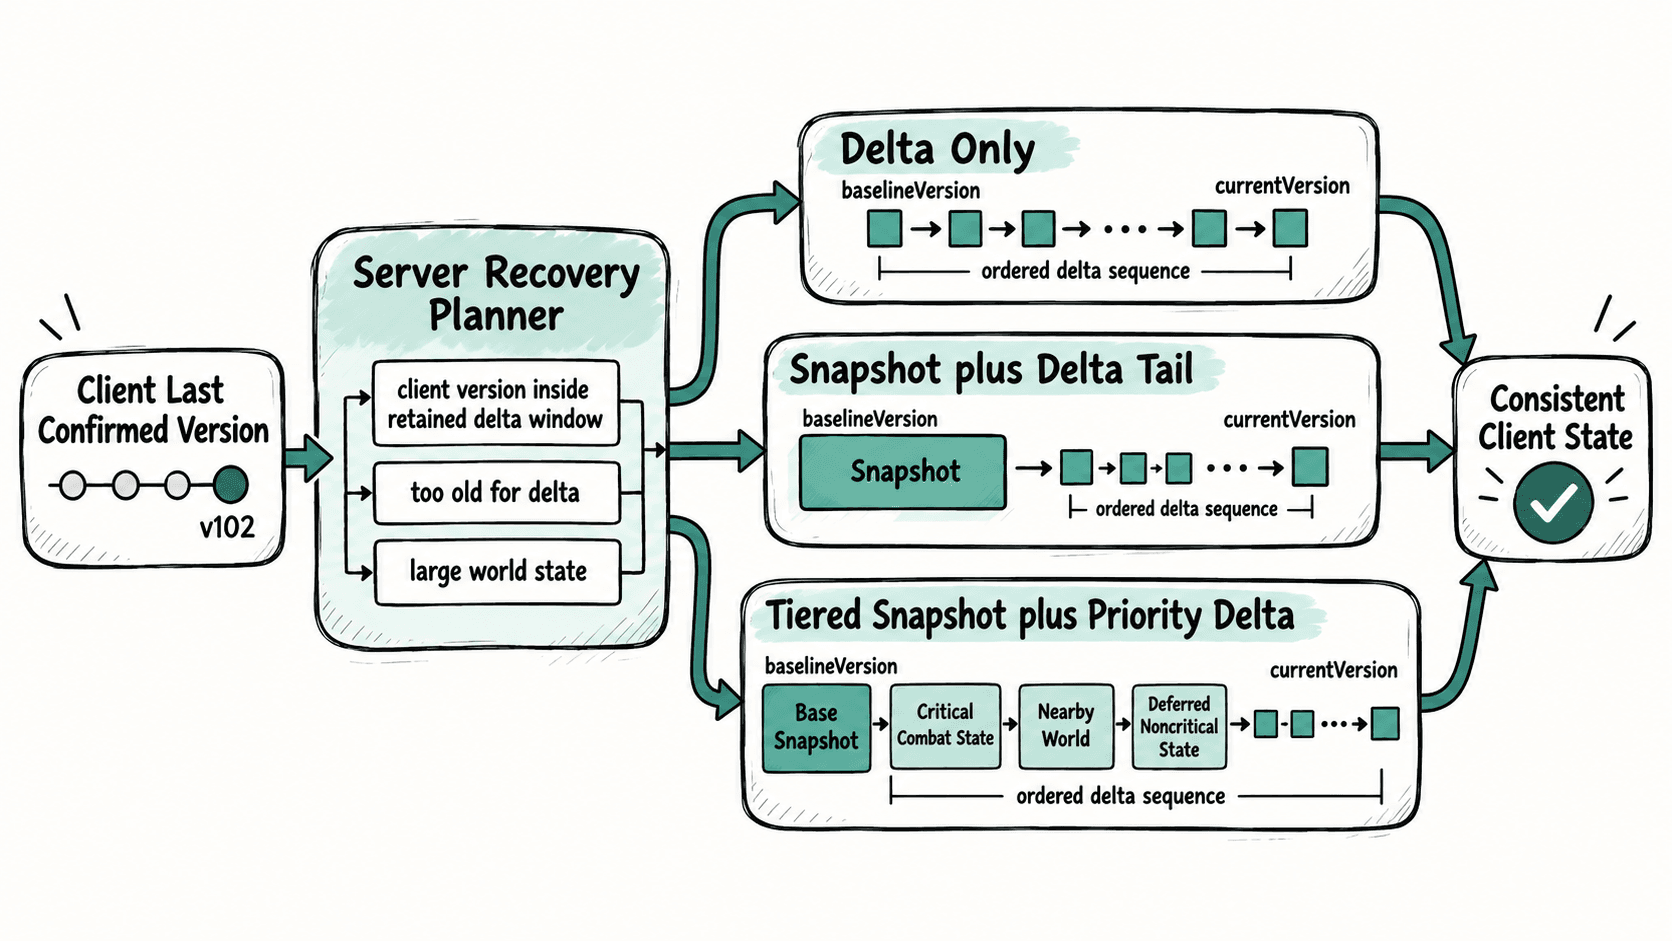
全量快照提供某个版本点上的完整权威状态,优点是恢复逻辑简单,缺点是世界越大成本越高。增量记录从一个版本到另一个版本发生的变化,适合短暂掉线,但要求服务端仍保留客户端缺失的那段历史。
分段恢复不是第三套一致性机制,而是把快照或增量按区域、实体类型或优先级拆开。玩家附近角色、战斗目标、碰撞体和关键计时器先到,远处装饰实体、排行榜或非关键缓存后到,客户端可以更早达到可玩的最低条件。
| 方案 | 适合场景 | 主要成本 | 失败边界 |
|---|---|---|---|
| 全量快照 | 客户端版本过旧、增量日志已淘汰 | 单次流量大、序列化开销高 | 快照过大导致恢复时间过长 |
| 纯增量 | 短暂掉线且版本仍在日志窗口内 | 事件条数随掉线时长增长 | 缺失任一版本会破坏连续性 |
| 分段快照 + 增量 | 大世界、需要优先恢复可玩区域 | 协议和优先级设计更复杂 | 分段依赖处理错误会出现半一致状态 |
用版本窗口决定恢复路径
服务端应给世界状态维护单调递增的版本号,并记录增量可追溯的最早版本 minDeltaVersion。客户端重连时携带自己最后确认的 clientVersion,服务端先判断它是否仍落在可补齐窗口内。
规则可以压缩成三类:若 clientVersion >= minDeltaVersion,直接发送缺失增量;若版本已过旧,先下发某个 baselineVersion 的快照,再补 baselineVersion 之后的增量;如果快照本身很大,就把快照拆成关键区与延迟区,并保证关键区内部的依赖顺序稳定。
下面的 Node.js 示例演示一个最小恢复规划器。阈值只是教学用配置,实际项目应由压测结果决定。
function chooseRecoveryPlan(state) {
  const {
    clientVersion,
    minDeltaVersion,
    snapshotBytes,
    deltaBytes,
    criticalBytes
  } = state;

  // 版本仍在日志窗口内,优先只补增量。
  if (clientVersion >= minDeltaVersion && deltaBytes <= 512 * 1024) {
    return { mode: "DELTA_ONLY", estimatedBytes: deltaBytes };
  }

  // 大快照先只发送可进入战斗所需的关键分段。
  if (snapshotBytes > 2 * 1024 * 1024) {
    return {
      mode: "TIERED_SNAPSHOT_PLUS_DELTA",
      estimatedFirstStageBytes: criticalBytes + Math.min(deltaBytes, 512 * 1024)
    };
  }

  return {
    mode: "SNAPSHOT_PLUS_DELTA",
    estimatedBytes: snapshotBytes + deltaBytes
  };
}

const shortDrop = chooseRecoveryPlan({
  clientVersion: 980,
  minDeltaVersion: 950,
  snapshotBytes: 4_000_000,
  deltaBytes: 180_000,
  criticalBytes: 420_000
});

const longDrop = chooseRecoveryPlan({
  clientVersion: 700,
  minDeltaVersion: 950,
  snapshotBytes: 1_200_000,
  deltaBytes: 90_000,
  criticalBytes: 300_000
});

console.log(JSON.stringify(shortDrop));
console.log(JSON.stringify(longDrop));
预期输出:
{"mode":"DELTA_ONLY","estimatedBytes":180000}
{"mode":"SNAPSHOT_PLUS_DELTA","estimatedBytes":1290000}
真实系统还要校验版本连续性:如果客户端声称停在 980,而服务端只能提供 982 之后的事件,就不能假装 981 不重要,应回退到可验证的快照基线。
分段恢复先保可玩性再保完整性
大世界最有效的优化通常不是“把所有数据压得更小”,而是减少第一阶段必须发送的数据。可以把恢复内容按依赖拆成三个层级:
- 关键战斗状态:玩家身份、位置、生命值、当前技能、目标、权威计时器和碰撞相关实体。
- 邻近世界状态:可见范围内的角色、掉落物、交互物和短期事件。
- 延迟状态:远端实体、统计信息、非关键缓存和可稍后刷新的展示数据。
第二、三层可以在客户端已经进入 Ready 后继续低优先级补齐,但任何会影响命中判定、位置约束或技能冷却的数据都不能延迟到战斗开始之后。
控制恢复流量的四个杠杆
先做路径选择,再做压缩。短掉线优先增量,长掉线回退快照,可以避免大量无效传输。其次给批次设置上限,防止一次恢复包挤占正常战斗流量。
然后使用按实体类型或区域分块的压缩,因为同类状态通常更容易压缩。最后保留去重能力:重复重连或同一批次重发时,客户端根据 batchId、版本范围和实体版本忽略已提交数据,避免重发变成重复应用。
验收时同时记录首次可玩字节数、总恢复字节数、恢复耗时和回退次数。只有“首阶段更小、最终状态仍一致”才算真正省流量;若为了少传数据而增加大量重试或让客户端进入半一致状态,优化反而失败。