
游戏客户端架构 / 系统课时
如何关联一次完整操作链
如何关联一次完整操作链
客户端问题往往跨越 UI、网络、业务模块与异步任务。单条日志只能看到局部,本节要建立一套可复制的关联方法:为一次操作生成稳定标识,并在会话、请求、任务和线程切换之间传播,让分散日志重新组成一条可追踪链路。
学习目标
- 区分会话、请求、任务和事件标识各自解决的问题
- 在异步线程切换时正确传播日志上下文
- 能根据关联标识从多模块日志还原一次完整操作
先定义关联标识的边界
一次“点击登录并进入大厅”可能同时经过界面事件、鉴权请求、配置拉取、资源检查和后台任务。不要强行只用一个 ID 表示所有层级,否则后续很难判断日志属于同一次会话,还是同一次请求。
常见做法是同时保留几类标识:
| 标识 | 生命周期 | 典型用途 |
|---|---|---|
sessionId |
一次登录会话 | 串联玩家从登录到退出的客户端行为 |
requestId |
一次网络请求 | 对齐客户端请求、重试和响应 |
taskId |
一个异步任务 | 追踪下载、解压、资源检查等后台工作 |
eventId |
一次用户或业务事件 | 关联“点击购买”“进入副本”等完整操作 |
关键原则不是 ID 越多越好,而是每个 ID 都有明确生命周期。通常由上层事件创建 eventId,其下的网络请求和异步任务继承它,再分别创建自己的 requestId、taskId。
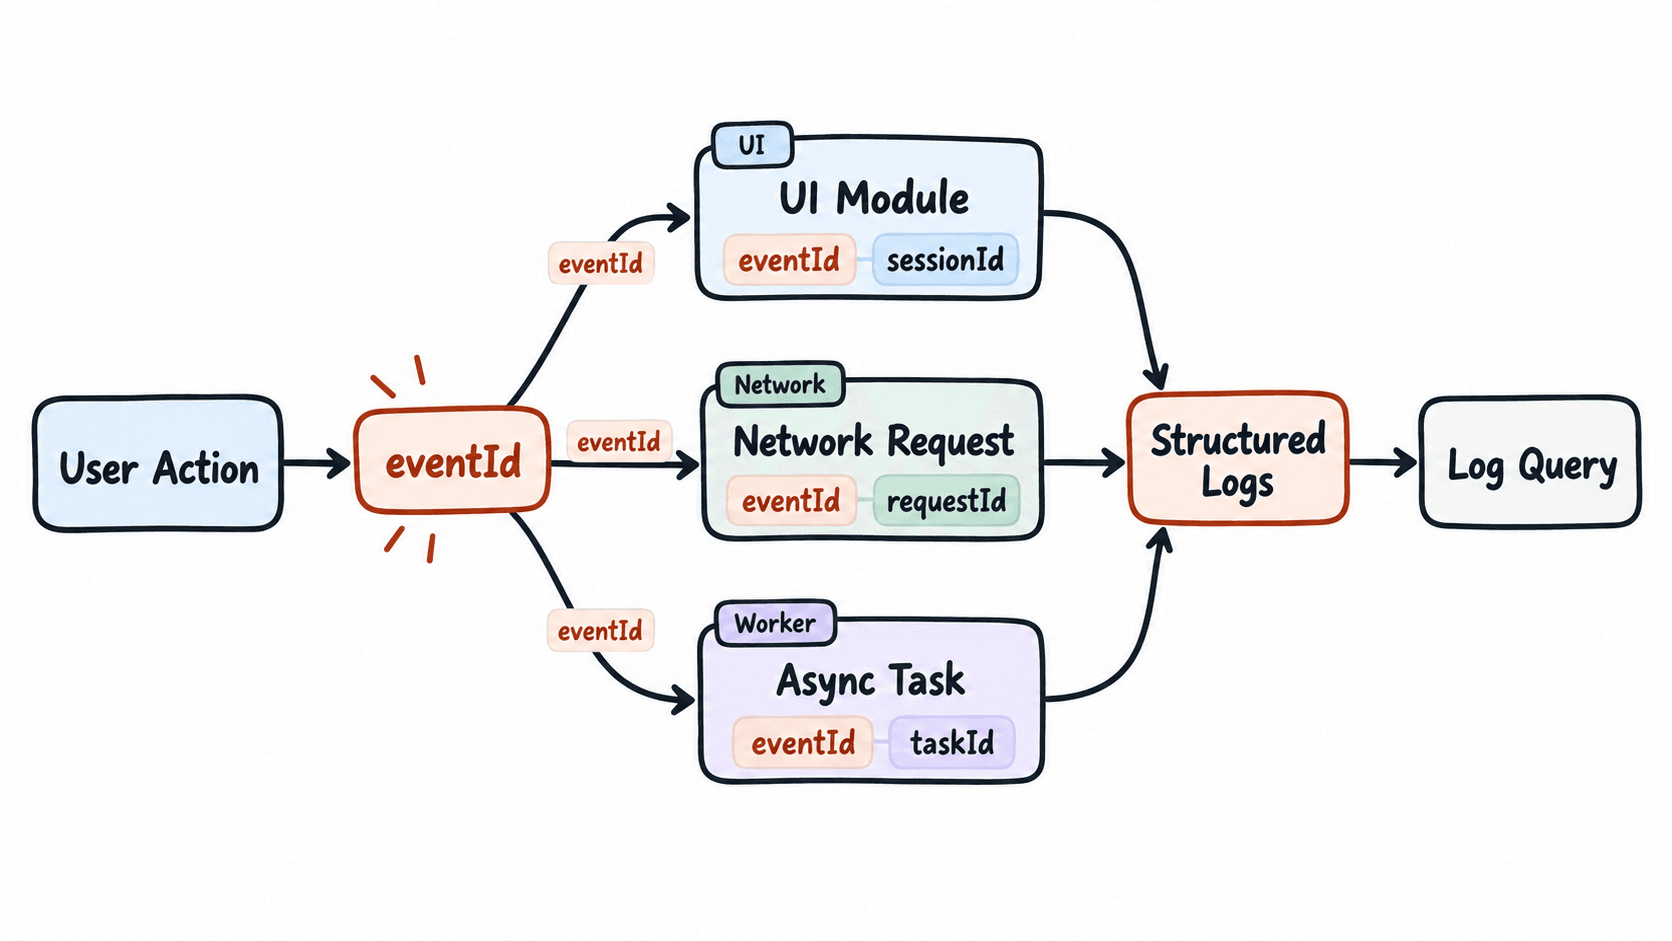
在线程切换时复制上下文
最容易丢链路的地方不是同步调用,而是线程池、异步回调和延迟任务。线程本地变量不会自动跟随任务移动到工作线程,因此提交任务前要捕获上下文,进入工作线程后恢复,结束时再清理,避免上下文污染后续任务。
下面的 Java 示例只使用 JDK,演示 eventId 如何跨线程池传播:
import java.util.Map;
import java.util.HashMap;
import java.util.concurrent.ExecutorService;
import java.util.concurrent.Executors;

public class TraceContextDemo {
    private static final ThreadLocal<Map<String, String>> CONTEXT =
            ThreadLocal.withInitial(HashMap::new);

    static void put(String key, String value) {
        CONTEXT.get().put(key, value);
    }

    static Map<String, String> snapshot() {
        return new HashMap<>(CONTEXT.get());
    }

    static Runnable wrap(Runnable task) {
        Map<String, String> captured = snapshot();
        return () -> {
            Map<String, String> previous = snapshot();
            try {
                CONTEXT.set(new HashMap<>(captured));
                task.run();
            } finally {
                CONTEXT.set(previous);
            }
        };
    }

    static void log(String message) {
        System.out.println("eventId=" + CONTEXT.get().get("eventId")
                + " | " + Thread.currentThread().getName()
                + " | " + message);
    }

    public static void main(String[] args) throws Exception {
        ExecutorService pool = Executors.newSingleThreadExecutor();
        put("eventId", "evt-1001");

        log("user clicked login");
        pool.submit(wrap(() -> log("load player profile"))).get();

        pool.shutdown();
    }
}
预期输出:
eventId=evt-1001 | main | user clicked login
eventId=evt-1001 | pool-1-thread-1 | load player profile
实际线程名可能因 JDK 或线程池实现不同而变化,但两行的 eventId 应保持一致。生产项目若使用日志框架的 MDC,也要遵循相同思路:捕获、传播、恢复、清理,而不是假设框架会自动完成跨线程传递。
把标识写进结构化日志
仅在消息正文里拼接 ID,后续检索会很痛苦。更稳妥的做法是把关联标识作为独立字段写入结构化日志,例如 eventId、requestId、module、action、result。
一次登录链路可以形成这样的记录:
{"eventId":"evt-1001","requestId":"req-2001","module":"auth","action":"login","result":"start"}
{"eventId":"evt-1001","requestId":"req-2001","module":"auth","action":"login","result":"success"}
{"eventId":"evt-1001","taskId":"task-3001","module":"profile","action":"load","result":"success"}
这是数据结构示例,不依赖具体日志框架。验证方法是在日志系统中按 eventId=evt-1001 过滤,确认同一操作涉及的 UI、网络与异步任务记录都能被检索出来,并且子步骤拥有各自的 requestId 或 taskId。
用关联链定位真实故障
排查时先从用户可见现象找到最外层 eventId,再沿时间顺序查看其下的请求和任务。若某一步失败,不要只盯最后一条错误日志,还要确认前置步骤是否已经异常。
例如“点击进入大厅后一直转圈”,可以按下面顺序定位:
- 找到点击事件对应的
eventId。 - 检查该事件下是否生成大厅配置请求的
requestId。 - 检查响应成功后是否创建资源加载
taskId。 - 若任务存在但没有完成日志,再进入对应线程或任务执行器继续排查。
- 如果某个子步骤完全没有出现,问题通常发生在它之前的状态判断或调度逻辑。
一条可用的日志链应做到:从用户动作能找到根标识,从根标识能展开子请求和子任务,从任意错误记录也能反查它属于哪次操作。这样日志才真正从“记录发生了什么”升级为“解释一次操作为什么失败”。