
游戏客户端架构 / 系统课时
主线程卡住时先抓什么
主线程卡住时先抓什么
主线程无响应时,最有价值的不是立刻重启,也不是先翻几百行日志,而是尽快保存能解释“主线程停在哪里、在等谁、谁又在占用资源”的现场。本节给出一套最小证据集,让后续分析锁竞争、同步等待和长任务时有可靠依据。
学习目标
- 知道主线程卡死现场应优先保存哪些证据
- 能从调用栈区分锁等待、任务等待、同步 I/O 与长任务
- 按固定顺序缩小“主线程在等谁”的范围
先保存主线程与全部线程栈
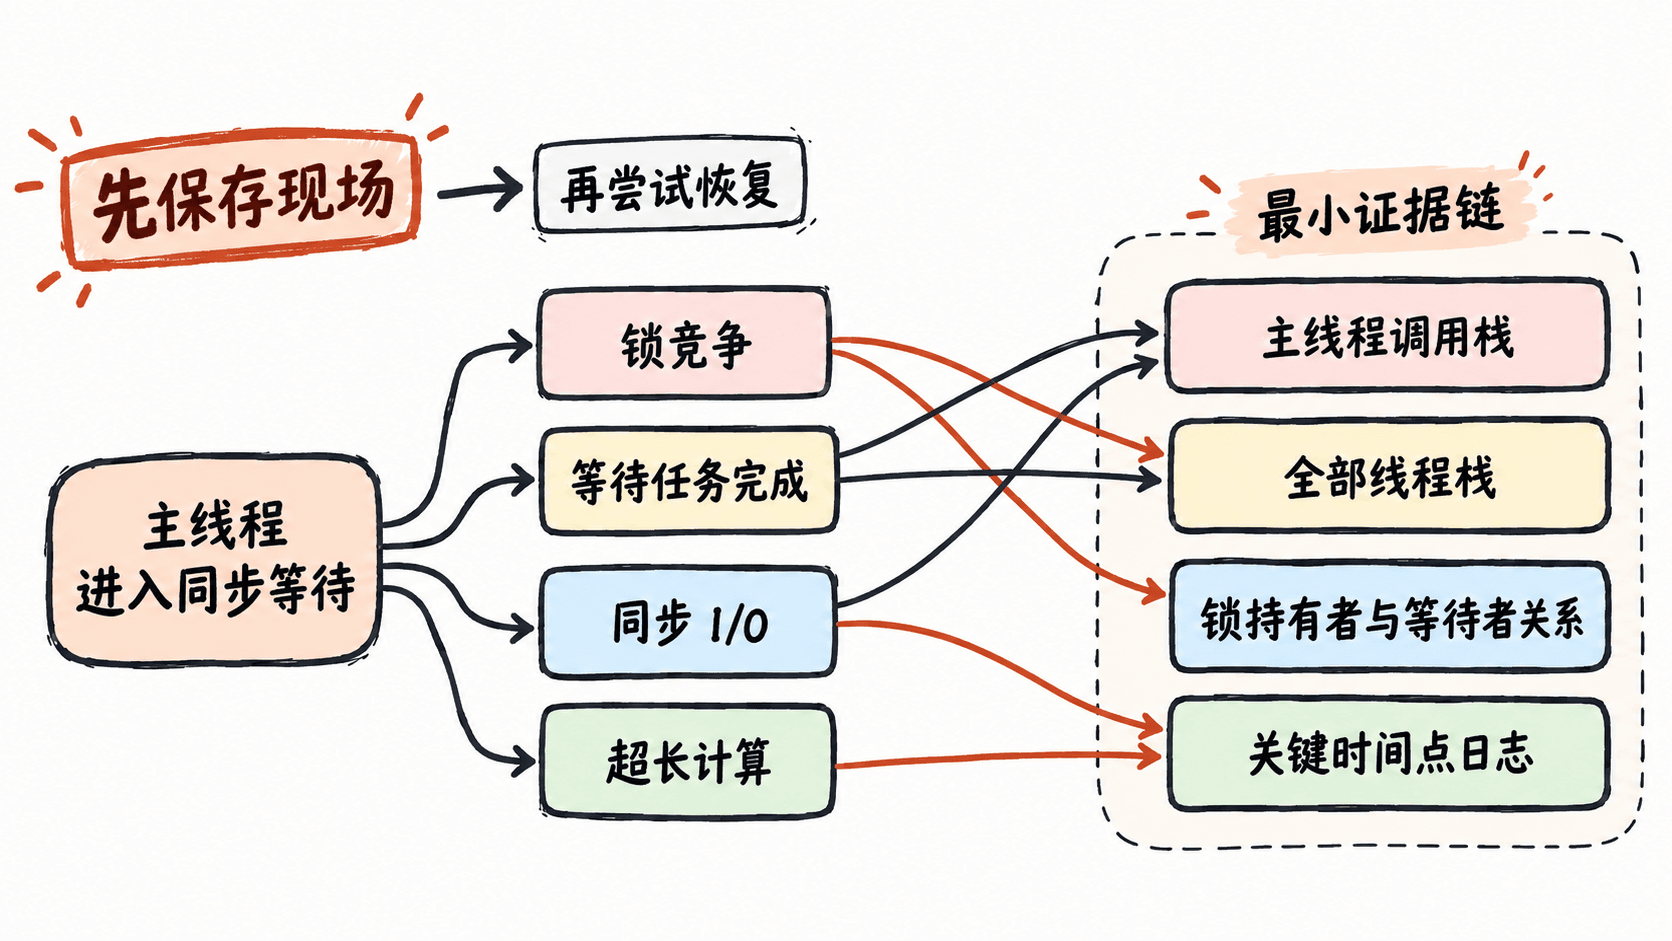
第一份证据是主线程调用栈。它直接告诉你主线程当前停在什么调用路径上:是在等待锁、等待事件、同步读取资源,还是仍在执行某个耗时函数。抓栈时应同时记录采集时间,后续才能与日志时间线对齐。
第二份证据是全部线程调用栈。只抓主线程经常只能看到“我在等”,却看不到“我在等谁”。如果主线程停在某个同步原语上,就要继续找可能持有资源的工作线程,并检查它是否又在等待其他线程。
用栈顶先判断是哪一类停顿
拿到主线程栈后,先看最靠近栈顶的阻塞点,再向上追调用来源。常见模式可以按行为分类,而不是死记某个引擎的函数名。
| 栈上行为 | 可能问题 | 下一步证据 |
|---|---|---|
| 等待互斥锁或读写锁 | 锁竞争、死锁 | 找锁持有线程及其调用栈 |
| 等待事件、任务或 Future | 同步等待异步结果 | 找生产该结果的线程或任务 |
| 文件、网络等同步 I/O | I/O 阻塞或资源异常 | 对齐 I/O 日志与耗时 |
| 持续停在业务函数 | 超长计算或死循环 | 连续抓栈确认位置是否变化 |
一次栈只是“某个瞬间”。如果条件允许,间隔短时间连续抓取两到三次:若主线程栈顶始终完全一致,更像稳定等待或死循环;若位置缓慢变化,则更可能是超长任务而不是严格意义上的死锁。
用可重复示例理解等待关系
下面的 Python 程序让工作线程先持有一把锁,主线程随后尝试获取同一把锁。faulthandler 会在主线程等待期间打印所有 Python 线程的调用栈,从而直观看到“主线程在等待、工作线程在持有资源”的证据组合。
import faulthandler
import threading
import time

lock = threading.Lock()
worker_has_lock = threading.Event()

def worker() -> None:
    with lock:
        worker_has_lock.set()
        # 模拟工作线程长时间占有主线程需要的资源
        time.sleep(3)

thread = threading.Thread(target=worker, name="asset-loader")
thread.start()
worker_has_lock.wait()

print("main: waiting for lock", flush=True)
faulthandler.dump_traceback_later(0.5, repeat=False)

with lock:
    pass

faulthandler.cancel_dump_traceback_later()
thread.join()
print("main: recovered")
预期输出的线程 ID、路径和行号会因环境不同而变化,形态如下:
main: waiting for lock
Timeout (0:00:00.500000)!
Thread <THREAD_ID> (most recent call first):
  File "<PATH>", line <LINE> in worker
Thread <THREAD_ID> (most recent call first):
  File "<PATH>", line <LINE> in <module>
main: recovered
这个示例里,主线程的“卡住”不是因为它本身执行了复杂逻辑,而是它需要的锁暂时被工作线程占用。真实游戏客户端里也应按同样思路,把主线程等待点与资源持有者对应起来。
补齐最小证据集再开始猜根因
线程栈之外,再保存与同一时间点相关的关键日志、CPU 使用率和是否持续出帧等状态即可。第一轮不要把现场采集扩展成大而全的性能报告,目标只是回答四个问题:主线程在哪、是否在等、等谁、对方在做什么。
当主线程卡住时,先抓主线程栈只是入口;真正能把问题闭环的是“主线程等待点 + 其他线程状态 + 同一时间线日志”。证据完整后,再决定是修锁顺序、移除同步等待、拆分长任务,还是把同步 I/O 移出主线程。