
游戏客户端架构 / 系统课时
多症状同时出现先查什么
多症状同时出现先查什么
客户端同时出现卡顿、报错、请求失败时,最容易犯的错误是看到哪个日志最刺眼就先追哪个。更稳定的做法是先确定影响面,再锁定最早异常时间点,最后沿共同依赖向下排查,从多个表象中找到更可能的上游原因。
学习目标
- 按影响面、发生时间和依赖关系确定排查优先级
- 区分根因、连锁故障和无关噪声
- 用统一记录方式快速收敛多个并发症状
先判断是不是同一个故障
多个症状同时出现,不代表它们一定属于同一个问题。第一步不是分别阅读几十份日志,而是先比较三个信息:发生时间是否接近、影响对象是否重合、是否依赖同一组件。
例如,玩家在 20:15 左右同时遇到帧率下降、资源加载失败和接口超时,而三个现象都集中在进入同一场景后,那么它们很可能存在共同触发点。反之,如果帧率下降持续了半小时,而接口失败只发生在一次登录请求中,就不应该强行串成一条故障链。
按影响面决定先查哪里
优先级首先看影响面,而不是日志级别。一个只影响单个资源的 ERROR,通常没有“所有请求同时超时”重要。
可以按以下顺序快速判断:
- 是否影响大量玩家、整个场景或核心流程。
- 是否有多个模块在相近时间同时异常。
- 是否存在共享依赖,例如主线程、网络连接、资源系统、磁盘或内存。
- 再检查单个模块内部的局部错误。
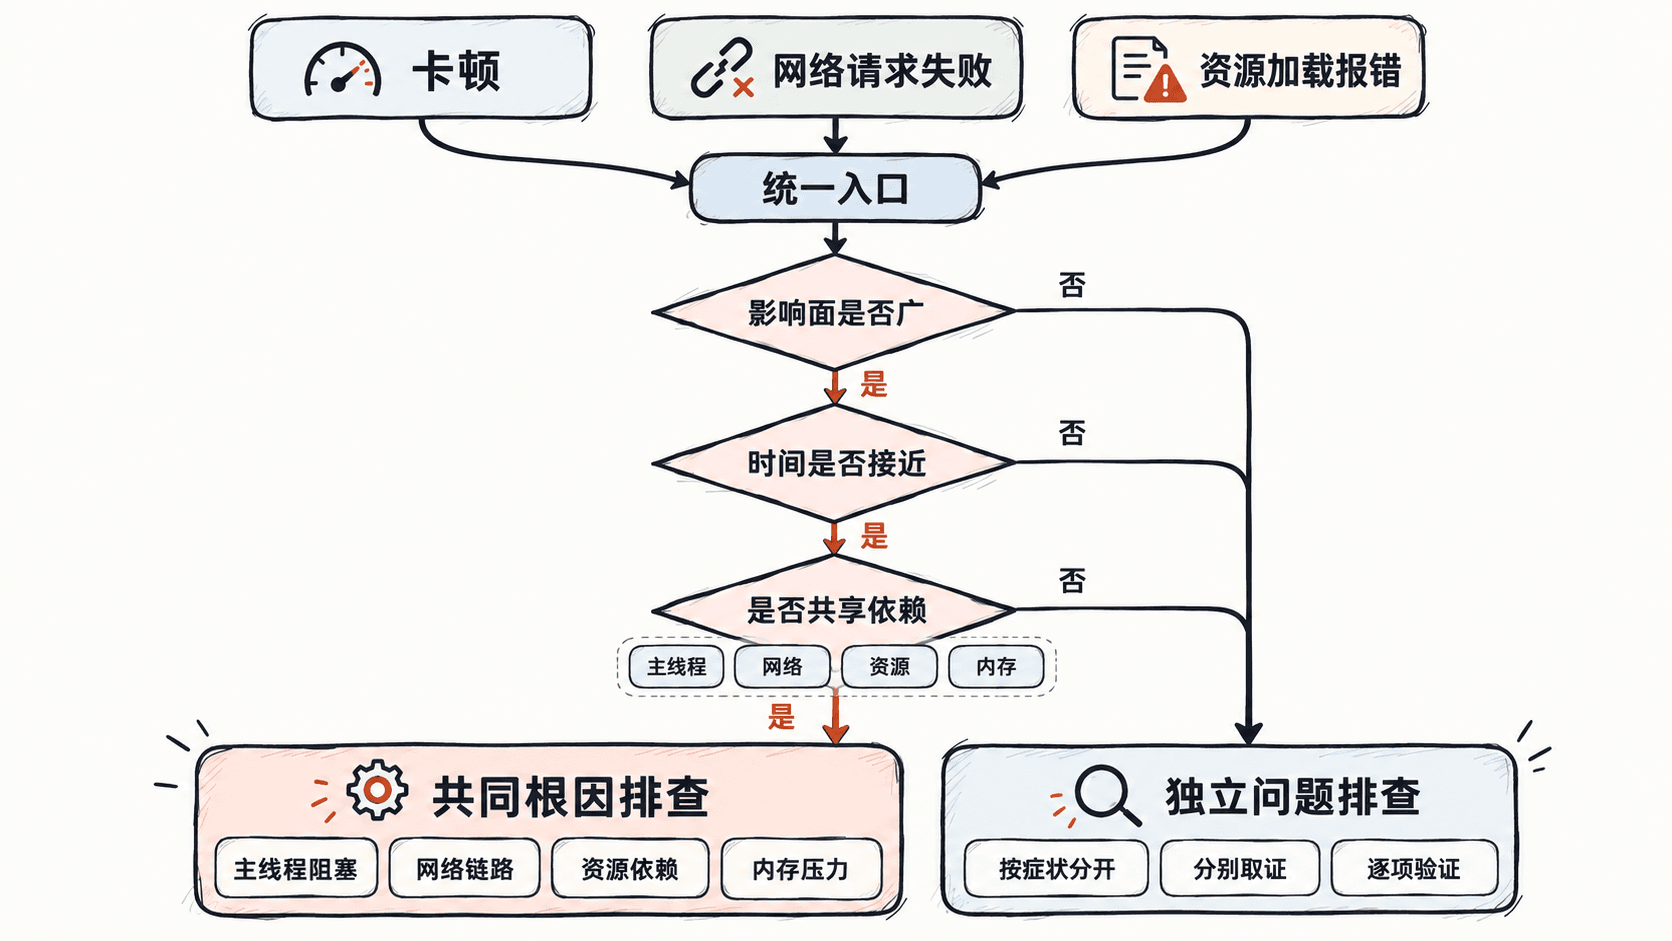
如果网络请求、资源加载和 UI 更新同时停顿,应该优先寻找它们共同依赖的执行环境。例如主线程长时间阻塞可能造成 UI 卡顿,同时推迟资源回调和网络结果处理。这时三个症状的严重程度不同,但根因可能只有一个。
找最早发生的异常
确定症状可能相关后,第二个排序依据是时间。后出现的错误很可能只是前一个故障的结果,因此不要从最后一条错误日志逆向猜测全部原因。
下面的可运行示例把几个症状按时间排序,帮助确认哪一个异常最早出现:
from datetime import datetime

events = [
    ("20:15:03.420", "network", "request timeout"),
    ("20:15:01.180", "main-thread", "frame blocked 950 ms"),
    ("20:15:02.060", "resource", "bundle load delayed"),
]

# 先按统一时间格式排序,避免被日志来源的输出顺序误导。
events.sort(key=lambda item: datetime.strptime(item[0], "%H:%M:%S.%f"))

for timestamp, source, message in events:
    print(f"{timestamp} | {source:11} | {message}")
预期输出:
20:15:01.180 | main-thread | frame blocked 950 ms
20:15:02.060 | resource    | bundle load delayed
20:15:03.420 | network     | request timeout
这个结果不能单独证明“主线程阻塞就是根因”,但它给出了更合理的调查起点:先检查 20:15:01 前后的主线程任务,再验证资源延迟和请求超时是否是后续结果。
从共同依赖验证根因
找到最早异常后,要继续做因果验证,而不是停留在时间相关性上。一个可靠的根因通常能够同时解释多个现象,并且在修复或规避它之后,下游症状也会消失。
例如怀疑一次同步资源解压阻塞主线程,可以继续检查当时的资源任务耗时、主线程长帧以及网络回调是否都积压在同一时间窗。若关闭该资源加载路径后长帧、资源延迟和请求表现同时恢复,证据链才真正闭合。
面对多症状问题,可以把顺序固定为:先看影响面,再找最早异常,再查共同依赖,最后才深入单个模块。这样能够减少被次生错误带偏的概率,也更容易把一次复杂故障收敛成可验证的根因假设。