
游戏客户端架构 / 系统课时
超时和断线怎么留证据
超时和断线怎么留证据
网络故障最难排的往往不是“失败了”,而是失败发生时没有留下足够上下文。本节把一次请求拆成可追踪的证据链:请求标识、目标、耗时、重试、响应与断线阶段都进入同一组结构化日志,便于区分服务端慢、链路异常和客户端自身超时。
学习目标
- 设计能串起一次请求全过程的网络诊断字段
- 根据时间点和状态判断超时、断线更可能发生在哪一侧
- 用结构化日志复现一条可供服务端和网络侧对照的证据链
先把一次请求变成可追踪事件
只记录“请求失败”几乎没有排障价值。至少要为每次请求生成稳定的 requestId,并在开始、重试、收到响应、失败或取消时复用它。目标地址建议记录主机、端口和接口路径,敏感查询参数、令牌和用户隐私不要原样落盘。
一条可用的最小证据通常包含:请求标识、开始时间、目标、当前网络类型、尝试次数、每次耗时、最终状态、HTTP 状态码或传输层错误、客户端超时阈值。若协议有会话 ID、网关节点或服务端 trace ID,也应在成功拿到后补进同一条链路。
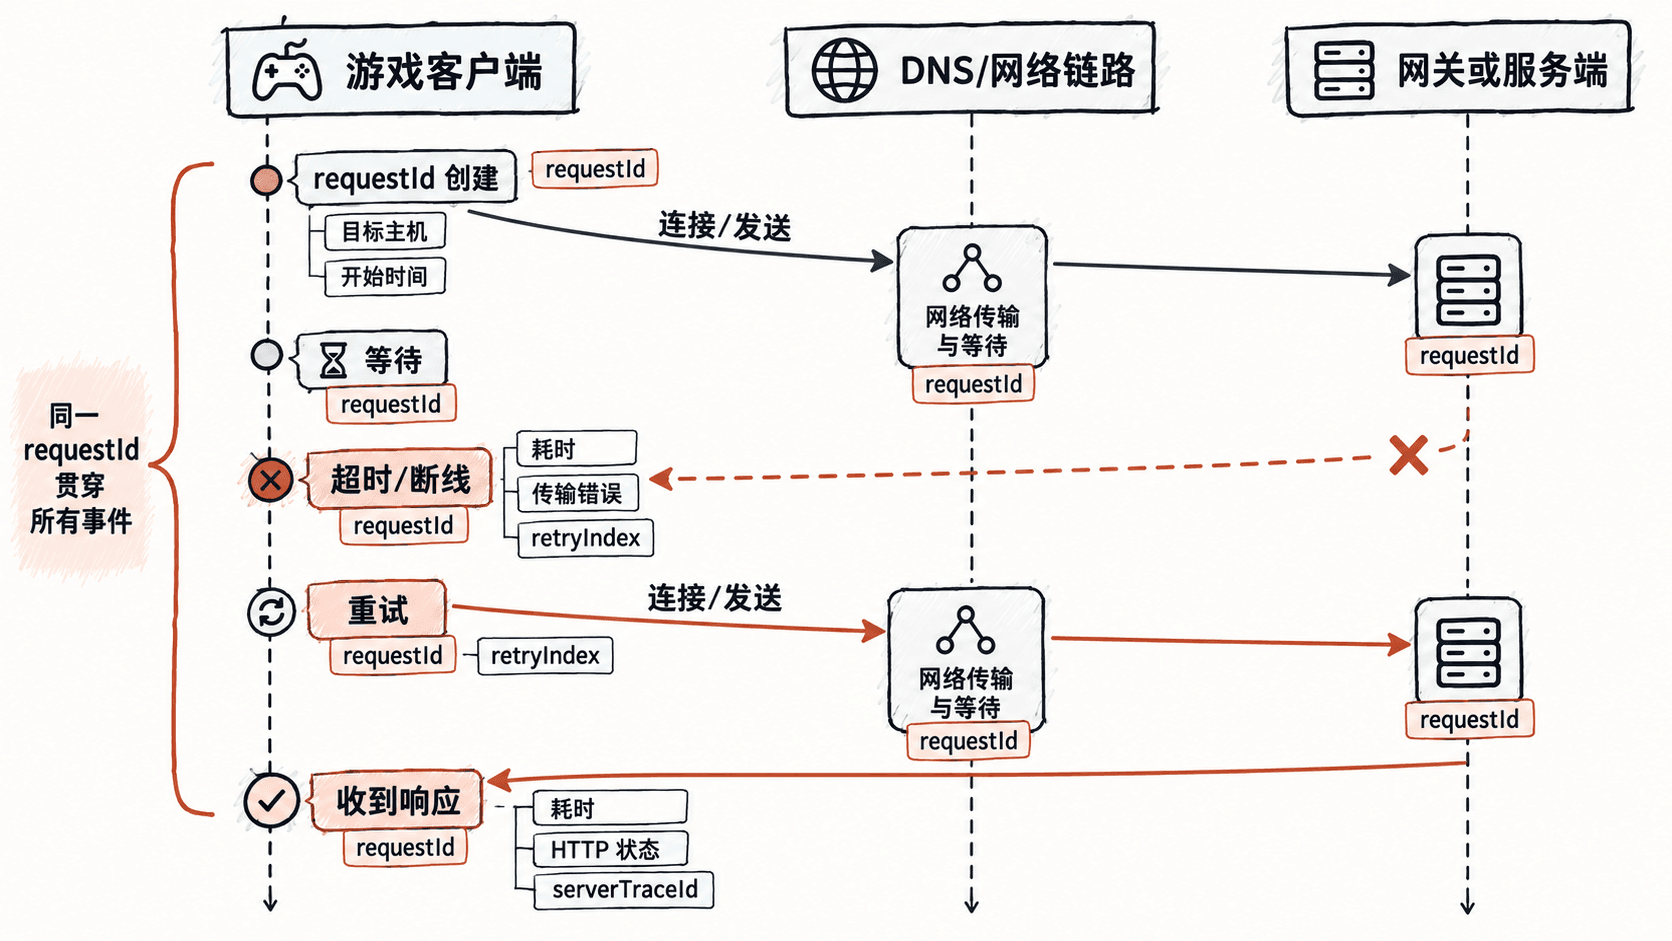
下面的示例只演示“如何留下证据”,不负责真正发起网络请求,因此可以独立运行并得到稳定输出。
import json
from datetime import datetime, timezone

def utc_now():
    return datetime.now(timezone.utc).isoformat(timespec="milliseconds")

def record_request_result(request_id, host, path, timeout_ms,
                          retry_index, elapsed_ms, status,
                          http_status=None, error=None):
    event = {
        "time": utc_now(),
        "requestId": request_id,
        "target": f"{host}{path}",
        "timeoutMs": timeout_ms,
        "retryIndex": retry_index,
        "elapsedMs": elapsed_ms,
        "status": status,
        "httpStatus": http_status,
        "error": error,
    }
    print(json.dumps(event, ensure_ascii=False, separators=(",", ":")))

if __name__ == "__main__":
    record_request_result(
        request_id="req-7f21",
        host="api.game.example",
        path="/match/state",
        timeout_ms=3000,
        retry_index=1,
        elapsed_ms=3004,
        status="timeout",
        error="client_timeout",
    )
预期输出中的时间为动态值,实际内容可能不同:
{"time":"<TIME>","requestId":"req-7f21","target":"api.game.example/match/state","timeoutMs":3000,"retryIndex":1,"elapsedMs":3004,"status":"timeout","httpStatus":null,"error":"client_timeout"}用时间线区分“谁慢”和“谁断”
判断根因时,不要只看最终错误名,而要看关键时间点的先后关系。如果客户端在到达自身超时阈值后主动取消,而服务端随后才返回成功,说明更像是服务端处理慢或超时阈值过短;如果连接在等待响应期间被重置,且同一时段大量请求同时失败,更像链路、网关或服务端连接异常。
可按这个顺序判断:
- 先确认客户端是否真正发出了请求,以及失败发生在 DNS、建连、发送、等待响应还是读取响应阶段。
- 再对比
elapsedMs与客户端超时阈值。如果两者高度接近,优先确认是否由客户端超时策略主动终止。 - 查看是否收到 HTTP 状态码。能收到
5xx,通常说明请求已经到达服务端;完全没有 HTTP 状态码,则要继续检查传输层错误。 - 用
requestId、服务端 trace ID 和时间范围去对照服务端日志,确认服务端是否收到请求、何时开始处理、何时返回。 - 最后再看重试是否把一次故障放大,例如第一次超时后立即并发重试,导致服务端压力进一步升高。
断线要补充连接级证据
长连接断线除了请求字段,还要记录连接生命周期。至少保留连接建立时间、最近一次成功收发时间、心跳序号、最近一次心跳往返耗时、关闭来源、底层错误码和是否发生网络切换。这样才能区分“服务器主动踢下线”“心跳长时间无响应”“客户端切到后台后连接被系统回收”等不同情况。
对于 WebSocket、TCP 或自定义长连接,建议把“请求级事件”和“连接级事件”分开记录,但二者都关联到 connectionId。一次请求失败时,若同一 connectionId 在前一秒刚出现断链,就不应该继续把它当成普通接口慢查询处理。
交付给后端时保留原始顺序
排障包不要只截一条错误日志。应按原始时间顺序导出故障前后的一小段窗口,例如故障前 10 秒到故障后 5 秒,并保留 requestId、connectionId 和重试序号。若日志量较大,可以只筛相关标识,但不要重新排序。
真正有价值的证据应能回答三个问题:客户端何时发起、在哪个阶段停止、对端是否观察到同一次请求。只要这三点能通过标识和时间线互相对上,超时和断线通常就能从“猜原因”变成可验证的问题。