
游戏客户端架构 / 系统课时
如何写一份可交接的故障记录
如何写一份可交接的故障记录
一次故障排查真正结束,不是开发者口头说“已经修了”,而是其他人能根据记录理解发生了什么、如何复现、为什么出错、改了什么,以及怎样确认问题没有再次出现。本课把零散聊天和日志整理成可复用的问题记录。
学习目标
- 按固定逻辑整理现象、环境、证据、复现、根因、修复与验证结果
- 区分事实、推测和结论,避免记录变成无法复查的聊天摘要
- 判断一份记录是否已经达到开发、测试和后续维护人员可接手的程度
一份记录首先要回答什么
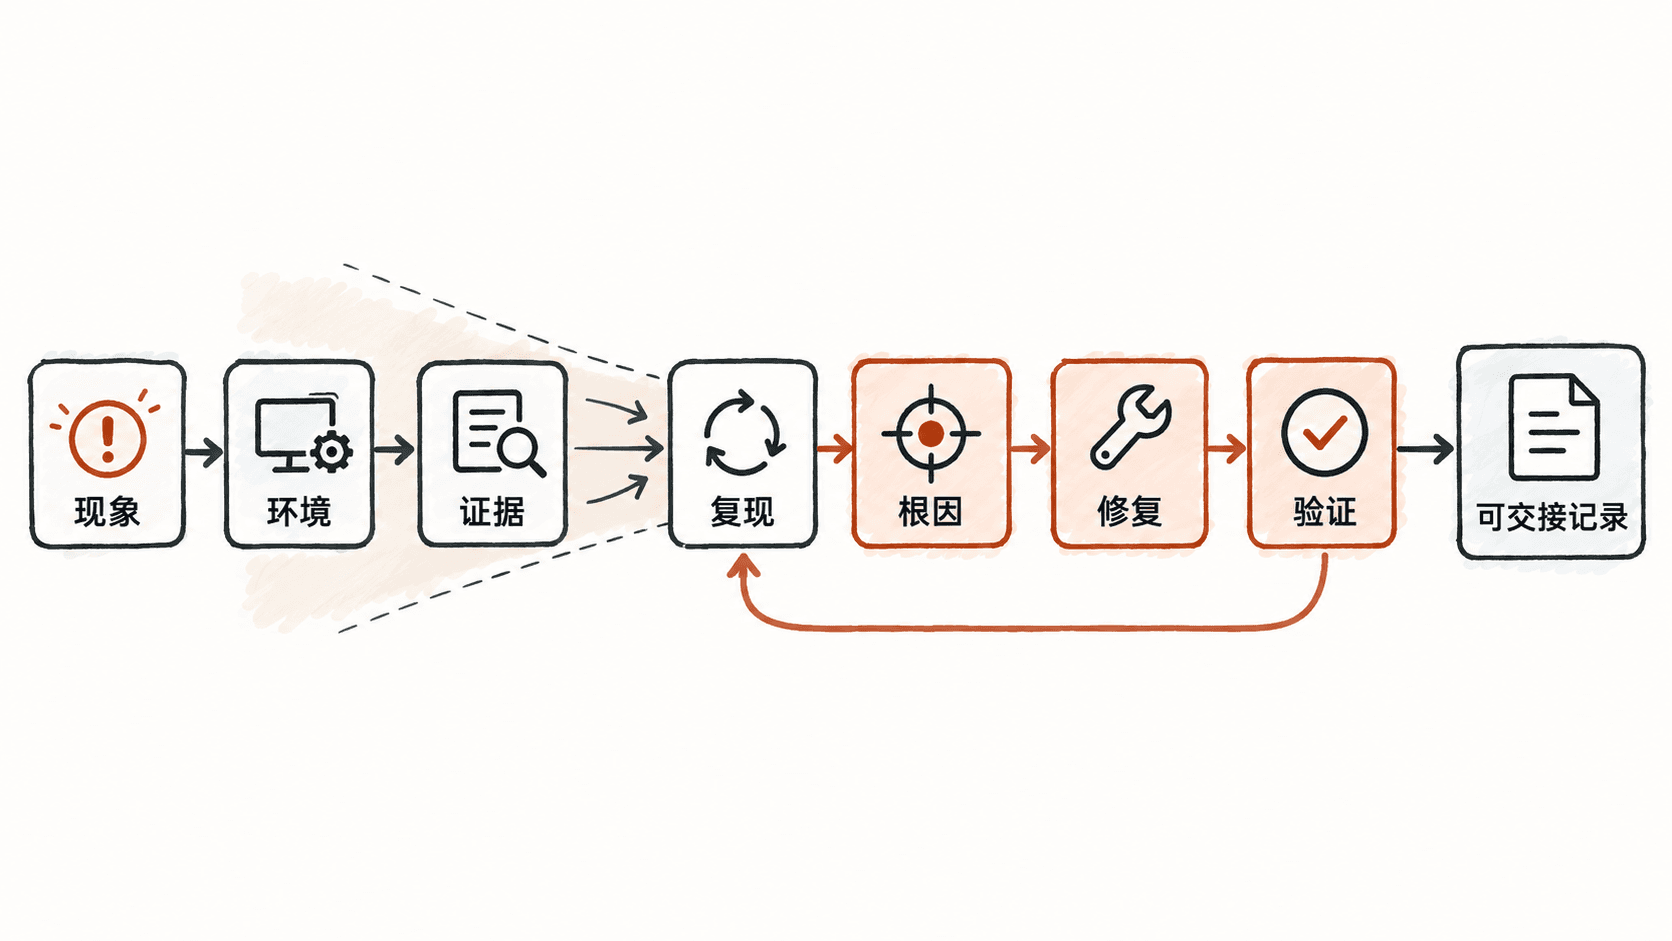
可交接记录的核心不是“写得详细”,而是让接手者不用重新问一遍关键问题。至少要回答七件事:用户看到了什么、发生在哪个环境、有哪些客观证据、怎样稳定复现、最终根因是什么、采取了什么修复,以及修复后如何验证。
其中最容易混淆的是“现象”和“根因”。例如“进入战斗后闪退”是现象,“资源加载线程访问了已经释放的对象”才是根因。排查早期可以记录怀疑方向,但必须明确标成推测,不能把未经验证的猜测写成最终结论。
按排查过程组织信息
记录最好遵循排查实际发生的顺序。先写用户可观察到的现象,再固定运行环境,然后保存日志、崩溃栈、网络响应、性能采样等证据。只有证据能够支持某个判断时,才进入根因部分。
环境信息不要只写“安卓机”或“正式服”。客户端问题往往与版本、设备、系统、资源包和网络条件有关。最低限度应记录客户端版本、构建号、系统版本、设备型号、服务器环境,以及问题首次发现时间。动态值可以保留当时的真实记录,不要为了整洁而改写。
复现步骤要让没有参与排查的人能够重复操作。每一步只描述一个可执行动作,同时写清复现概率,例如“10 次出现 8 次”通常比“经常出现”更有价值。如果只能在特定账号、地图、资源版本或网络状态下出现,也必须作为前置条件记录。
用结构化模板减少遗漏
团队可以把故障记录保存到缺陷系统、工单系统或仓库中的 Markdown 文档。下面是片段示例,它不是程序配置,而是一份便于检查字段是否齐全的结构化记录模板。
issue:
  symptom: "进入战斗场景后客户端闪退"
  first_seen: "<TIME>"
  environment:
    client_version: "<VERSION>"
    build: "<BUILD>"
    device: "<DEVICE>"
    os: "<OS_VERSION>"
    server: "<ENV>"
  evidence:
    crash_log: "<PATH_OR_LINK>"
    related_request: "<REQUEST_ID>"
  reproduce:
    precondition: "使用指定测试账号进入目标地图"
    steps: "大厅 -> 匹配 -> 加载完成 -> 进入战斗"
    rate: "8/10"
  root_cause: "<CONFIRMED_CAUSE>"
  fix: "<CHANGE_DESCRIPTION>"
  verification: "<TEST_RESULT>"
使用这类模板时,真正的验证方法很简单:把记录交给未参与排查的人,只提供记录本身,看他能否找到证据、复现问题并理解修复范围。任何必须依靠口头补充才能完成的部分,都说明记录仍有缺口。
根因和修复要建立证据关系
根因部分应该说明“为什么确认是它”,而不只是写一个技术名词。例如某次崩溃栈指向资源回调,而代码检查又发现回调可能晚于对象销毁,就应记录这两条证据如何对应。这样以后即使修复代码再次被修改,维护者仍能判断风险是否重新出现。
修复记录则要说明改变了什么行为,以及明确没有改变什么范围。如果通过增加生命周期检查避免访问已释放对象,就不要笼统写成“优化稳定性”。描述越具体,测试越容易设计回归范围。
验证结果必须能够复查
“测试通过”信息量太低。验证至少要说明使用什么版本、在哪些环境测试、原复现步骤是否已不再触发问题,以及是否检查了修复可能影响的相邻场景。若原问题存在概率性,还应记录验证次数,例如修复前 8/10 复现,修复后连续 50 次未复现。
一份记录达到可交接状态时,接手者应能回答三个问题:怎样证明当时确实发生过故障,怎样证明根因不是猜测,以及怎样证明修复覆盖了原问题。如果这三点都能从记录本身得到答案,这份故障记录才真正完成了排障闭环。