
游戏客户端架构 / 系统课时
怎样处理无法稳定复现的崩溃
怎样处理无法稳定复现的崩溃
无法稳定复现并不等于无法定位。真正有效的做法,是把每次崩溃变成结构化证据:固定版本与符号、按崩溃签名聚类,再用设备、场景、操作路径和最近事件做关联分析,逐步缩小疑似根因范围,最后通过定向埋点和灰度修复验证。
学习目标
- 能为偶发崩溃定义最小证据集合,避免只收集一段调用栈
- 能按崩溃签名聚类,并用版本、设备、场景和路径字段寻找关联
- 能设计低风险的定向日志与修复验证流程,逐步把偶发问题变成可证实问题
先保证每份崩溃报告可以对上版本
偶发崩溃最怕“日志有了,但不知道来自哪一份代码”。每条报告至少要带应用版本、构建号或提交标识、平台与系统版本,并确保对应符号文件或映射文件可追溯。没有这一步,调用栈里的地址和行号可能根本不属于当前源码。
同一个异常名称也不一定是同一个问题。聚类时应优先使用“异常类型 + 归一化后的关键栈帧”作为崩溃签名,而不是只按错误消息分组。动态地址、对象 ID、时间戳等字段不应直接参与签名,否则同一根因会被拆成大量小组。
给崩溃现场补齐最小上下文
对于无法稳定复现的问题,单条栈信息通常不够。建议围绕“谁、在哪、做了什么、刚刚发生了什么”补充上下文,但只采集定位所需字段,避免记录账号明文、聊天内容或其他不必要的敏感信息。
下面的完整 C# 示例构造一条最小崩溃上下文,并序列化成 JSON。真实客户端可以把相同字段交给现有崩溃上报 SDK 的附加属性或自有日志系统。
using System;
using System.Text.Json;

public record CrashContext(
    string AppVersion,
    string Build,
    string DeviceModel,
    string OsVersion,
    string Scene,
    string ActionPath,
    string LastEvent
);

static class Program
{
    static void Main()
    {
        var context = new CrashContext(
            AppVersion: "2.4.1",
            Build: "24107",
            DeviceModel: "ExamplePhone-X",
            OsVersion: "ExampleOS 15",
            Scene: "Battle_Desert",
            ActionPath: "MatchStart>Spawn>OpenInventory",
            LastEvent: "InventorySyncCompleted"
        );

        string json = JsonSerializer.Serialize(
            context,
            new JsonSerializerOptions { WriteIndented = true }
        );

        Console.WriteLine(json);
    }
}
预期输出:
{
  "AppVersion": "2.4.1",
  "Build": "24107",
  "DeviceModel": "ExamplePhone-X",
  "OsVersion": "ExampleOS 15",
  "Scene": "Battle_Desert",
  "ActionPath": "MatchStart>Spawn>OpenInventory",
  "LastEvent": "InventorySyncCompleted"
}
这些字段不是越多越好。只要能回答版本、设备、场景、触发路径和最近事件,就已经足够支持第一轮关联分析。
用频次和关联字段缩小范围
先按崩溃签名聚类,再比较不同维度的发生率。例如某签名在整体只占很小比例,却高度集中于单一构建号或某类设备,就应优先检查该维度对应的差异。若它只在特定场景和操作路径出现,则优先回看该路径上的资源加载、对象生命周期和异步回调。
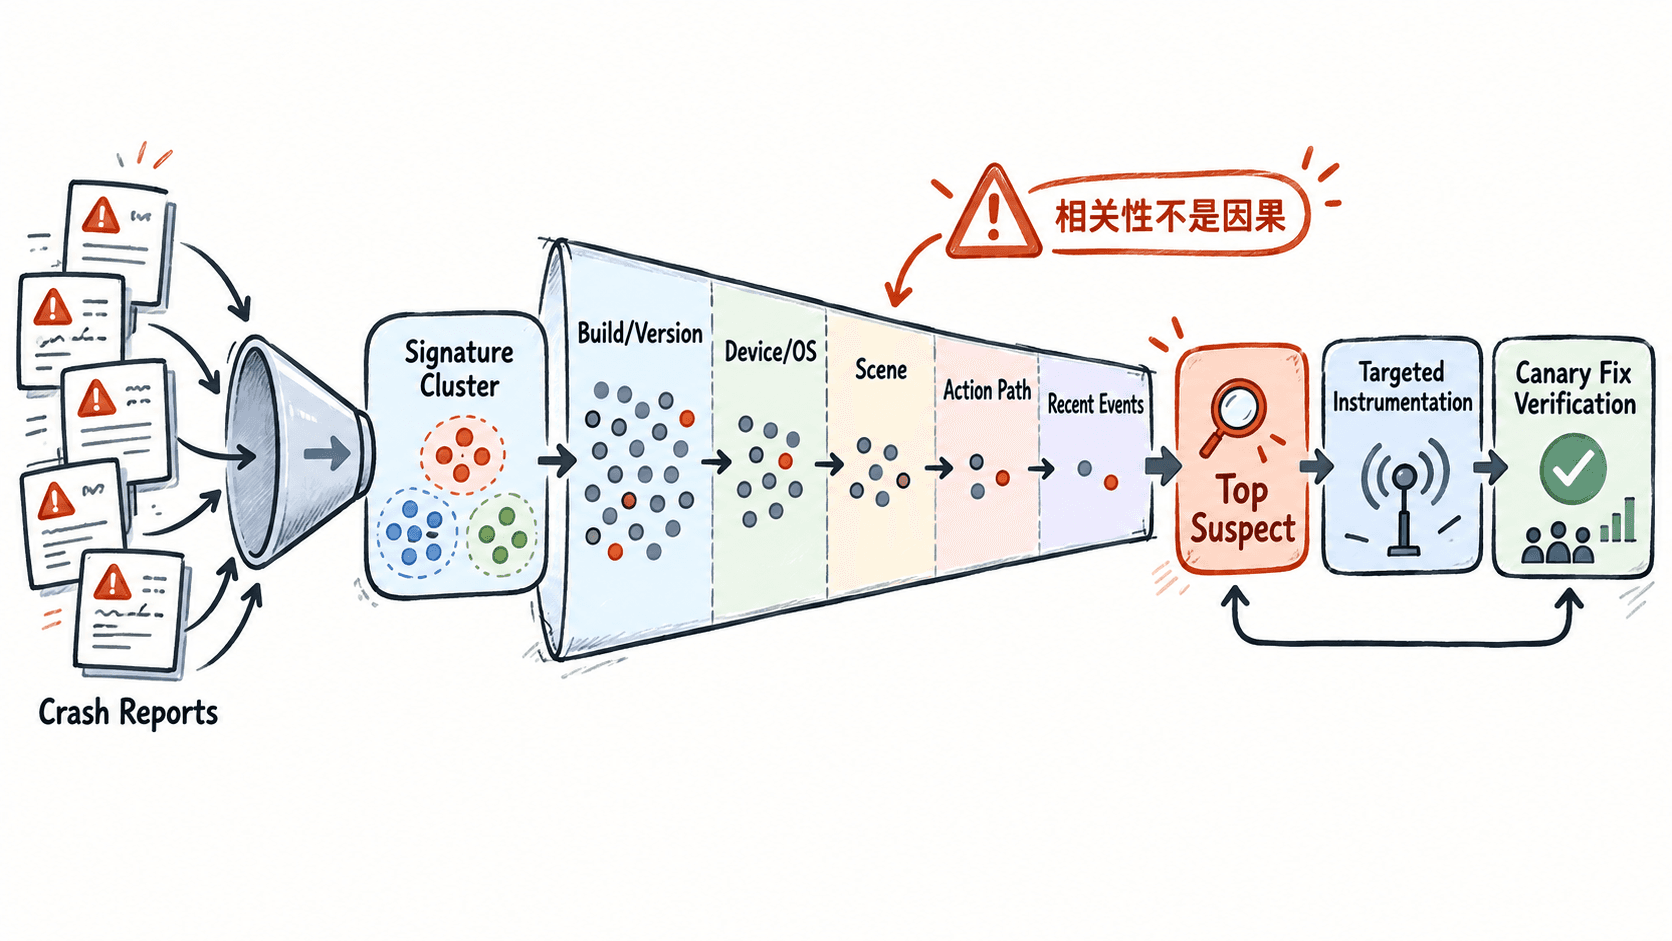
关联分析只负责“提高怀疑优先级”,不能单独证明因果。例如 80% 的崩溃来自某型号设备,可能是该设备占活跃用户的 80%。更可靠的比较是看相对发生率:同一版本、同一场景下,该型号的崩溃率是否显著高于其他设备。
用事件轨迹把“偶发”变成可追踪
当调用栈无法解释触发条件时,可以记录一个有限长度的最近事件环形缓冲区,例如场景进入、资源加载完成、网络响应、对象创建与回收、关键 UI 操作。崩溃时只上报最近若干条事件,而不是无限追加日志。
事件名称要稳定、粒度一致,并尽量使用枚举或固定字符串。重点是恢复“崩溃前发生顺序”,而不是记录所有函数调用。若多个样本都出现同样的最后三四个事件,通常就能设计更有针对性的复现路径。
修复后要验证签名是否真正下降
偶发崩溃最容易出现“改了一个可疑点,感觉应该好了”。更可靠的验收方式是保留原崩溃签名,在小范围版本中观察该签名的发生率是否下降,同时确认没有出现新的相邻签名。
如果问题仍然存在,就根据新样本继续细化字段;如果旧签名消失但出现了不同异常,要检查是否只是把故障从一个位置推到了另一个位置。只有当同一版本基线下,目标签名在足够样本中持续下降,且没有引入新的高频崩溃,修复才算得到证据支持。
处理不可稳定复现的崩溃,本质上不是等待“运气复现”,而是持续提高每次崩溃样本的信息密度。版本可追溯、签名可聚类、上下文可比较、事件可还原、修复可量化验证,这五步可以把最难追的偶发问题逐渐收敛成可操作的根因。