
游戏客户端架构 / 系统课时
客户端故障先分哪几类
客户端故障先分哪几类
遇到“游戏出问题了”时,第一步不是立刻翻日志,而是先判断故障属于哪一类。分类能快速缩小证据范围,避免把网络问题当成性能问题,也能决定后续应该先看崩溃栈、主线程、渲染状态、业务日志还是请求链路。
学习目标
- 能区分崩溃、卡死、黑屏、功能异常、性能异常和网络异常
- 能根据外部现象选择第一批要收集的证据
- 能识别看起来相似、但排查方向完全不同的故障
先按“用户看见了什么”分类
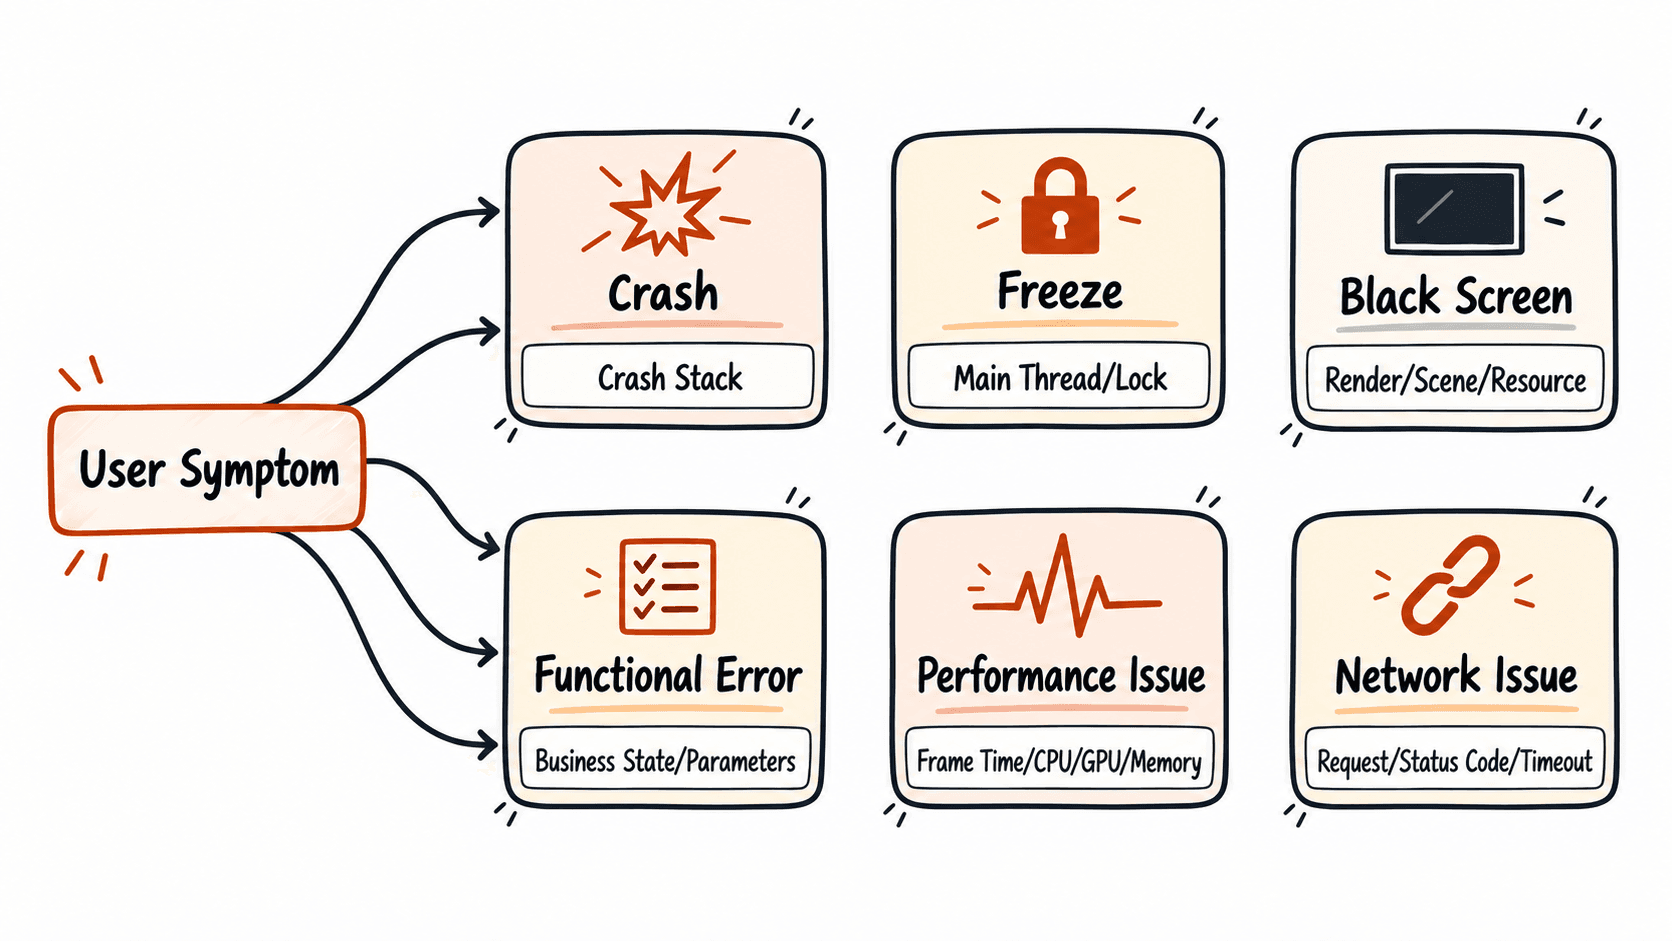
客户端故障适合先按可观察现象分类,而不是按你猜测的根因分类。因为根因在排查开始时通常未知,而“闪退”“画面不动”“按钮无响应”“延迟飙高”这些现象可以直接确认。
| 故障类型 | 典型现象 | 第一批证据 |
|---|---|---|
| 崩溃 | 进程退出、闪退、系统弹出崩溃提示 | 崩溃栈、异常类型、信号、最近操作 |
| 卡死 | 进程仍在但画面或交互长时间不响应 | 主线程栈、锁等待、长任务、Watchdog |
| 黑屏 | 窗口存在但场景、UI 或画面没有正常显示 | 渲染初始化、资源加载、场景状态、相机/UI |
| 功能异常 | 某个按钮、任务、技能、道具逻辑不符合预期 | 业务日志、状态机、输入参数、服务端返回 |
| 性能异常 | 掉帧、卡顿、发热、内存持续上涨 | 帧耗时、CPU/GPU、GC、内存、资源加载 |
| 网络异常 | 登录失败、请求超时、掉线、同步延迟 | 请求 URL、状态码、错误码、超时、重试、网络类型 |
这一步只需要得到“最像哪一类”的初始判断,不要求一次猜中根因。同一问题也可能跨类,例如网络请求阻塞主线程,用户看到的是卡死,但根因实际来自网络调用设计。
用最短证据确认初始方向
实际排查时,可以先收集一段最小现场日志。下面这段不是可执行命令,而是用于练习分类的日志样例:
text
12:03:14.210 [Render] EnterLevel level=forest_01
12:03:14.468 [Net] GET /player/profile status=200 cost=82ms
12:03:14.921 [Asset] Load bundle=forest_common success
12:03:15.337 [Crash] Unhandled exception: NullReference
12:03:15.338 [Crash] PlayerController.Update()从现象和最后几行证据看,这应先按崩溃处理,而不是因为日志里出现了 Net 就进入网络排查。分类时要优先看“最终发生了什么”,再看导致它发生的前置事件。
预期判断结果:
text
故障类型:崩溃
第一证据:异常类型 + 崩溃栈
后续关注:PlayerController.Update() 触发前的玩家状态与输入
容易混淆的边界
卡死和性能异常最容易混淆。短时间掉到 10 FPS 仍然能操作,通常先归为性能异常;主线程数秒没有响应、点击完全不处理,则更像卡死。判断标准不是“用户觉得卡”,而是事件循环是否仍在持续处理输入和帧更新。
黑屏也不等于崩溃。若进程仍存活、声音还在、网络心跳正常,应优先检查渲染、场景切换、资源加载和 UI 层级。只有进程退出或出现未处理异常,才进入崩溃方向。
功能异常则强调“程序仍在正常运行,但结果不对”。例如道具扣除了却没有生效,首先要核对业务状态、关键参数和服务端响应,而不是先做 CPU 或 GPU 性能分析。
建立固定的分诊顺序
一次现场排查可以固定为以下顺序:
- 先确认进程是否仍然存活,区分崩溃与非崩溃。
- 再确认是否还能持续刷新画面和响应输入,区分卡死与其他问题。
- 若程序可运行,判断问题主要发生在显示、业务结果、性能还是网络。
- 为当前类别只收集最相关的第一批证据,不要一开始就抓取所有日志。
- 如果证据与初始分类矛盾,再调整分类,而不是硬套原先判断。
真正高效的客户端排查,不是记住更多故障名称,而是把“现象 → 分类 → 第一证据”形成稳定链路。只要入口方向选对,后续日志、性能采样和复现验证才有意义。
按自己的节奏,确认真正理解。