
游戏客户端架构 / 系统课时
如何防止问题修完又回来
如何防止问题修完又回来
一次修复只能解决当前版本,真正可靠的做法是把这次故障留下来的条件转成长期检查项,让后续代码、配置或资源变化再次触碰同一风险时自动暴露。本节把“修复经验”整理成可持续的回归闭环。
学习目标
- 把一次故障的触发条件转化为稳定的回归检查
- 理解测试、日志断言、监控指标和版本检查各自负责什么
- 建立从线上异常回流到自动化验证的闭环
把故障条件翻译成可重复检查
先不要从“要不要补个测试”出发,而是回到故障本身:什么输入、状态或时序让错误出现?只要能写成明确条件,就能决定该放在哪一层防守。
| 故障条件 | 更适合的防线 |
|---|---|
| 固定输入必然触发 | 单元测试或集成测试 |
| 特定调用顺序才触发 | 场景测试或自动化流程 |
| 错误只能从日志识别 | 日志断言或错误签名检查 |
| 只在线上长时间出现 | 监控指标和告警 |
| 修复仅存在于指定构建 | 版本号、提交号或资源版本检查 |
同一个问题可以有多层防线。例如“重复网络事件导致重复结算”既可以有去重逻辑测试,也可以监控重复事件计数,还要确认回归包确实包含修复提交。
回归闭环覆盖四层防线
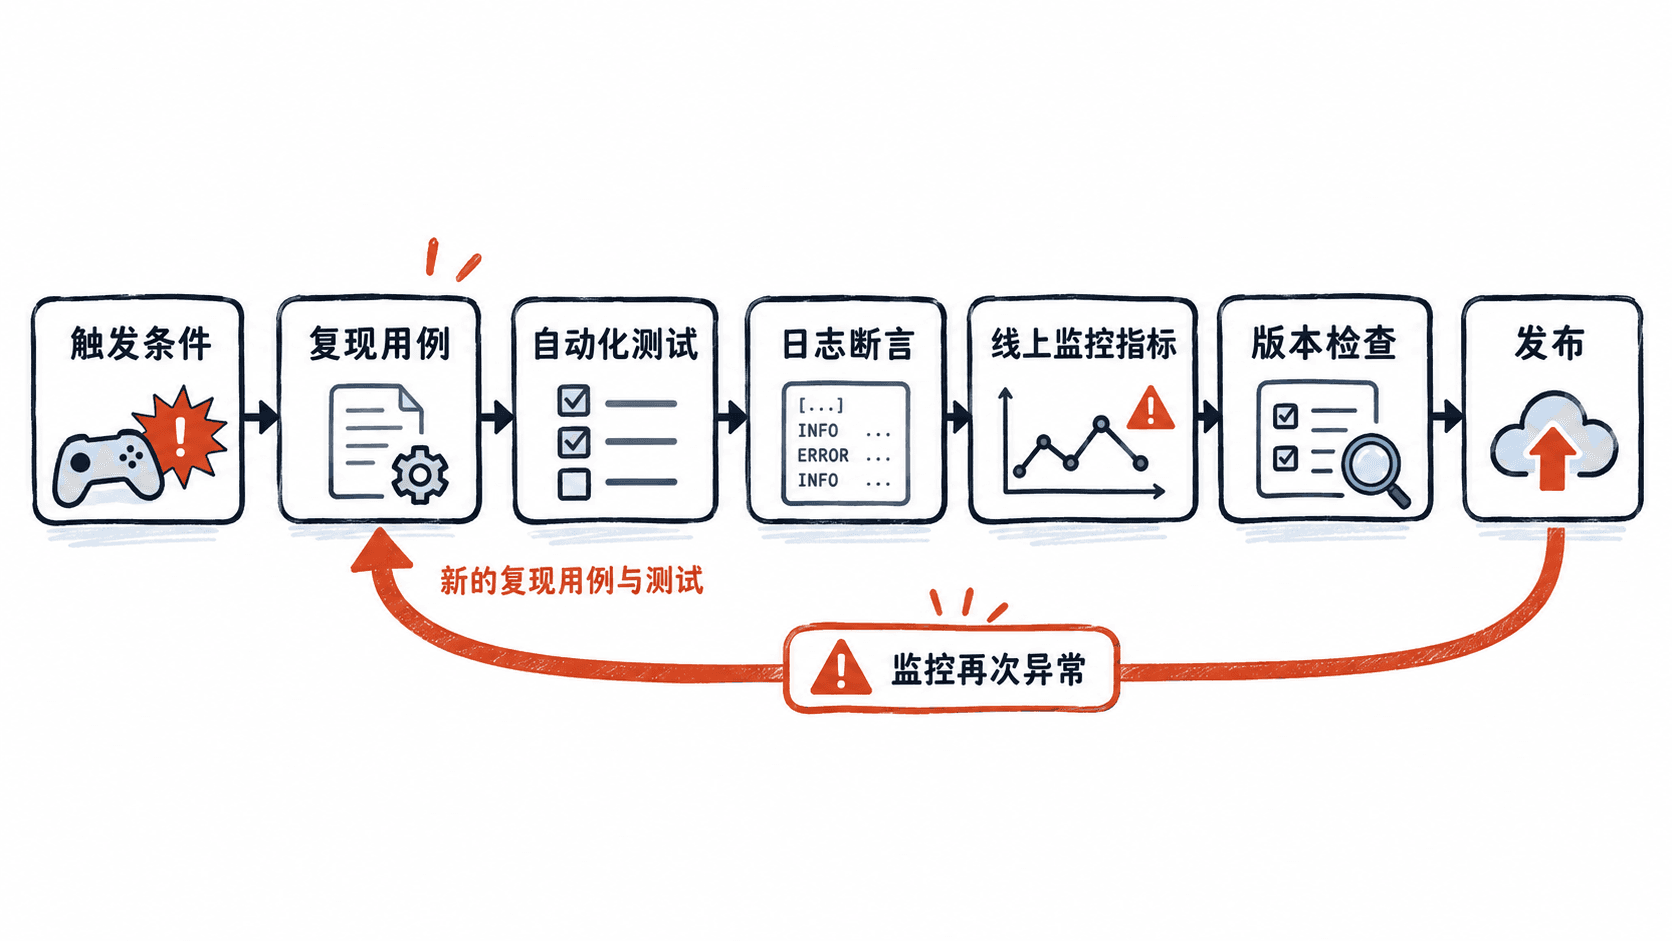
自动化测试负责阻止已知逻辑错误重新进入主干;日志断言负责捕获“程序没有崩但内部状态已经异常”的情况;监控负责覆盖实验室难以持续复现的长尾问题;版本检查则防止拿错包、资源或配置导致回归结论失真。
这四层不是越多越好,而是按故障特点选择最便宜、最稳定的组合。一个纯函数边界错误,用单元测试就够;一个只在长连接运行数小时后出现的异常,仅靠单元测试通常不够。
用最小用例锁住已知故障
假设曾经出现“同一个事件被重复处理”的问题,修复后最小回归用例应该直接锁住这个条件,而不是重放一整局游戏。下面用事件去重器示意这种写法。
class EventDeduplicator:
    def __init__(self):
        self._seen = set()

    def accept(self, event_id):
        if event_id in self._seen:
            return False
        self._seen.add(event_id)
        return True

def main():
    guard = EventDeduplicator()

    assert guard.accept("evt-101") is True
    assert guard.accept("evt-101") is False
    assert guard.accept("evt-102") is True

    print("regression checks passed")

if __name__ == "__main__":
    main()
预期输出
regression checks passed这里最重要的不是去重器实现,而是测试直接保存了“第一次接受、重复事件拒绝、新事件仍可接受”这三个行为。将来有人重构代码,只要破坏其中任一条件,回归检查就会立即失败。
把门禁放进发布流程
回归用例只有被持续执行才有价值。每次准备发布时,应让同一套检查绑定到目标构建,并记录客户端版本、资源版本和必要的提交标识。测试通过但版本不匹配,结论仍然无效。
日志和监控也要使用稳定的字段或错误码,不要依赖整段自然语言。文本稍微改写就会让字符串匹配失效,而结构化的错误类型、模块名和计数指标更适合长期观察。
让线上问题反向补强测试
闭环的最后一步是把新事故重新喂回验证体系。线上出现旧错误签名时,先确认是不是同一根因;如果是,就检查为什么现有测试、日志断言或监控没有提前拦住,再补上缺口。
如果问题能稳定复现,优先固化成自动化用例;如果只能在特定设备或长时间运行中出现,就至少保留结构化日志和监控阈值,并把对应版本信息一起上报。这样每次故障都会让系统多一道防线,而不是只留下一个“已修复”的工单状态。