
游戏客户端架构 / 系统课时
如何串起一次排障证据链
如何串起一次排障证据链
一次有效排障不是从日志里“找一条像错误的行”,而是把现象、时间、环境、日志、假设和验证连成可复查的链路。这样即使问题跨引擎、跨模块或无法稳定复现,也能逐步缩小范围,而不是靠经验反复猜测。
学习目标
- 用固定顺序收集一次故障的关键证据
- 把日志和现场信息绑定到同一次会话或事件
- 将猜测改写成可以被验证或推翻的排障假设
先固定故障锚点
排障第一步不是立即搜索 Error,而是确定“哪一次故障”。至少记录发生时间、构建版本、会话或玩家标识、设备环境、触发动作和可见现象。没有这些锚点,不同用户、不同版本、不同时间段的日志很容易被混在一起。
例如“加载页卡住”过于宽泛,更好的记录是“构建 1.8.3,session=S-42,21:14:08 点击进入战斗后,加载页 30 秒未消失”。后续所有证据都围绕这个锚点收集。
把证据按同一条链路连接起来
一条完整链路通常从用户现象开始,先定位对应会话和时间窗口,再查看日志与现场状态,提出假设,最后用最小实验验证。假设被推翻后,应回到证据阶段继续缩小范围,而不是修改代码“试试看”。
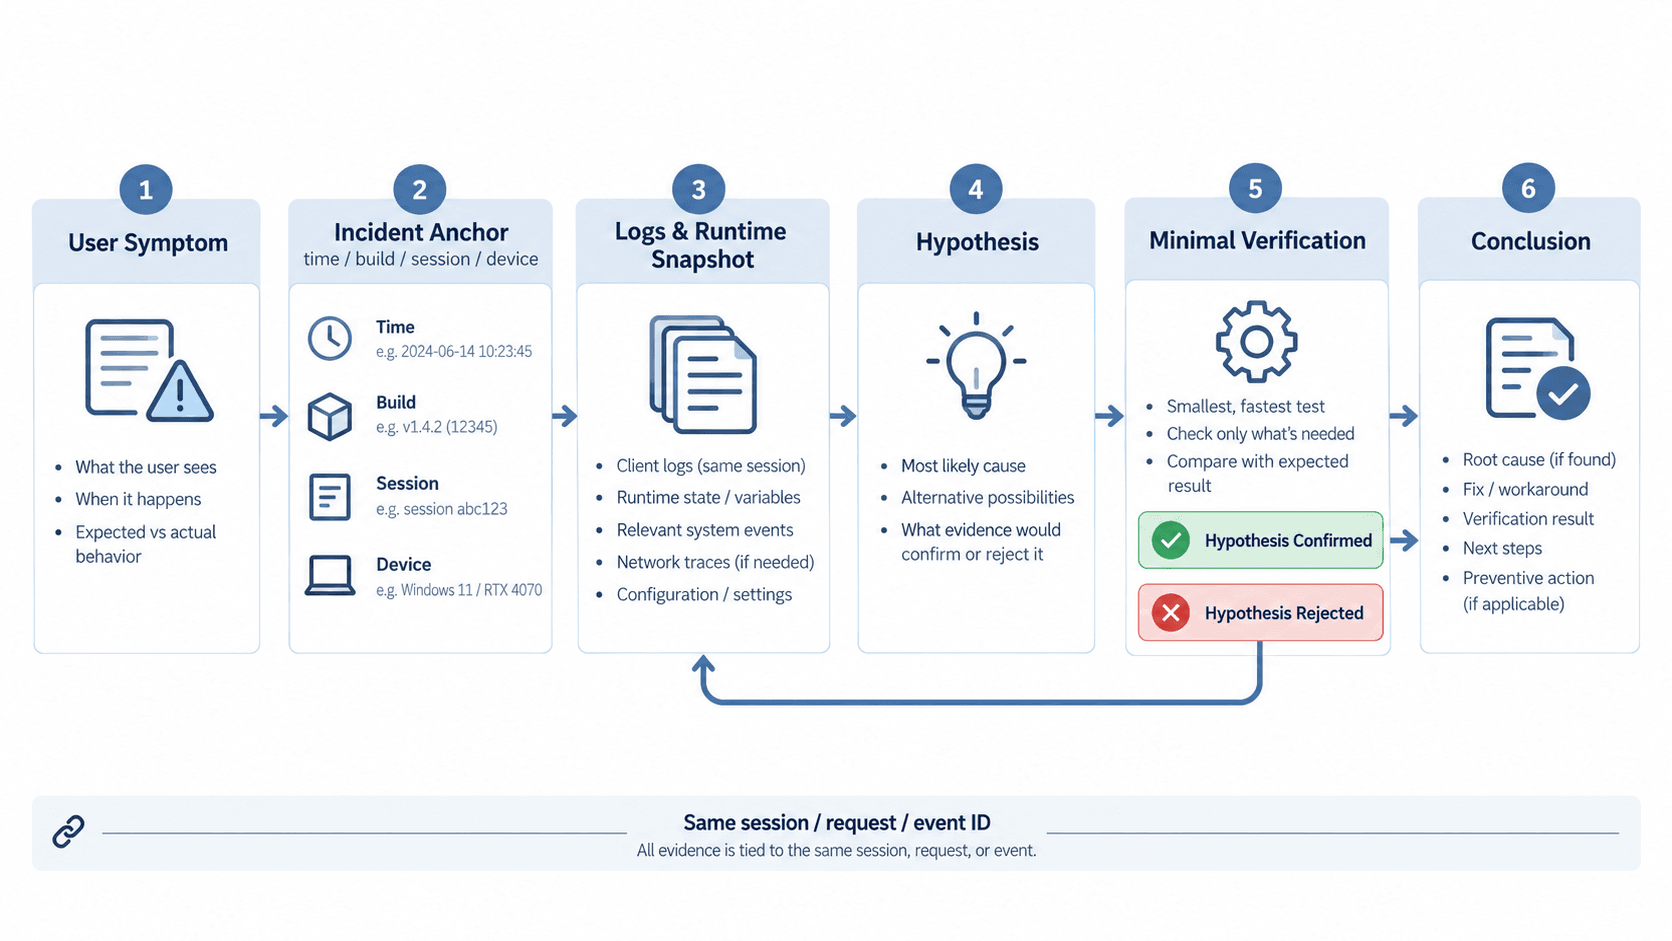
这张链路的关键是“证据优先于结论”。日志里出现超时,不代表根因一定是网络;资源加载失败,也可能由版本不一致、磁盘空间、权限或配置错误触发。只有能同时解释现象和现有证据的假设,才值得进入验证阶段。
用关联标识筛出同一次故障
下面的 Python 示例模拟一段客户端日志,并只筛出 session=S-42 的事件。真实项目可以把相同思路用于日志文件、远程日志平台或本地诊断包。
from dataclasses import dataclass

@dataclass(frozen=True)
class Incident:
    session_id: str
    build: str
    symptom: str

incident = Incident(
    session_id="S-42",
    build="1.8.3",
    symptom="battle loading screen did not close",
)

logs = [
    "21:14:07 INFO session=S-41 scene=lobby event=ready",
    "21:14:08 INFO session=S-42 event=enter_battle",
    "21:14:09 INFO session=S-42 event=load_bundle name=battle_common",
    "21:14:10 ERROR session=S-42 event=load_bundle result=not_found",
    "21:14:11 WARNING session=S-42 event=retry count=1",
]

related = [line for line in logs if f"session={incident.session_id}" in line]

print(f"build={incident.build}")
print(f"symptom={incident.symptom}")
for line in related:
    print(line)
预期输出:
build=1.8.3
symptom=battle loading screen did not close
21:14:08 INFO session=S-42 event=enter_battle
21:14:09 INFO session=S-42 event=load_bundle name=battle_common
21:14:10 ERROR session=S-42 event=load_bundle result=not_found
21:14:11 WARNING session=S-42 event=retry count=1
这组证据只能说明“进入战斗后,资源加载出现 not_found 并发生重试”,还不能直接证明根因。下一步应检查该构建对应的资源清单、发布版本和实际可访问资源是否一致。
把假设写成可被推翻的句子
好的假设必须包含明确条件和预期。例如:“如果是客户端资源版本与发布清单不一致,那么同一构建在相同资源环境下应稳定出现同一资源缺失,并且资源清单中找不到该版本需要的文件。”
随后只做能验证这一假设的最小动作,例如校验构建号与资源清单、检查目标文件是否存在、换用同版本干净安装复现。若结果与预期不符,就明确标记假设被否定,再回到现有证据提出新的解释。
避免一次同时改网络重试、资源路径和加载超时。多个变量一起变化后,即使问题消失,也无法知道究竟是哪项修改起作用,证据链会在验证阶段断掉。
用结论闭环而不是停在“已恢复”
排障结束时,结论至少要回答:用户看到了什么、哪条证据最关键、根因是什么、验证如何证明它、修复后如何确认没有复发。对于暂时无法定位的问题,也应保存已排除的假设和缺失证据,避免下一位工程师从零开始。
真正可复用的排障能力,不是记住某个引擎的某条报错,而是每次都能从同一故障锚点出发,把日志、现场、假设和验证绑定成一条可以复查、可以证伪、可以继续追踪的证据链。