
游戏客户端架构 / 系统课时
资源加载失败怎么追路径
资源加载失败怎么追路径
资源加载失败不能只盯着最终的“not found”或“load failed”。真正有效的排查方式是顺着资源标识一路追到目录映射、依赖文件、磁盘或包内路径、缓存副本和版本信息,确认究竟在哪一层发生了偏差,并用哈希或版本号判断文件是否损坏或错配。
学习目标
- 从资源标识反向追踪到实际文件与依赖项
- 区分资源不存在、内容损坏、缓存污染和版本不匹配
- 建立可以重复执行的资源校验顺序
先画出资源从标识到文件的路径
游戏里的逻辑资源名通常不会直接等于磁盘文件名。一个 character/hero_a 可能先经过资源目录或 manifest,解析出所属 bundle,再加载依赖 bundle,最后从安装包、补丁目录或缓存中读取实际文件。只要其中一层映射错了,最终都可能表现成“资源加载失败”。
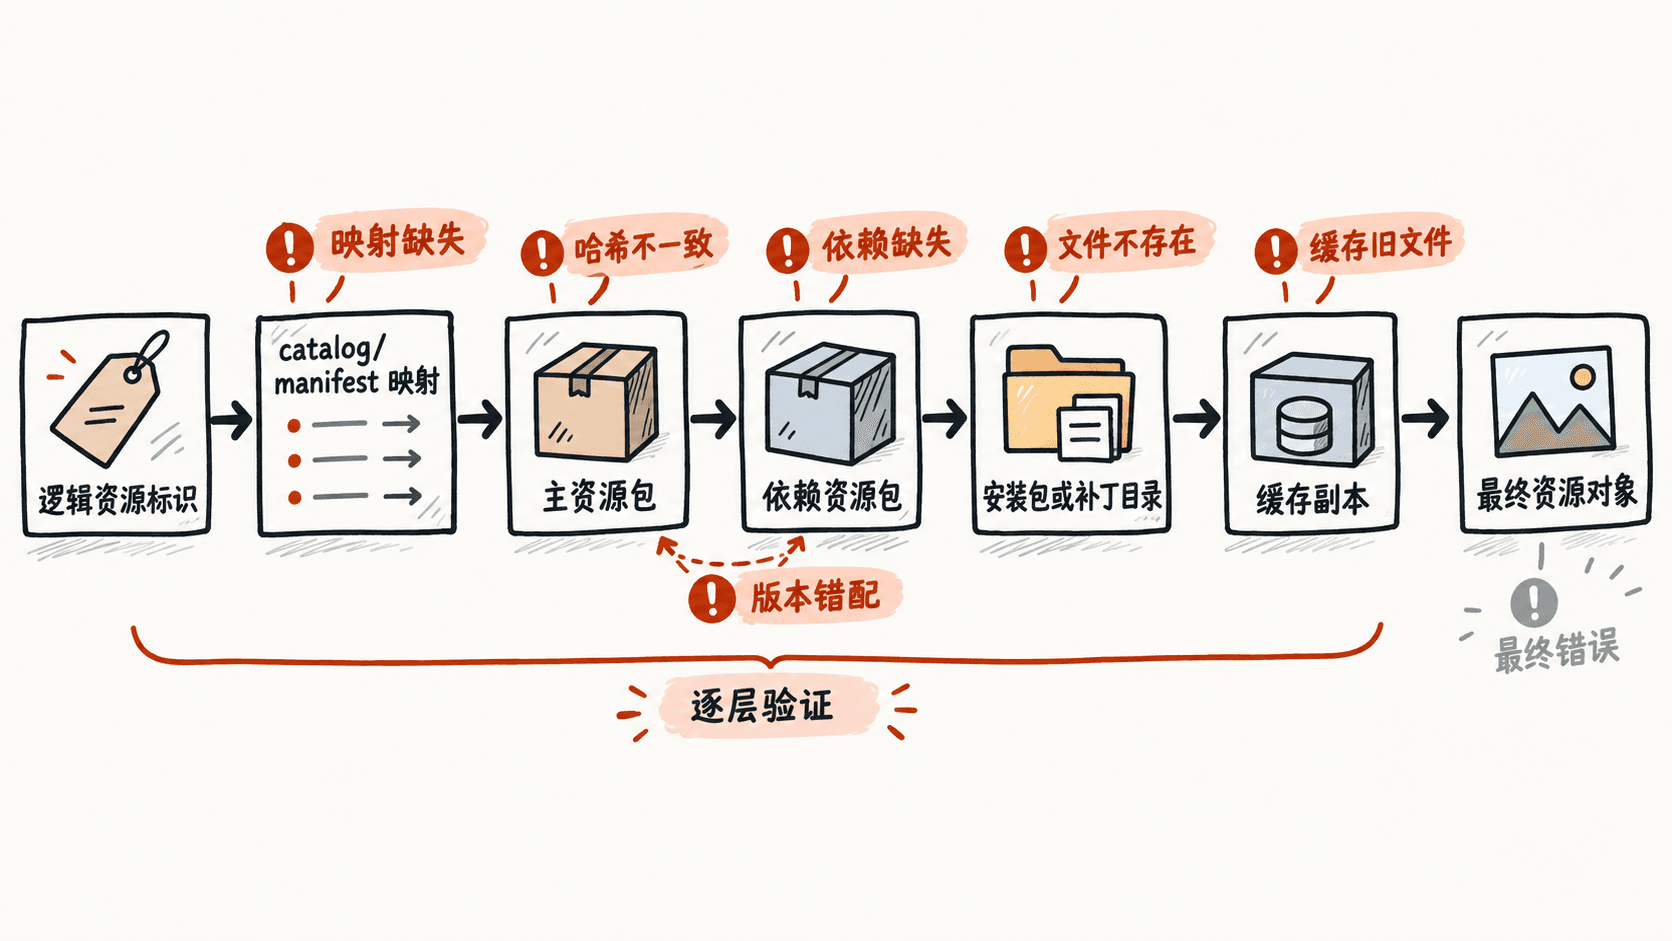
排查日志至少要同时记录逻辑资源 ID 和解析后的实际来源,例如 assetId、bundle 名、依赖列表、最终文件路径、缓存命中状态、资源版本和内容哈希。否则只能看到“加载失败”,却不知道客户端实际尝试读的是哪一个文件。
按固定顺序验证存在性、版本和内容
推荐先验证“路径是否正确”,再验证“版本是否一致”,最后检查“内容是否损坏”。顺序反过来容易浪费时间:一个根本不存在的文件,不需要先分析解压算法或反序列化错误。
可以用一个小脚本对单个文件做最基础的存在性和 SHA-256 校验。下面示例会创建临时资源文件,因此路径是动态值。
from pathlib import Path
from tempfile import TemporaryDirectory
import hashlib

def sha256(path):
    return hashlib.sha256(path.read_bytes()).hexdigest()

with TemporaryDirectory() as temp_dir:
    root = Path(temp_dir)
    asset = root / "hero_a.bundle"
    asset.write_bytes(b"hero-a-v2")

    expected_hash = hashlib.sha256(b"hero-a-v2").hexdigest()

    print(f"path=<PATH>/hero_a.bundle")
    print(f"exists={asset.exists()}")
    print(f"sha256_ok={sha256(asset) == expected_hash}")
预期输出:
path=<PATH>/hero_a.bundle
exists=True
sha256_ok=True
把这个思路接入真实项目时,不要手工填写期望哈希;应使用构建产物清单或补丁 manifest 中已经发布的哈希。若文件存在但哈希不匹配,优先怀疑下载中断、磁盘写入异常、CDN 返回旧内容或缓存目录里混入了其他版本文件。
依赖失败要追到第一处断点
主资源存在并不代表一定能加载成功。纹理、材质、着色器、配置表或其他 bundle 可能是它的依赖。日志中如果只打印主资源名,就会把“依赖缺失”误判成“主资源损坏”。
追依赖时应从失败资源开始,列出本次实际解析到的直接依赖,并继续确认每个依赖是否存在、版本是否与主资源来自同一次发布。遇到多个失败项时,优先找最早出现的公共依赖;如果十个角色都同时缺同一个共享材质包,根因通常在共享包而不是十个角色资源各自损坏。
缓存问题要用“绕过缓存”验证
缓存命中并不能证明内容正确。补丁系统常见问题是 key 没带版本、旧文件未清理、下载成功后索引未更新,最终让客户端持续读取旧副本。
最有效的验证方式不是立刻清空所有缓存,而是对单个失败资源做一次可控的绕过:记录原缓存 key 和命中路径,临时改为从源文件或补丁目录读取,再比较结果。如果绕过后恢复正常,说明问题已经收敛到缓存索引、淘汰策略或缓存文件本身;如果仍失败,就继续沿 manifest 和依赖链排查。
清缓存前要先保存失败文件的路径、大小、修改时间和哈希,否则一旦删除,最关键的物证也一起丢失。
版本不匹配要同时看代码与资源
资源版本不是单独存在的。客户端代码、资源 catalog、bundle 和热更新脚本可能必须来自同一兼容集合。典型现象包括:文件存在、哈希也正确,但加载器提示类型不认识、序列化结构不一致,或依赖版本找不到。
因此排查包中应同时记录客户端版本、资源版本、catalog 版本和补丁批次。若只有某个客户端版本失败,而同一资源在其他版本正常,优先检查兼容性而不是重复下载。
最终的排查路径可以压缩成一句话:先确认客户端把资源 ID 解析到了哪里,再确认那个位置的主文件和依赖是否存在,接着校验版本与哈希,最后用绕过缓存验证是否读取了错误副本。只要每一层都留下可核对的标识和路径,资源加载故障就能定位到明确断点。