
架构与系统设计 / 系统课时
估算结果怎样影响架构
估算结果怎样影响架构
容量估算只有转化成架构决策才有价值。面试中不应看到“大流量”就机械地加缓存或分库,而要先判断究竟是计算、存储、读流量、写流量还是峰值突发超过了单个组件的承载范围,再选择对应手段。
学习目标
- 把 QPS、数据量、带宽和峰值估算映射到具体瓶颈
- 判断何时考虑单机、多副本、缓存、异步化和分片
- 用容量依据解释架构复杂度,而不是凭经验堆组件
先从瓶颈而不是组件出发
估算结果通常不会直接告诉你“必须使用 Redis”或“必须分库”。它提供的是约束,例如峰值请求数、每日新增数据、热点读取比例、写入速度和出口带宽。
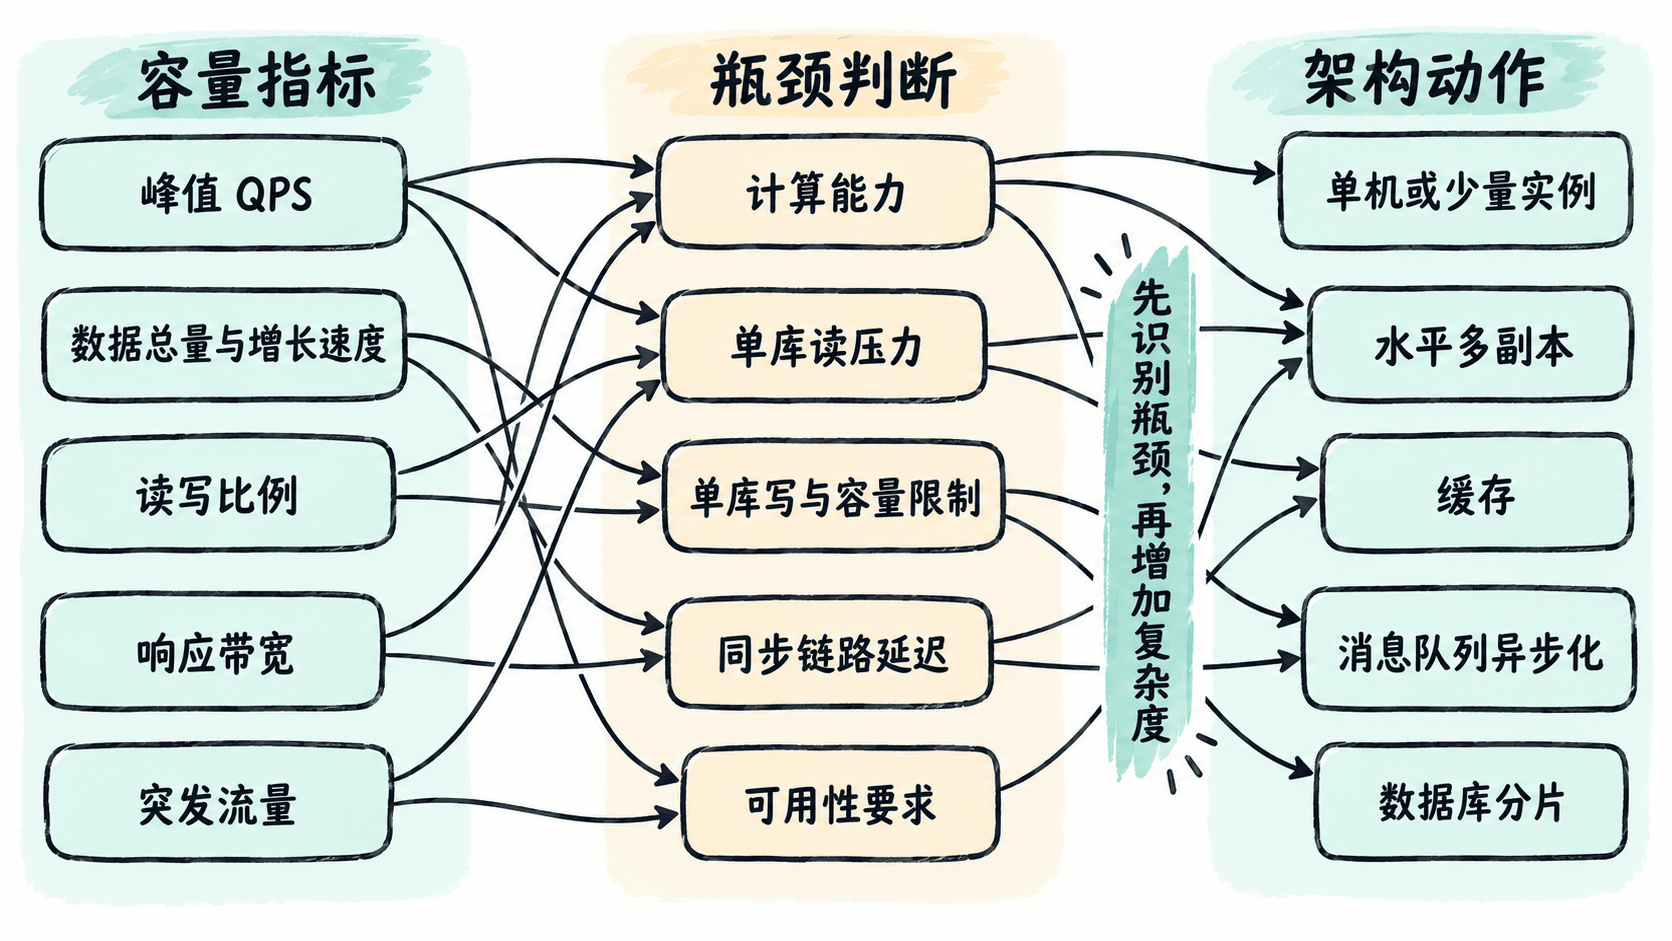
最重要的判断顺序是:估算值 → 组件上限 → 预计利用率 → 是否需要拆分或卸载压力。这样得到的架构才有可以解释的因果关系。
不同数量级对应不同动作
下面的映射不是固定阈值,而是面试中常用的决策方式。真正的单机上限取决于语言、硬件、数据库类型、查询复杂度和延迟目标。
| 估算信号 | 首先怀疑的瓶颈 | 常见架构动作 |
|---|---|---|
| 峰值 QPS 超过单实例处理能力 | CPU、线程或连接数 | 无状态服务水平扩展,多副本分担请求 |
| 读请求远多于写请求且热点明显 | 数据库读吞吐 | 增加缓存,必要时增加只读副本 |
| 写入瞬时峰值远大于稳定处理能力 | 下游写吞吐 | 消息队列削峰,后台异步消费 |
| 数据量或持续写吞吐逼近单库边界 | 单库容量、索引和写入能力 | 按稳定分片键拆分数据 |
| 可用性要求高于单节点能力 | 单点故障 | 多副本、故障转移和跨故障域部署 |
这张表的关键不是记住“什么场景配什么组件”,而是能解释组件消除了哪一个容量约束。
用一个估算结果推导架构
假设某内容服务平均 20,000 QPS,其中 95% 是读请求,平均响应约 20 KiB,峰值系数为 3。高峰请求约为 60,000 QPS,平均出口约 3.3 Gb/s,高峰出口接近 9.8 Gb/s;高峰读请求约为 57,000 QPS。
如果单个应用实例经过压测只能稳定处理约 5000 QPS,那么应用层至少需要多个实例,并继续为故障和流量波动留余量。这个结论支持水平多副本,但还不能推出数据库一定要分片。
数据库面对的是约 57,000 次每秒的高峰读取。若大部分请求集中在少量热门内容,可以先使用缓存吸收热点读取;假设缓存命中率达到 90%,落到数据库的读压力会下降到原来的约十分之一。此时为了读流量直接分库,往往属于过早增加复杂度。
如果系统每天新增的数据持续累积,最终使单库容量、索引维护或写吞吐接近边界,那么分片才有了独立的容量依据。相反,如果问题只是短时间写峰值,而数据库长期平均写入能力足够,消息队列削峰通常比立即分片更合适。
架构复杂度也需要被证明
设计方案里最容易失分的情况,是估算只有一组数字,架构图却突然出现缓存、队列、分片和多机房。每增加一种机制,都应该能回答“如果不加它,哪个指标会首先越界”。
例如可以这样组织解释:峰值 QPS 超过单实例能力,因此应用采用多副本;读流量远高于数据库目标吞吐,因此增加缓存;突发写入会超过数据库瞬时写能力,因此使用队列削峰;当前数据量仍可由单库承载,所以暂不分片,但预留稳定分片键作为增长路径。
容量估算最终要形成一条可追溯的决策链:哪个数字会超过什么上限,因此增加什么组件,以及这个组件把压力转移到了哪里。 能把这条链说清楚,比堆出一张组件很多的架构图更能体现系统设计能力。