
架构与系统设计 / 系统课时
从零设计一个搜索系统
从零设计一个搜索系统
这场模拟要把“搜索”拆成两条可落地链路:数据如何进入索引,以及查询如何从词项命中结果。你需要在容量、延迟、相关性和新鲜度之间做取舍,并说明缓存、分片、副本和最终一致性分别解决什么问题。
学习目标
- 从搜索需求中提取可量化的规模、延迟和新鲜度目标。
- 设计索引构建、分片副本与查询聚合的完整链路。
- 解释缓存、扩容和最终一致性的边界与降级方式。
先定义搜索边界和质量目标
先约定本题是站内商品搜索,而不是通用互联网搜索。用户输入关键词,可叠加品牌、类目、价格等过滤条件,并按相关性或价格排序;搜索结果需要返回商品 ID、标题、价格和必要的展示字段。
然后给出容量假设,例如 1 亿商品文档、峰值查询 2 万 QPS、商品更新峰值 5000 条每秒,目标 P95 查询延迟低于 200 ms,大多数更新在 5 秒内可搜索。若面试官要求强实时,就要重新讨论刷新频率、写放大和成本,而不是默认索引“提交后立刻全局可见”。
搜索系统至少同时优化四个维度:查询延迟、吞吐、结果相关性和索引新鲜度。它们彼此牵制,因此后面的每个组件都要能回到这些目标上解释。
拆成索引构建与查询两条链路
搜索系统最容易在口头描述中混淆“写数据库”和“写索引”。更清晰的做法是把业务数据库作为事实来源,通过 CDC 或事件日志捕获变化,经标准化、分词和字段抽取后写入搜索索引;查询侧则从 Query Service 进入缓存和索引集群,再聚合各分片结果。
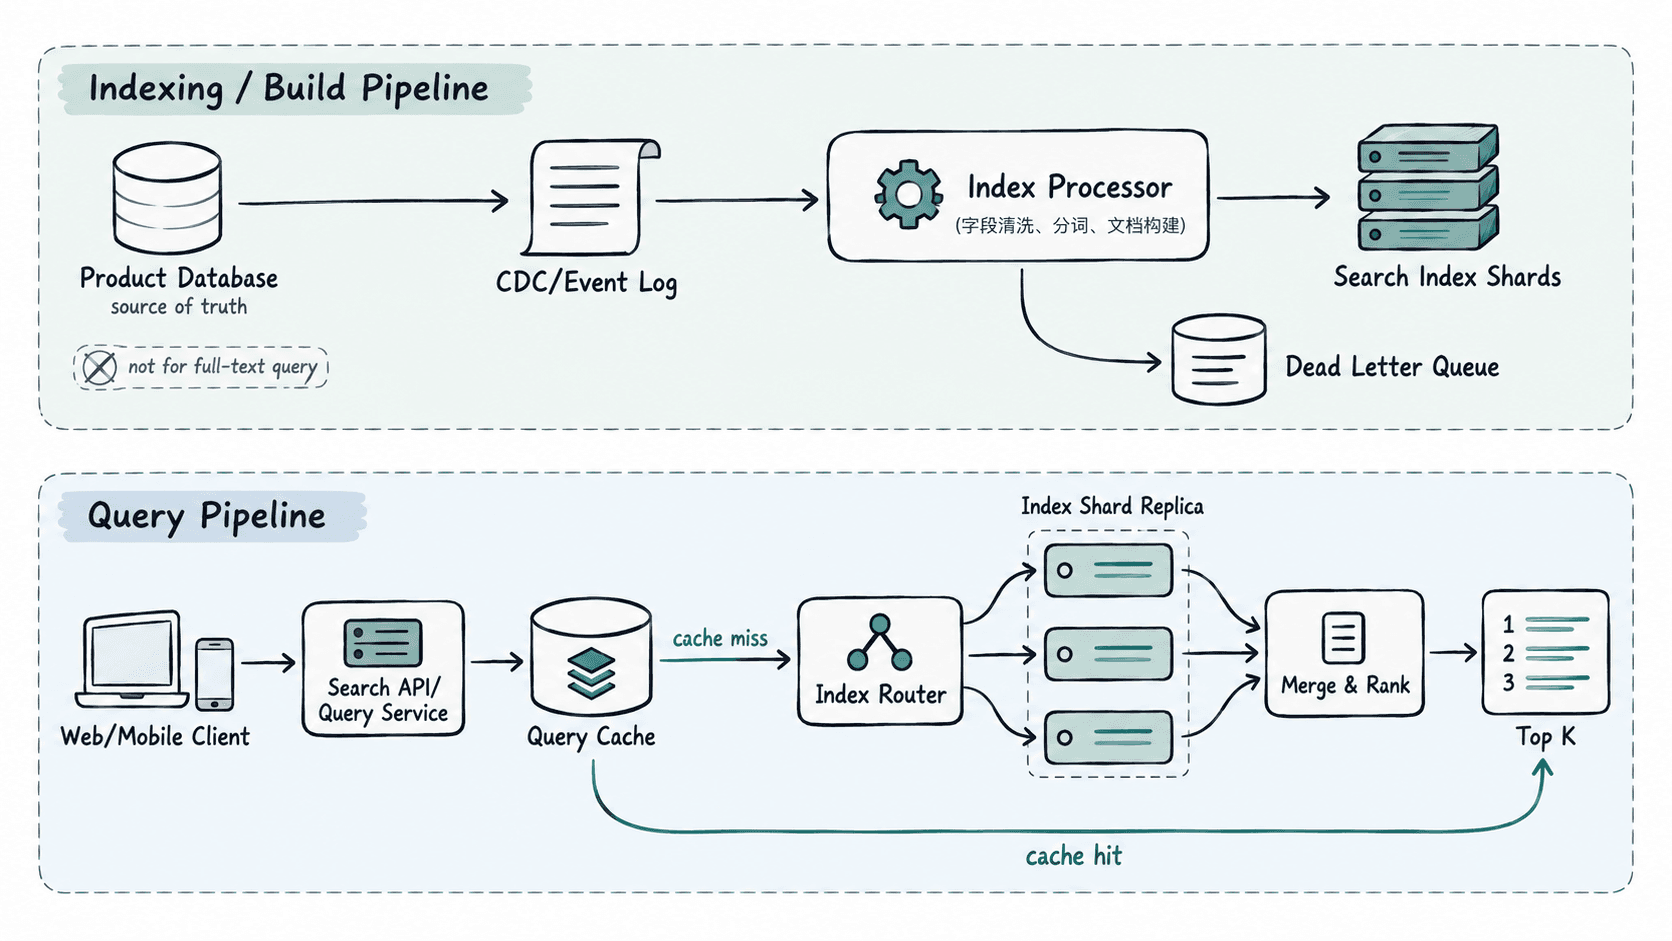
这样做的关键收益是解耦。业务写入只需先保证主数据成功,搜索索引允许短暂延迟;如果索引处理失败,可以从日志重放,而不必要求业务请求同时提交两个完全不同的存储系统。
设计索引、分片和副本
倒排索引把词项映射到包含该词的文档集合,因此查询关键词时不需要扫描 1 亿条商品。过滤条件通常对应可检索字段或列式结构,排序字段则要考虑是否能在分片内高效裁剪候选集。
当单节点容纳不了全部索引或查询并发时,把文档分到多个主分片。查询服务将请求并行发往相关分片,各分片返回局部 Top K,聚合层再做全局合并。副本既提供高可用,也能横向承担读流量。
| 压力来源 | 优先手段 | 不应先做的事 |
|---|---|---|
| 查询 QPS 增长 | 增加副本、查询节点、缓存 | 立即增加主分片数量 |
| 索引容量增长 | 增加分片或迁移历史索引 | 仅靠缓存掩盖容量不足 |
| 写入吞吐增长 | 扩展索引处理器与分片写能力 | 让业务库同步等待所有索引刷新 |
| 单个词项过热 | 热查询缓存、请求合并 | 对全部查询统一延长缓存时间 |
主分片数量不是越多越好。分片过多会增加查询扇出、连接数和合并开销,所以应根据索引体积、节点内存和目标并发留出增长空间,而不是把“可扩展”简单等同于“尽量多分片”。
把查询链路做成可降级路径
查询服务先规范化请求,例如大小写、停用词策略和过滤条件,再构造缓存键。高频稳定查询可以短时间缓存结果;未命中时路由到索引副本并行执行,各分片返回候选集,聚合层完成去重、排序和截断。
缓存适合吸收重复查询,但不适合作为正确性的唯一来源。价格、库存等高频变化字段如果必须强实时,可以只在索引中保存用于召回的稳定字段,再在结果阶段批量回源补充实时属性;如果允许几秒延迟,则可直接索引这些字段,换取更短查询路径。
局部分片超时不一定要让整个请求失败。面试中可以提出超时预算:例如总预算 200 ms,分片查询超过预算就返回已有结果并打上部分结果指标,同时后台记录超时分片。对于“必须完整”的管理搜索,则可以选择失败而不是降级,体现不同业务场景的取舍。
用版本和事件保证更新可见性
搜索索引通常采用最终一致性:业务数据库提交成功后,变更事件进入日志,索引消费者按顺序处理并刷新可见。这样用户可能在短时间内搜不到刚更新的商品,但系统避免了数据库和索引之间脆弱的同步双写。
为了处理乱序和重复事件,每个商品文档应携带单调版本或更新时间。索引器只接受不旧于当前版本的更新;删除操作写入 tombstone 或删除事件,避免旧事件重放后把已删除商品“复活”。消费位点、积压量和端到端延迟是判断新鲜度是否达标的关键指标。
如果业务要求“商家刚修改标题后自己立刻能搜到”,可以给管理端提供读己之写能力,例如在短时间内按商品 ID 直接查询主数据,或等待目标版本进入索引,而不必把全站搜索升级成昂贵的强一致系统。
约束变化时沿瓶颈扩展
当查询 QPS 翻十倍,先看缓存命中率、Query Service CPU、索引副本 CPU 和分片扇出延迟,通常通过扩副本、热点缓存和限流解决。若文档量翻十倍,则重点转向索引体积、分片重平衡、冷热分层和构建吞吐。
如果新鲜度从 5 秒收紧到 1 秒,要评估日志积压、索引刷新频率和段合并成本;如果相关性成为主要问题,则进入召回、排序特征与离线评估,而不是继续堆机器。一个完整的搜索设计,应让每次扩容都明确对应容量、延迟、相关性或新鲜度中的某个瓶颈,而不是笼统回答“做分布式”。