
架构与系统设计 / 系统课时
延迟突然升高怎么排查
延迟突然升高怎么排查
面对“线上延迟突然升高”的追问,重点不是立即猜数据库或网络,而是先把端到端耗时拆开,用指标确定慢在哪一段,再从排队、资源争用和下游依赖逐层缩小范围,最终给出可验证的根因与修复方案。
学习目标
- 能按端到端请求链路定位延迟升高发生的位置
- 能区分排队、网络、线程池、缓存和数据库造成的典型延迟模式
- 能用请求时间分解和服务端指标验证排查结论
先确认延迟到底变在哪里
先问清楚“延迟升高”指什么。平均延迟可能几乎不变,但少量慢请求会让 P99 明显恶化,因此至少同时看 P50、P95、P99、吞吐量和错误率。还要确认变化发生的时间点,以及是否只影响某个接口、机房、用户区域或实例。
不要从单个组件开始猜。系统设计面试中更稳妥的做法是先画出请求路径,再沿路径寻找哪个阶段的耗时或排队时间发生突变。
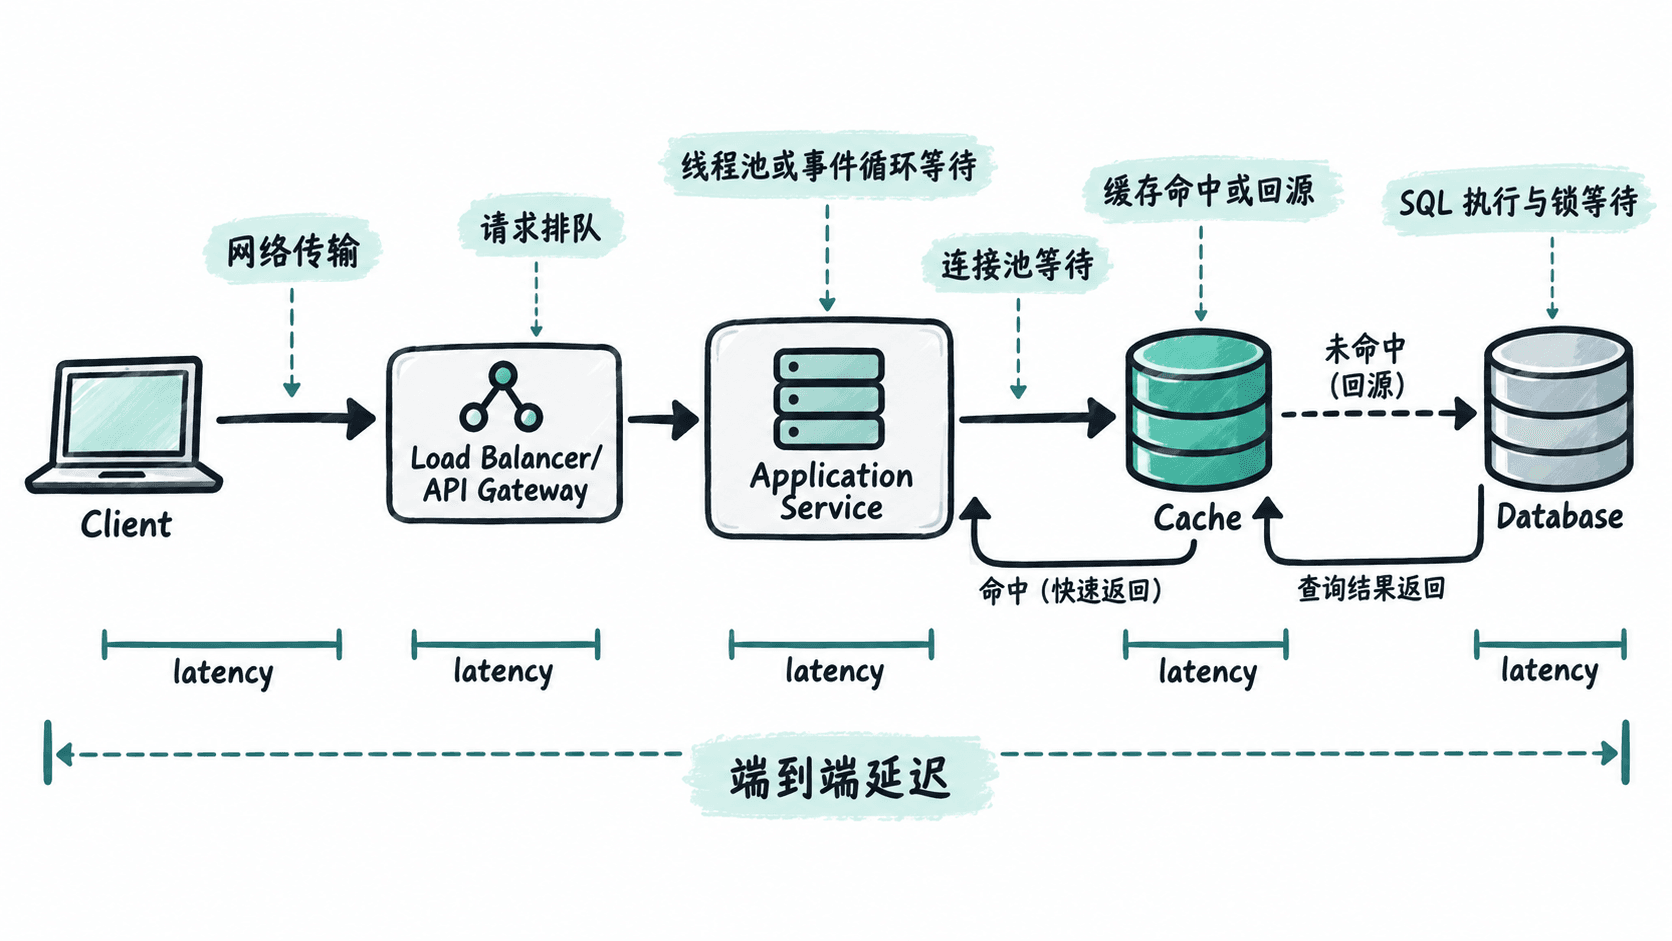
按链路拆解五类常见来源
排队延迟通常出现在流量突然增加但处理能力没有同步增加时。CPU 未必已经达到 100%,只要线程池、事件循环任务队列、数据库连接池或消息队列出现等待,请求就可能在真正执行前停留很久。
网络问题通常表现为连接建立、TLS 握手或跨区域调用耗时升高,并可能伴随丢包、重传和连接超时。若只有某个地域变慢,而服务端处理时间稳定,应优先怀疑网络路径或跨地域访问。
应用执行层要检查线程池活跃数、队列长度、CPU、GC、连接池等待时间以及下游 RPC 延迟。线程池已满时,新请求会先排队;连接池耗尽时,即使数据库本身查询很快,应用仍会因为等待连接而变慢。
缓存问题常表现为命中率突然下降,大量请求回源数据库。数据库侧则重点检查慢 SQL、锁等待、连接数、磁盘 I/O 和热点行竞争。两者经常联动:缓存失效先抬高数据库负载,随后数据库排队进一步扩大尾延迟。
用一次请求建立时间基线
可以先从客户端把 DNS、建连、TLS、首字节和总耗时拆开。下面的 curl 命令适合验证 HTTPS 请求的网络与服务端响应阶段:
curl -sS -o /dev/null -w 'dns=%{time_namelookup}\nconnect=%{time_connect}\ntls=%{time_appconnect}\nttfb=%{time_starttransfer}\ntotal=%{time_total}\n' https://example.com预期输出:
dns=<TIME>
connect=<TIME>
tls=<TIME>
ttfb=<TIME>
total=<TIME>
<TIME> 是实际测得的秒数,每次请求都可能不同。若 connect 或 tls 明显增加而 ttfb 增幅不大,应先查网络和握手;若连接阶段稳定但 ttfb 突然上升,更应该继续检查网关、应用排队和下游依赖。
服务端按等待时间继续缩小范围
服务端排查时,优先找“等待”而不是只找“利用率高”。可以依次检查入口请求队列、工作线程或事件循环、缓存回源比例、数据库连接池等待、SQL 执行时间和锁等待。一个组件的利用率只有 70%,并不代表它没有排队问题,瞬时突发和池容量限制同样会造成长尾。
| 观测现象 | 更值得优先检查的方向 |
|---|---|
| QPS 上升后 P99 激增,CPU 同时接近上限 | 应用处理能力与线程池排队 |
| CPU 正常,但数据库连接池等待上升 | 连接池容量或慢 SQL 占用连接 |
| 缓存命中率下降,数据库 QPS 同步上升 | 热点 Key 失效、缓存穿透或批量过期 |
| 只有某个地区变慢 | 网络路径、跨区域调用或区域入口 |
| SQL 执行时间升高并出现锁等待 | 热点更新、长事务或索引问题 |
用对照验证根因
找到可疑点后,还要证明它与延迟变化具有时间相关性。例如缓存命中率在 10:02 降低、数据库 QPS 随即增加、连接池等待在 10:03 上升、P99 同期恶化,这条证据链比“数据库看起来很忙”更有说服力。
修复后也要重新观察相同指标。如果扩大连接池后等待时间下降,但数据库 CPU 和 SQL 延迟继续上升,说明只是把排队从应用层推到了数据库层。完整回答应该始终形成“定位慢段、找到等待来源、修改瓶颈、用原指标验证”的闭环。