
架构与系统设计 / 系统课时
数据库挂了系统怎么办
数据库挂了系统怎么办
当核心数据库不可用时,系统设计回答要覆盖“发现故障、隔离影响、降级服务、完成切换、恢复一致性”整条链路。关键不是简单说“上主从”,而是说明哪些请求还能安全处理,哪些必须拒绝,以及恢复后如何避免双写和数据倒退。
学习目标
- 能按故障检测、隔离、降级、切换和恢复的顺序回答数据库故障。
- 区分读请求、写请求在主库故障时的不同处理策略。
- 理解故障转移中的数据丢失窗口、脑裂和恢复校验风险。
先确认是数据库故障还是连接路径故障
应用报数据库错误,不代表数据库进程一定已经挂掉。先区分 DNS、网络、连接池耗尽、认证失败、数据库拒绝连接和查询超时。对于 PostgreSQL,可以在具备客户端工具的诊断节点上做最小探测;运行前需要正确设置 DATABASE_URL。
pg_isready -d "$DATABASE_URL"
psql "$DATABASE_URL" -Atc 'SELECT 1;'
预期输出
<HOST>:<PORT> - accepting connections
1
实际主机和端口会不同。如果 pg_isready 已失败,就优先定位网络、实例或切换状态;如果连接正常而 SELECT 1 超时,则继续检查锁、资源耗尽和存储延迟。
故障发生后先控制影响面
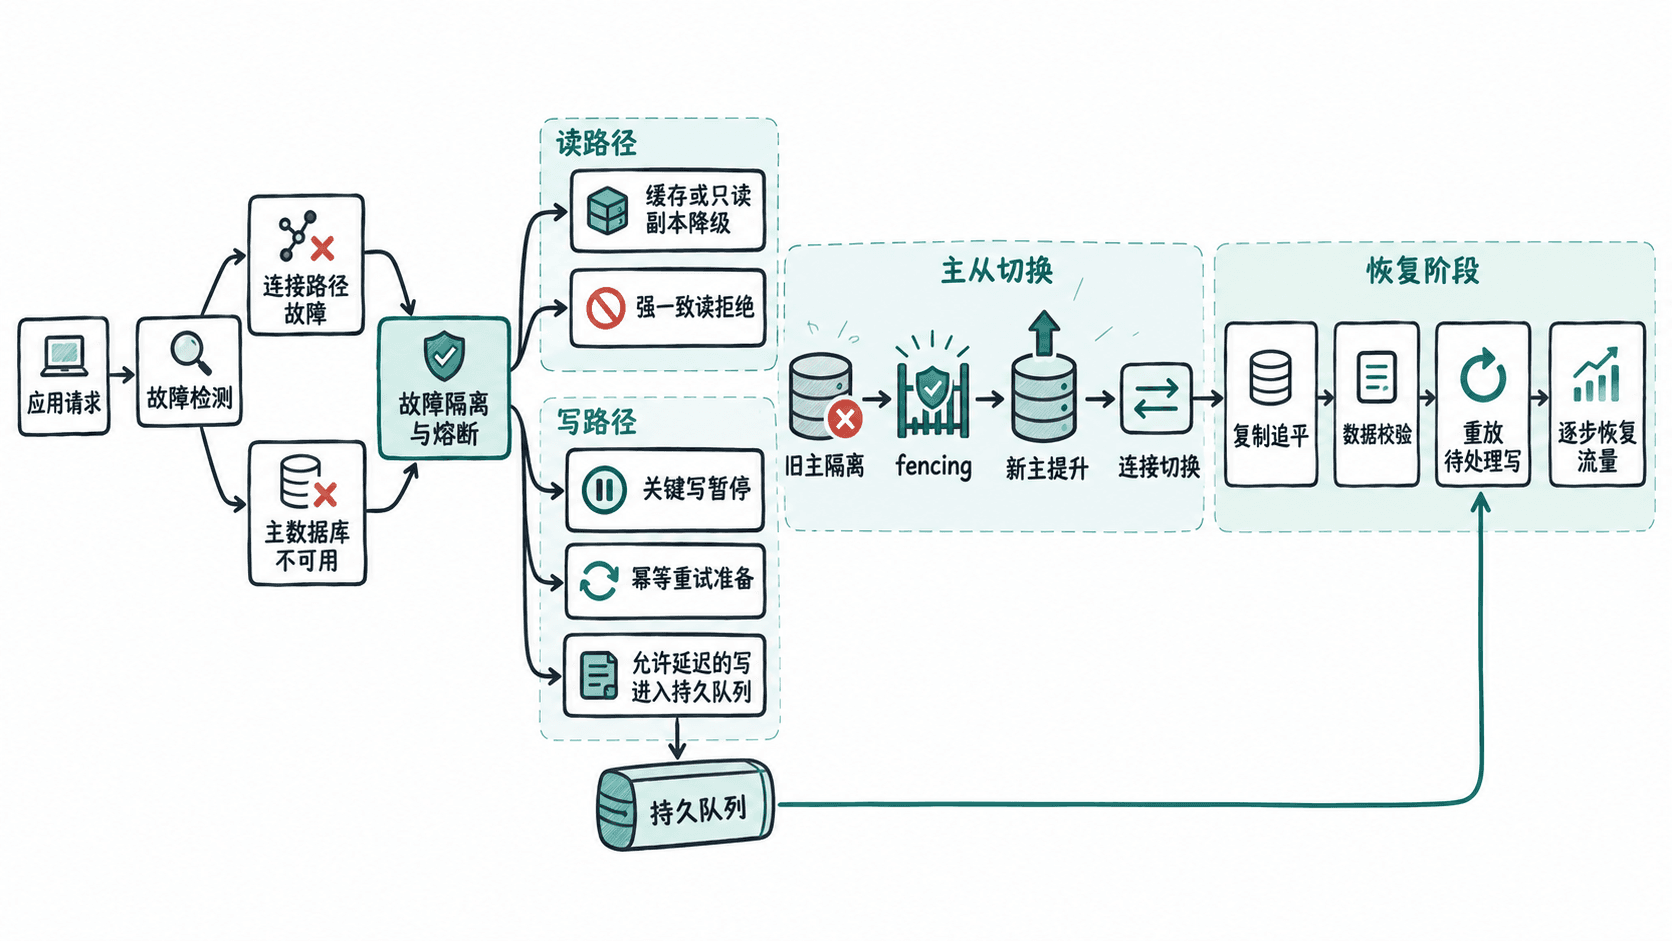
数据库故障时最危险的动作是让所有请求无限重试,因为这会把原本局部的故障放大为连接风暴。应用应快速失败并使用有限重试、指数退避和熔断,把资源留给健康检查与真正需要恢复的请求。
读请求是否还能继续,取决于数据新鲜度要求。如果业务允许短时间旧读,可以切到只读副本或缓存,并明确显示数据可能延迟;如果读结果参与余额、库存扣减等强约束判断,就不能把陈旧副本当作主库替代。
写请求更谨慎。无法确认主库提交结果时,不能盲目重放非幂等写入。安全做法是暂停关键写、保留幂等键或业务操作 ID,待新主库确认后再重试;部分非核心写可以进入持久消息队列,但前提是业务允许延迟落库。
切换必须解决主身份和数据边界
高可用数据库通常需要一个明确的主节点选举或故障转移机制。切换时至少要回答三个问题:谁宣布旧主失效、谁提升新主、如何阻止旧主恢复后继续接收写入。最后一个问题通常通过 fencing、租约或基础设施层隔离来避免脑裂。
数据库异步复制时还存在 RPO:新主可能缺少旧主最后一小段尚未复制的数据;同步复制可以缩小甚至消除这个窗口,但会增加写延迟与可用性约束。因此回答时要把“是否能丢数据”作为切换策略的前置条件,而不是默认所有系统都能自动无损切换。
恢复不是把旧主重新接回来
新主稳定后,恢复阶段要先确认复制拓扑、时间线或日志位置,再处理旧主。旧主通常需要重新加入为副本或重建,不能直接恢复写权限,否则可能制造分叉数据。
随后按顺序恢复业务:确认新主可写、检查关键表与最近事务、观察副本追平、重放允许延迟的写入、逐步撤销熔断和限流。对“提交结果未知”的请求,应依赖幂等键或业务唯一约束判断是否已经成功,而不是简单再次执行。
用降级目标回答不同业务
如果是内容浏览类系统,可以接受短时间旧读,数据库故障时优先维持读取;如果是支付、库存或额度系统,错误写入比短暂不可用更危险,应优先停止关键写。系统设计面试中最重要的是把可用性策略绑定到业务不变量:先保护不能被破坏的数据,再决定哪些能力可以降级继续提供。