
架构与系统设计 / 系统课时
缓存击穿和雪崩怎么答
缓存击穿和雪崩怎么答
回答缓存故障不能只背“加锁、随机过期时间”。更完整的思路是先指出流量怎样从缓存泄漏到数据库,再分别控制热点 Key、集中失效和缓存服务故障造成的放大效应。
学习目标
- 准确区分缓存击穿与缓存雪崩的触发条件和影响范围
- 从热点保护、失效时间和后端保护三个方向设计治理方案
- 用故障扩散链路组织一段完整的系统设计面试回答
先区分击穿和雪崩
缓存击穿通常围绕一个或少数热点 Key。例如一个热门商品每秒收到大量请求,它恰好过期后,许多并发请求同时发现缓存未命中,于是一起访问数据库。问题的核心是单个热点失效瞬间形成并发回源。
缓存雪崩的范围更大:大量 Key 在接近的时间集中失效,或者整个缓存集群不可用,导致原本由缓存吸收的大量请求同时转向数据库和下游服务。此时不仅是某个查询变慢,而是连接池、线程池、数据库 CPU 等资源可能连续被打满。
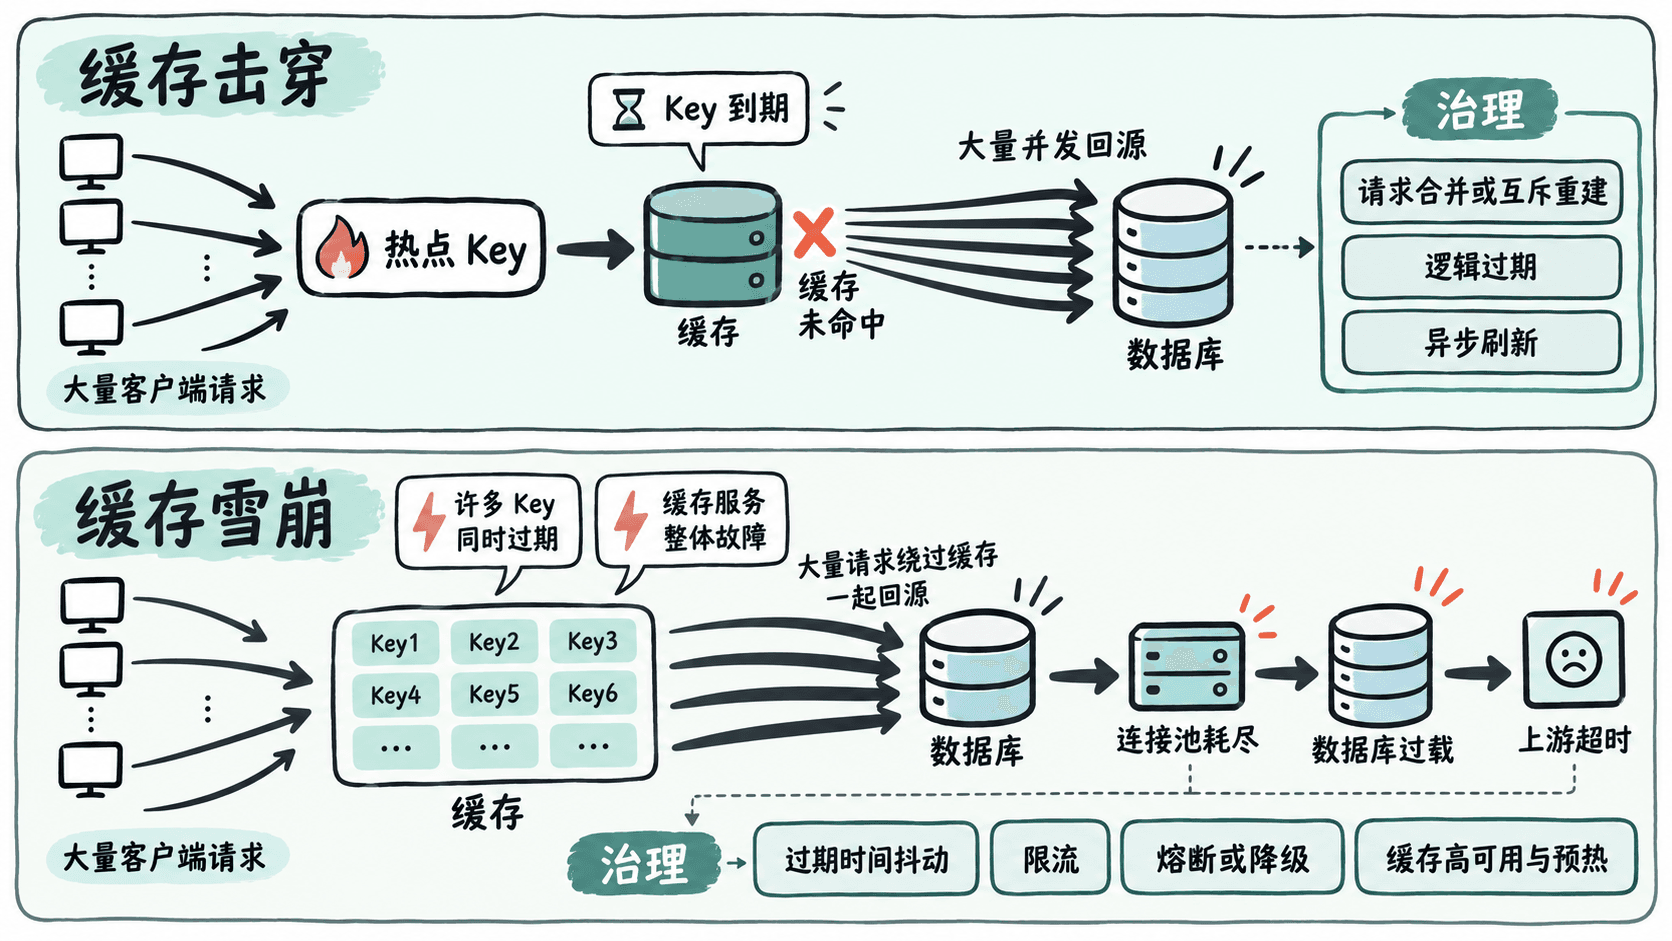
两者都表现为“缓存未命中后数据库压力上升”,但治理重点不同:击穿首先限制同一个热点的并发重建,雪崩首先限制大量失效同时发生以及故障继续向后端扩散。
热点 Key 要避免并发重建
最常见的做法是请求合并:第一个发现热点缓存失效的请求负责查询数据库并重建缓存,其他请求等待已有的重建结果,而不是各自访问数据库。单机可以使用进程内的 single-flight 思路,多实例部署则需要能覆盖多个实例的协调机制。
另一种方案是逻辑过期。缓存中的数据不立刻删除,而是同时保存一个业务上的过期时间。请求发现数据已逻辑过期时,可以先返回允许范围内的旧值,再由一个后台任务刷新缓存。这能把数据库回源移出用户请求的关键路径,但代价是必须接受短时间陈旧数据。
对于极少数长期热点,还可以不依赖自然过期,而由数据变更事件或定时任务主动更新。不过这种方案把复杂度从“缓存重建”转移到了“更新可靠性”,如果更新事件丢失,旧数据可能长期存在。
雪崩要同时处理失效时间和故障边界
如果大量 Key 都使用完全相同的固定 TTL,它们可能在批量写入后一起过期。常见治理方式是在基础过期时间上增加随机抖动,让失效时间分散,避免形成同一时刻的大规模回源峰值。
但随机 TTL 只能解决“集中到期”,无法处理整个缓存服务不可用。因此还需要保护数据库和下游:入口可以限流,应用可以限制并发回源,在数据库已接近容量上限时对非核心请求降级,而不是让所有请求无限等待后一起超时。
缓存自身也需要故障恢复能力,例如副本或故障切换、启动后的热点预热,以及容量恢复时逐步放量。如果缓存刚恢复就让所有流量立即回灌,可能再次形成新的负载尖峰。
用数字解释治理为什么有效
假设一个热点商品平时有 5000 QPS,缓存命中时数据库几乎看不到这些读取。Key 过期后若 5000 个请求都直接回源,即使持续时间很短,也可能瞬间耗尽数据库连接。请求合并后,同一轮通常只需要极少量重建请求,其他请求复用结果,压力等级完全不同。
雪崩则不能只盯一个 Key。假设缓存平时承担了数据库前方 90% 的读取,一旦整体不可用,数据库看到的流量可能迅速扩大到原来的数倍甚至更多。此时最重要的是依据数据库真实可承受的吞吐量限制回源,让部分请求快速失败或降级,也不要把整个系统拖入排队和超时。
把答案组织成一条故障链
面试时可以按照“触发条件 → 流量放大 → 后端保护 → 恢复方式”来回答。热点 Key 到期造成击穿时,采用请求合并、逻辑过期或主动刷新;批量过期时为 TTL 增加抖动;缓存整体故障时,再用限流、降级和数据库容量保护阻止故障继续扩散。
最后补上恢复阶段:缓存重新可用后进行热点预热并逐步恢复流量,同时观察缓存命中率、回源 QPS、数据库连接数和请求延迟。这样回答的重点就从零散的缓存技巧,变成了完整解释故障为什么发生、怎样被放大,以及怎样把影响控制在缓存层附近。