
架构与系统设计 / 系统课时
缓存放在哪一层最合适
缓存放在哪一层最合适
缓存不是越靠前越好,也不是统一塞进一个分布式缓存就结束。系统设计时真正要回答的是:一次读取经过哪些节点、数据能否共享、允许多旧,以及缓存失效后由谁承担回源压力。
学习目标
- 区分本地缓存、分布式缓存和 CDN 分别解决的问题
- 根据数据共享范围、一致性和访问路径选择缓存位置
- 在面试中说明多层缓存的组合方式与失效边界
先按读路径决定缓存层
选择缓存位置时,可以先画出原始读路径,再判断哪一段成本最高。缓存越靠近用户,通常越能节省网络和后端资源;越靠近数据库,则越容易缓存私有、动态或需要统一管理的数据。
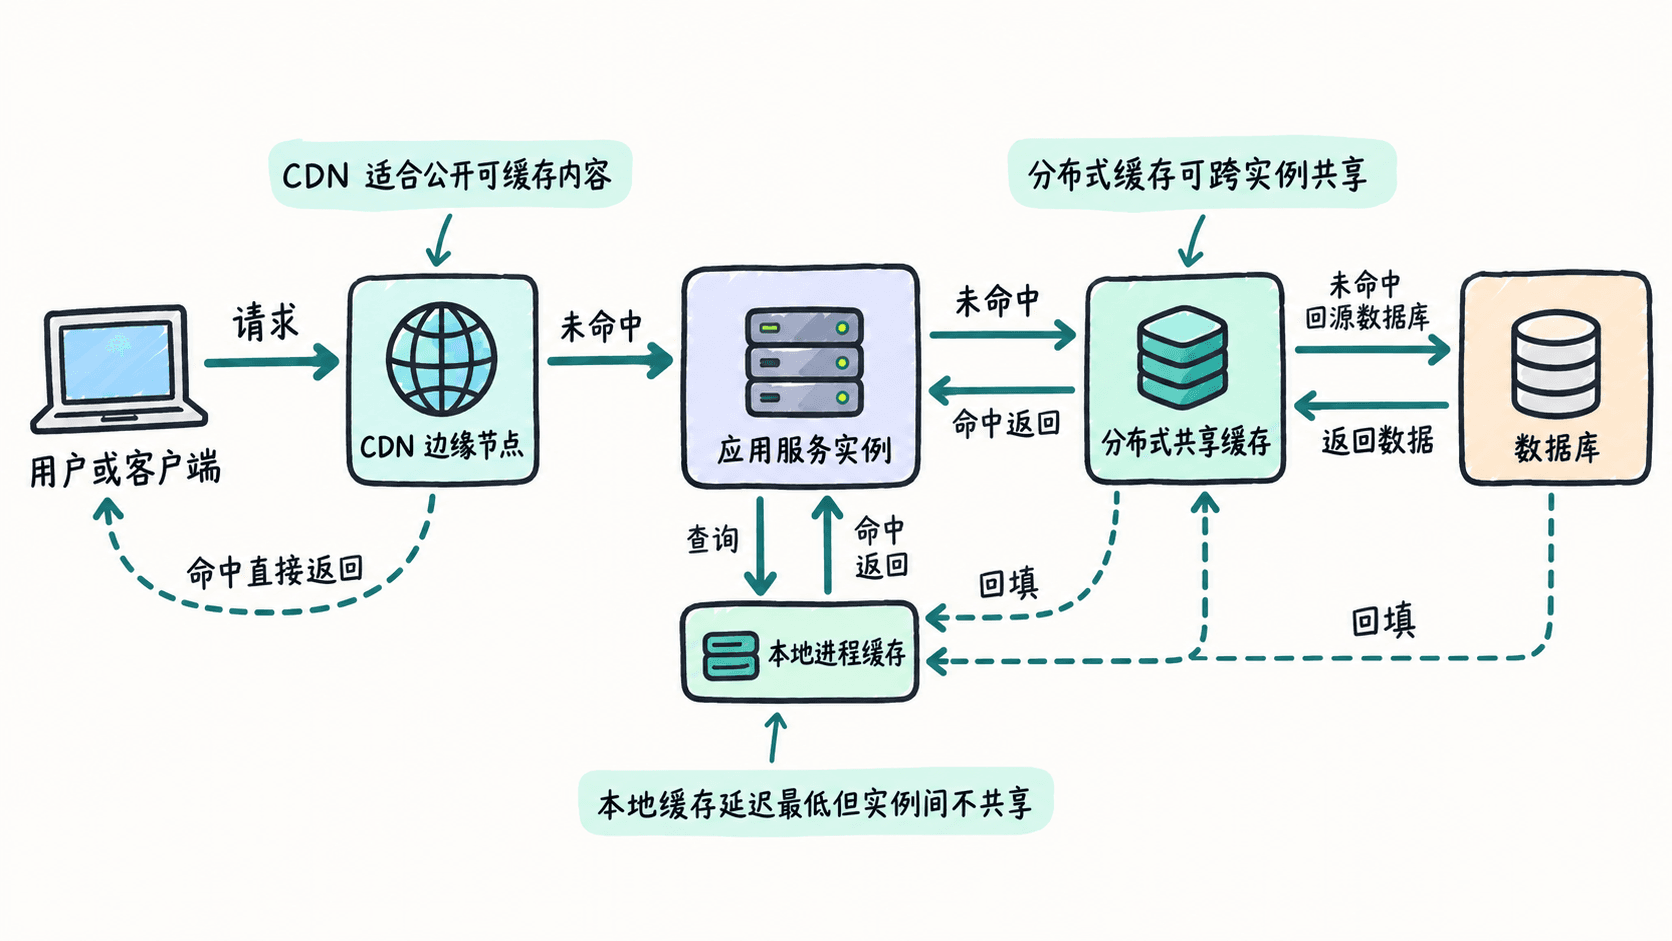
例如商品公共图片从源站跨地域传输成本高,CDN 最合适;应用反复读取几乎不变的配置项,本地缓存能省掉一次网络访问;多个服务实例都要读取同一份商品详情,则共享缓存更容易获得稳定命中率。
三类缓存解决的问题不同
| 缓存位置 | 主要优势 | 典型数据 | 主要边界 |
|---|---|---|---|
| CDN | 离用户近,可减少跨地域流量与源站请求 | 静态资源、公开图片、可公开缓存的 HTTP 响应 | 不适合随用户变化或不可公开的数据 |
| 本地缓存 | 无网络跳转,延迟最低 | 配置、字典、小型高频热点数据 | 多实例各有副本,更新和容量管理困难 |
| 分布式缓存 | 多实例共享,容量和过期策略可统一管理 | 商品详情、会话关联数据、计算结果 | 多一次网络访问,并引入缓存服务故障与一致性问题 |
本地缓存最大的风险不是“容量小”,而是副本分散。某条数据更新后,如果十个应用实例分别持有旧值,就需要接受短暂不一致,或设计通知与主动失效机制。因此它更适合体积小、热点高、允许短时间陈旧的数据。
分布式缓存位于应用和数据库之间,可以让所有应用实例共享同一份缓存结果。它适合数据库查询昂贵、读多写少且能够定义过期策略的数据,但不能把它当成数据库的无条件替代品:缓存不可用时,系统仍要考虑回源压力。
CDN 关注的是 HTTP 访问路径。资源能否放到 CDN,首先看响应是否可以按 URL、查询参数和必要请求头形成稳定缓存键,以及内容是否允许在边缘节点保存。强用户私有数据通常不应仅为了降低延迟就进入公共边缘缓存。
多层缓存通常可以同时存在
真实系统经常采用 CDN、本地缓存和分布式缓存的组合,而不是三选一。一次请求可能先在 CDN 命中;进入应用后,又先读本地热点;仍未命中才访问共享缓存,最后才查询数据库。
这种设计的关键是为每一层定义谁负责更新、多久允许旧、未命中去哪里。例如商品详情更新后,可以先更新数据库,再删除共享缓存;本地缓存设置更短的过期时间,使旧副本自动收敛。若业务要求极强一致性,就应减少缓存层级,而不是叠加更复杂的同步机制。
用四个问题收束选择
面对“缓存应该放在哪里”,可以依次回答四个问题:数据是否允许在用户附近公开缓存;是否需要跨应用实例共享;允许多长时间的旧数据;缓存失效后数据库能否承受回源流量。
如果内容公开且跨地域访问明显,优先考虑 CDN;如果数据只在单实例内高频重复读取且允许短暂陈旧,本地缓存成本最低;如果多个实例需要共享热点数据,分布式缓存通常是主力。最终方案不是选择缓存产品,而是让缓存位置与真实读路径、一致性要求和故障边界对应起来。