
架构与系统设计 / 系统课时
什么时候需要强一致
什么时候需要强一致
系统设计面试里,一致性不是“越强越好”。真正要判断的是:某个旧值被读到、两个请求并发写入,是否会直接破坏业务不变量。先把不能出错的约束说清楚,再决定哪些路径必须同步确认,哪些数据可以异步收敛。
学习目标
- 根据业务不变量判断强一致与最终一致的边界
- 识别读副本延迟对关键读取路径的影响
- 在面试中给出可解释的一致性取舍
先判断错误结果能不能被接受
强一致通常用在“错误一旦对外可见,就可能造成不可接受后果”的写入路径。例如同一笔资金不能扣两次、同一个唯一名额不能同时卖给两个人、订单不能从已取消状态重新变成已支付状态。
判断时不要先问数据库支持什么,而应先写出业务不变量。例如库存系统真正的要求可能是“可售库存不能小于 0”。如果两个并发扣减都读取到库存为 1,然后分别写回 0,就会违反这个约束,因此扣减过程必须由事务、条件更新或其他并发控制机制保护。
相反,点赞数、浏览量、搜索索引、推荐特征等数据短时间出现旧值,通常不会破坏核心业务。允许几秒甚至更长的传播延迟,可以换取更好的扩展性与故障隔离。
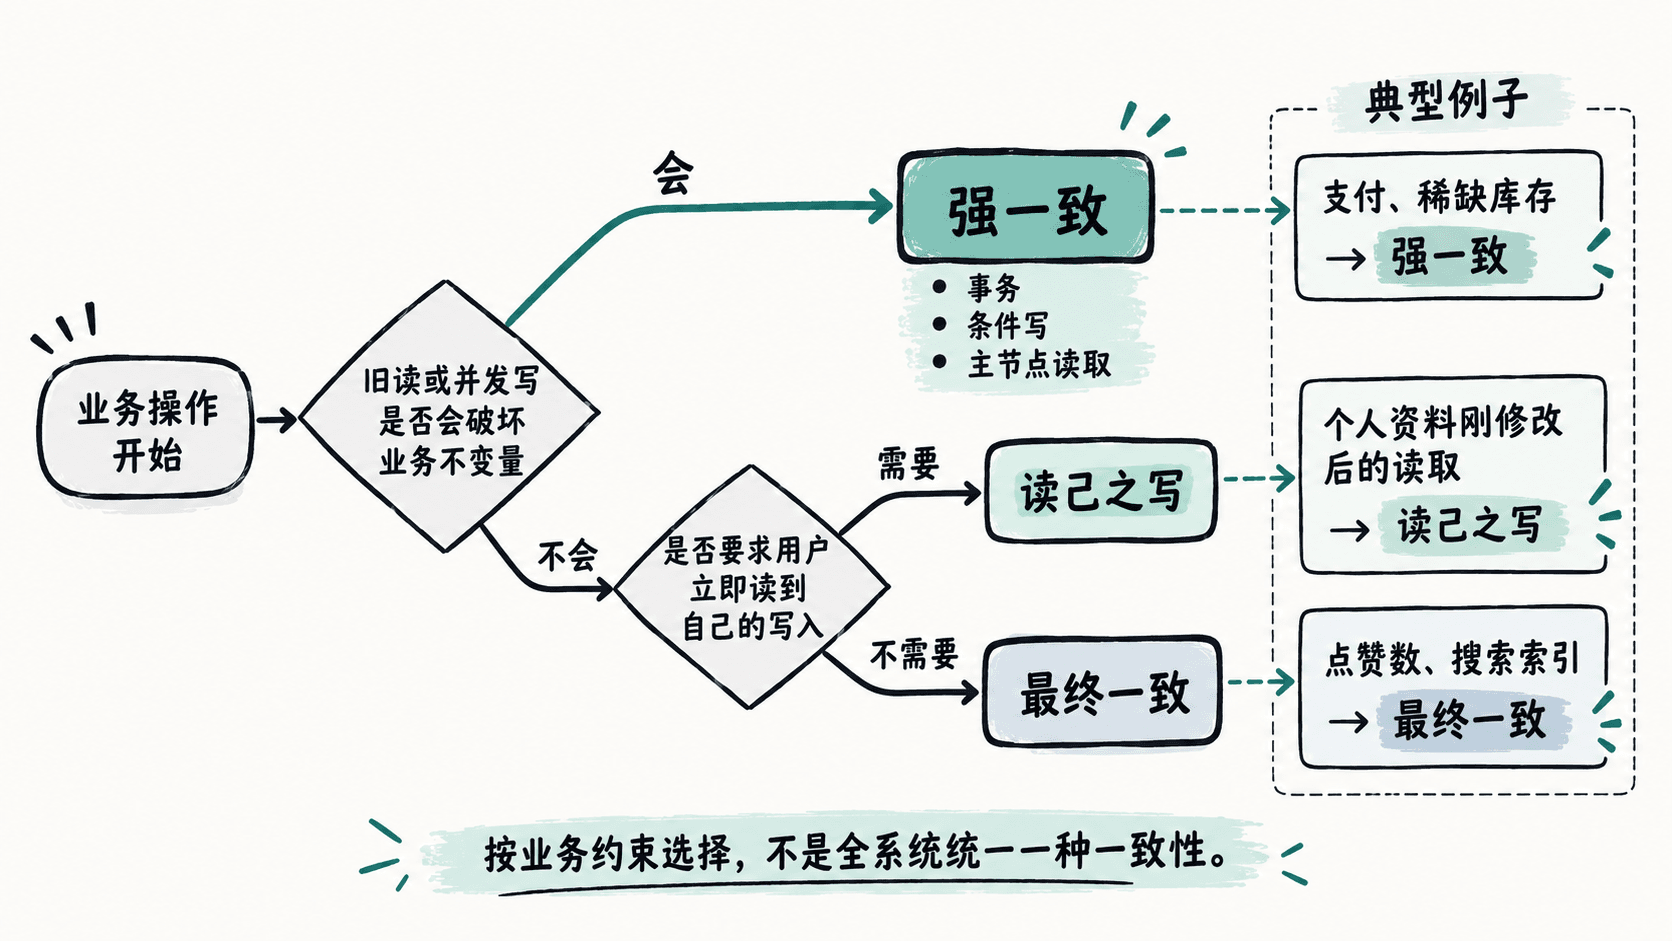
强一致不等于所有数据都走一条路
一个系统可以只让关键状态转换保持强一致,同时让派生数据最终一致。订单创建和支付状态可以在权威数据库中同步提交;订单搜索索引、统计报表和消息通知则通过事件异步更新。这样既保护核心约束,也避免为了非关键数据扩大同步链路。
面试中可以用下面的维度快速区分:
| 场景 | 主要风险 | 常见选择 |
|---|---|---|
| 余额扣减、唯一名额分配 | 并发结果违反不变量 | 强一致写入 |
| 用户刚修改资料后立即查看 | 读到自己的旧数据 | 读己之写 |
| 点赞数、统计报表 | 短暂旧值通常可接受 | 最终一致 |
| 搜索索引、推荐特征 | 更新允许延迟传播 | 最终一致 |
读写分离最容易暴露读取一致性问题
读写分离通常让写请求进入主库,查询进入只读副本。副本复制存在延迟,因此用户刚提交修改后马上查询,可能仍看到旧值。这不是读写分离本身错误,而是读取路径提供的一致性级别与业务预期不匹配。
常见处理方式是只升级关键读取路径:写入后的短时间内读取主库;携带数据版本并等待副本追上指定版本;或者让关键对象始终从权威节点读取。普通列表页仍然可以使用副本,以保留读扩展能力。
因此,“用了读写分离就只能最终一致”并不准确。更好的回答是明确哪些查询容忍复制延迟,哪些查询需要读己之写或更强保证,再分别路由。
面试时把一致性讲成约束和代价
回答一致性追问时,可以按“业务不变量 → 失败后果 → 所需保证 → 实现范围 → 性能代价”的顺序展开。例如支付确认必须避免重复扣款,因此权威支付状态需要原子更新;支付后的报表刷新可以异步完成,不必加入同步事务。
如果面试官继续追问可用性和延迟,就说明更强的一致性通常意味着更多同步协调,网络分区或节点故障时也可能需要拒绝部分操作。最终的设计目标不是让整个系统都最强一致,而是在会破坏业务正确性的最小范围内使用足够强的保证。