
架构与系统设计 / 系统课时
消息丢失和重复怎么处理
消息丢失和重复怎么处理
消息系统的可靠性不能只回答“加重试”。一次业务消息要经过生产、Broker 传输和消费三个阶段,每一段都可能丢失,也可能因为重试产生重复。本篇建立一套面试中可直接使用的分析框架,并说明幂等、确认、重试和死信各自解决什么问题。
学习目标
- 能按生产、传输、消费三个阶段定位消息丢失风险
- 能解释至少一次投递为什么必须配合消费幂等
- 能设计重试、去重和死信处理的完整闭环
先把一条消息拆成三个阶段
假设下单服务完成订单后发送 OrderCreated,库存服务收到事件再扣减库存。表面上只是一次发送和一次消费,实际上至少存在三段可靠性边界:生产者是否真的把消息交给 Broker、Broker 是否把消息可靠保存并投递、消费者处理完成后是否正确确认。
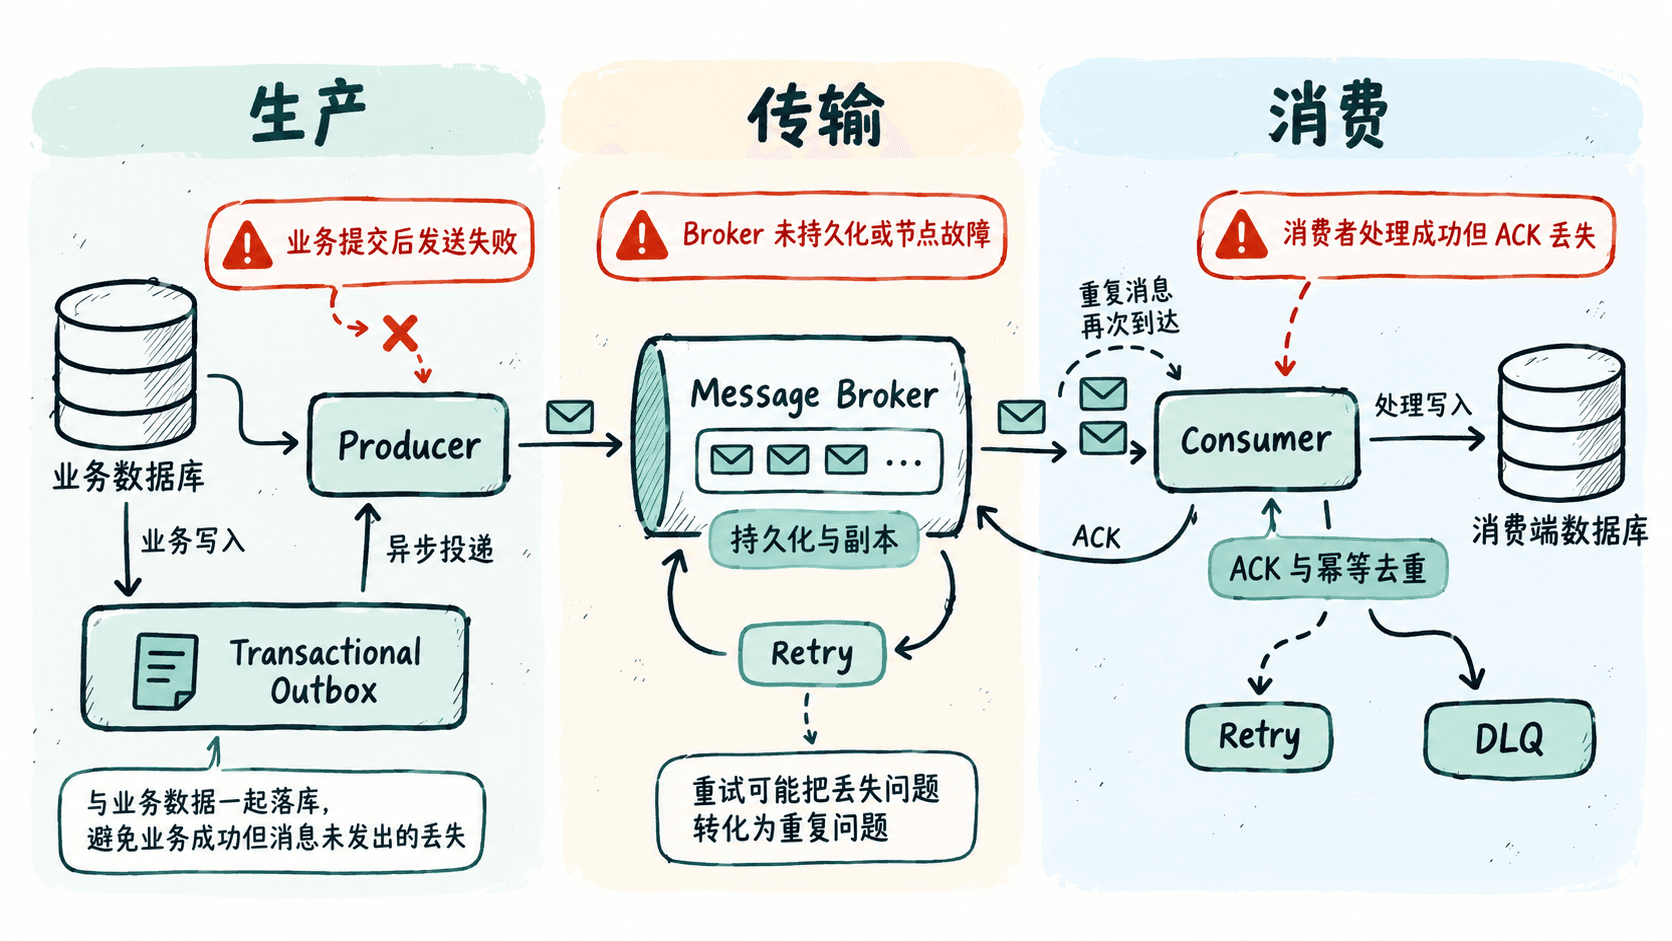
生产阶段最危险的情况是“数据库提交成功,但消息没发出去”。如果先写数据库再发消息,进程可能恰好在两步之间崩溃;如果先发消息再写数据库,又可能出现下游收到事件但订单最终没有提交。两次独立操作不能靠简单调整顺序获得原子性。
常见解决办法是 Transactional Outbox:业务数据和待发送事件写入同一个本地事务,再由独立发布器读取 Outbox 并发送。即使发送失败,事件仍留在数据库中,可以继续重试。这解决的是“业务状态与待发送消息一致”,而不是让网络发送本身变成绝不失败。
Broker 侧要解决持久化和确认
生产者调用发送接口成功,不一定等于消息已经安全落盘。可靠设计通常需要明确发送成功的判定条件,例如 Broker 已持久化消息,或者已经复制到满足要求的副本后才返回确认。
因此面试中不要只说“用了消息队列所以不会丢”,而要追问三个问题:生产者是否等待发送确认、Broker 是否持久化、单个 Broker 节点故障时消息是否仍有可用副本。吞吐量与确认强度往往存在取舍,关键业务消息通常更偏向可靠确认,而不是追求最低发送延迟。
消费者一侧也存在确认时机问题。若先 ACK 再写数据库,ACK 成功后消费者崩溃,消息不会再次投递,业务结果却没有落地;更稳妥的顺序通常是先完成业务处理,再 ACK。
重复不是异常,而是至少一次投递的正常结果
“处理成功后再 ACK”降低了丢消息概率,却引入另一种情况:消费者已经写库成功,但 ACK 在网络中丢失,Broker 会认为消费失败并再次投递同一消息。于是系统获得了 至少一次 的效果,同时必须接受重复消息。
因此消费端应围绕稳定的消息标识设计幂等。例如事件携带全局唯一 eventId,消费数据库建立唯一约束;处理前尝试登记该标识,已存在则说明事件已经完成过,不再重复执行扣款、发券或库存扣减等有副作用的操作。
业务本身天然幂等时,可以直接利用业务状态。例如“把订单状态设置为 PAID”重复执行可能没有额外影响;“余额减 100”则不是天然幂等,重复一次就会多扣一次钱。面试时应先识别副作用,再决定是否需要去重表、唯一键或条件更新。
重试必须有边界
瞬时网络错误、Broker 短暂不可用和下游超时通常值得重试,但无限立即重试会把局部故障放大成流量风暴。常见策略是限制次数,并使用指数退避和随机抖动,让失败请求逐步拉开间隔。
对于持续失败的消息,应在超过重试阈值后进入死信队列或失败存储,并记录消息 ID、失败原因和重试次数。死信不是“处理完成”,而是把自动重试无法解决的问题隔离出来,等待人工检查或专门的补偿任务重新处理。
重试前还要区分错误类型:连接超时、临时限流等通常可重试;格式错误、缺少必填字段等确定性错误反复执行也不会成功,应更快进入隔离流程。
面试时怎样把答案收束完整
一个完整回答可以从业务语义开始:先说明能否接受短暂延迟,接着说明生产端如何避免业务成功而消息丢失,Broker 如何持久化并确认,消费端为什么选择处理成功后 ACK,以及怎样用幂等抵御重复。最后补上有限重试、死信、监控和人工补偿,形成可恢复闭环。
不要轻易承诺“绝对不丢、绝不重复”或依赖一句“Exactly Once”结束讨论。跨数据库、Broker 和外部服务的链路通常仍存在多个故障边界。更可靠的设计目标,是让消息在失败后可重放,让重复执行无害,并且让无法自动恢复的事件可以被发现和补偿。