
架构与系统设计 / 系统课时
从零设计一个订单系统
从零设计一个订单系统
这场模拟的目标不是把电商所有能力都塞进一张图,而是在有限时间内完成范围澄清、容量估算、核心服务划分与下单主链路设计,并能解释库存、支付、幂等和失败恢复为什么这样取舍。
学习目标
- 用明确假设把订单系统的功能范围和容量边界收紧。
- 画出订单、库存、支付之间的职责边界与关键数据路径。
- 说明并发下单、重复请求和下游故障时的一致性与恢复策略。
先锁定范围和业务不变量
面试一开始先把“订单系统”缩成可完成的最小闭环:创建订单、查看订单详情与列表、取消未完成订单,并与库存和支付系统协作。商品搜索、营销推荐、物流履约可以作为外部能力,不在本题展开。
比功能列表更重要的是业务不变量。至少要明确三条:同一份库存不能被重复出售;一次下单重试不能生成多张订单;订单状态只能沿允许的方向变化,例如 CREATED 可以进入 PAID 或 CANCELLED,但已支付订单不能直接回到未支付状态。
还要主动声明假设。例如面试中可约定日活 200 万、每位活跃用户每天平均创建 2 次订单,读订单约为写订单的 10 倍,峰值流量按平均值的 6 倍估算。这些数字不是“标准答案”,作用是把后续架构决策变成可解释的结果。
用容量估算决定数据与流量入口
在上述假设下,每日创建订单约 400 万次,平均写入约 46 QPS,按 6 倍峰值约 280 QPS;读请求峰值约 2800 QPS。这个规模下没有理由一开始就分库分表,但需要为订单表准备稳定索引,并用缓存承担热点详情读取。
| 维度 | 假设 | 直接影响 |
|---|---|---|
| 创建订单 | 峰值约 280 QPS | 单主库可承载,先优化事务与索引 |
| 订单读取 | 峰值约 2800 QPS | 可对详情与最近订单做缓存 |
| 订单保留 | 长期增长 | 先按时间归档,再考虑分片 |
| 热点商品 | 流量可能瞬时集中 | 库存服务要支持原子扣减或预留 |
容量估算的价值不是算到个位数,而是排除过度设计。只有当写入、存储或单表索引已经成为持续瓶颈时,才进入分片讨论。
搭出核心架构和数据 ownership
订单服务只拥有订单数据;库存服务只拥有可售库存与预留记录;支付服务拥有支付单与支付状态。客户端经 API Gateway 进入订单服务,订单服务同步调用库存服务完成必要校验,再把支付、通知、履约等后续动作通过事件传递给下游。
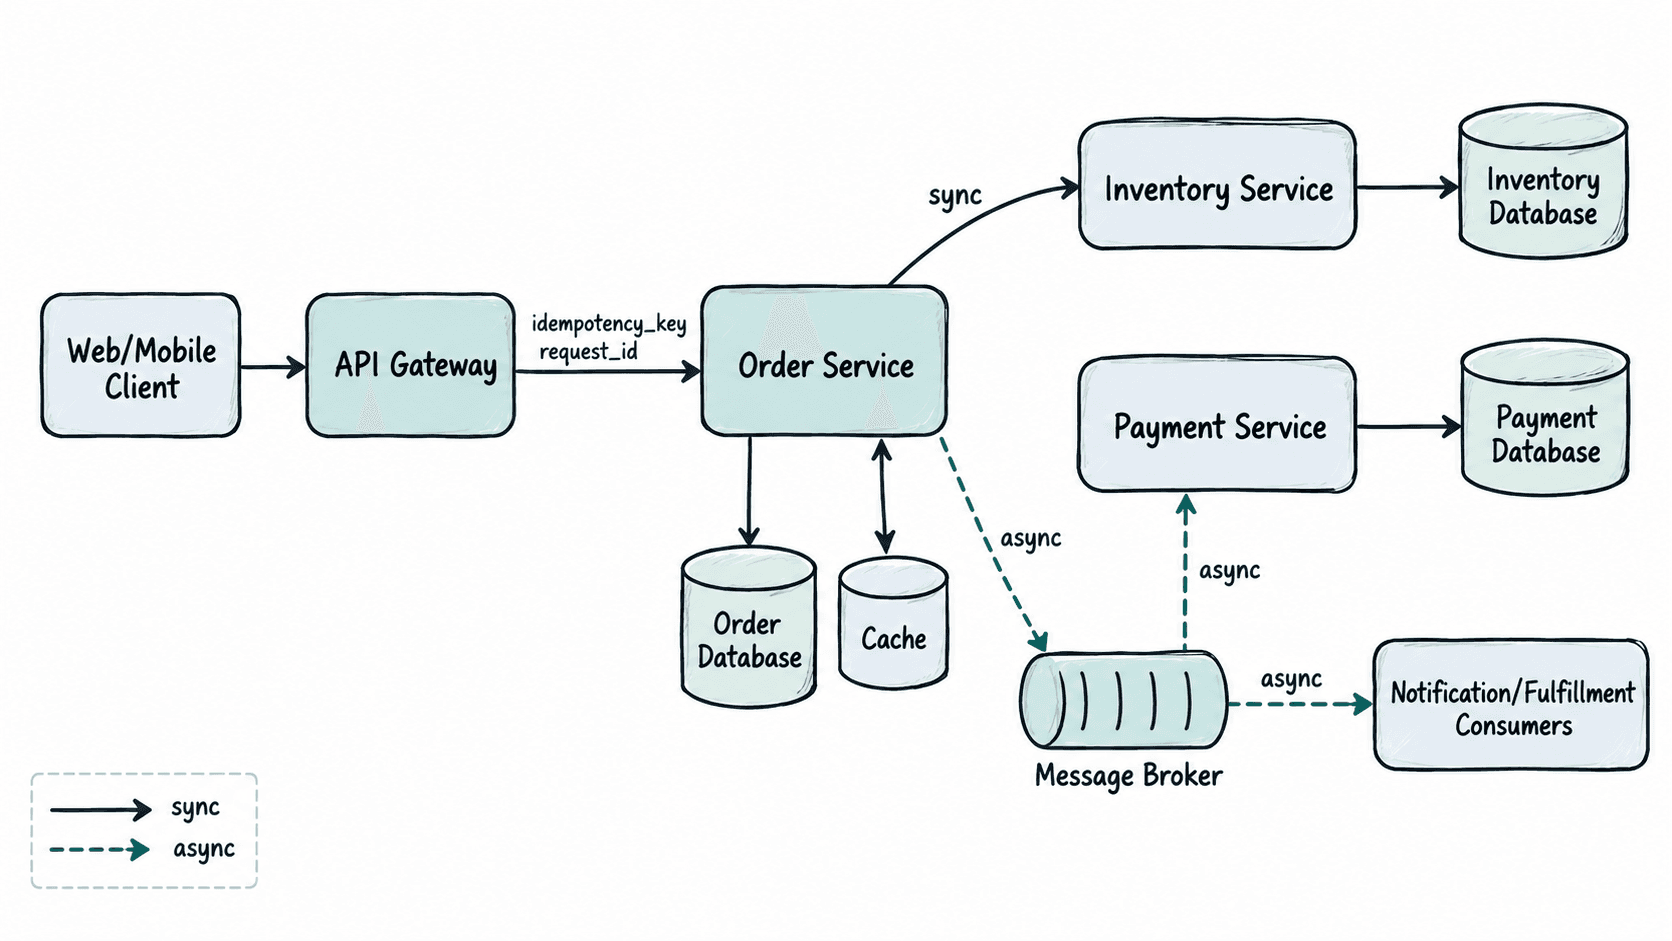
这里最容易答偏的是“为了事务方便让订单服务直接改库存表”。短期看调用少,长期会把两个领域重新耦合。跨服务协作应通过服务接口和业务协议完成,必要时接受短暂的中间状态,而不是把数据库共享当作一致性方案。
走通创建订单的关键路径
创建订单时,建议把真正必须同步成功的动作控制在最短路径里。客户端生成 idempotency_key,订单服务先检查该键是否已处理,再校验商品快照与价格,调用库存服务预留库存,随后在本地事务中写入订单、订单明细和待发布事件。事务提交后即可返回已创建订单,支付与通知继续推进。
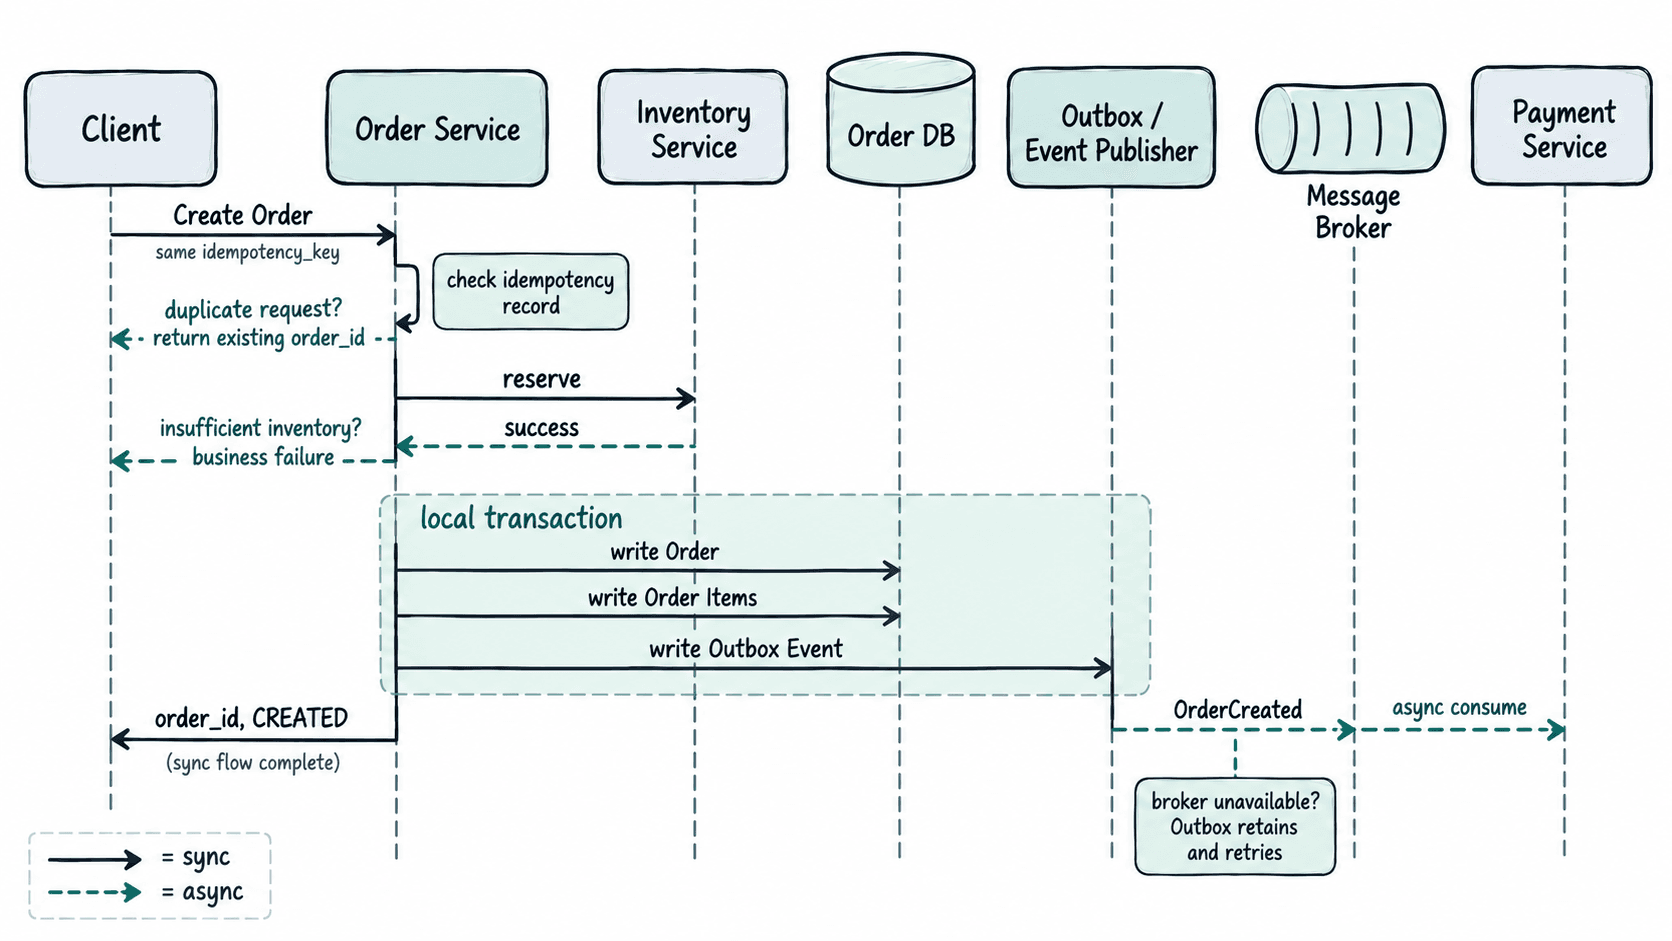
如果库存预留成功但订单事务失败,需要有释放预留的补偿动作;如果事件发布失败,则由 outbox 记录继续重试,避免“订单已提交但消息永久丢失”。这里的重点是把原子事务限制在单个服务数据库内,把跨服务一致性设计成可重试、可补偿的流程。
把一致性问题落到数据模型和状态机
订单表至少需要订单主键、用户 ID、金额、状态、创建时间和版本号;幂等表或唯一索引应约束 (user_id, idempotency_key),让并发重复请求最终由数据库唯一性兜底。订单列表常用 (user_id, created_at) 联合索引,避免为了“以后可能查询”而堆太多写放大索引。
状态更新要带前置条件,例如只有当前状态为 CREATED 时才能改成 PAID。应用层可以先判断,但最终还应依靠条件更新或版本号处理并发。这样即使支付回调重复到达,也只会有一次合法状态迁移。
面对约束变化时按瓶颈扩展:读流量暴涨先增加缓存和只读副本;订单历史迅速增长先做冷热归档;写入持续逼近单库上限再考虑按用户或订单维度分片;秒杀导致单商品热点时重点扩展库存预留与限流,而不是机械地把所有服务一起拆得更细。