
架构与系统设计 / 系统课时
短链接系统怎样设计
短链接系统怎样设计
短链接系统看起来只是把长 URL 变短,真正的设计难点却集中在短码唯一性、高并发跳转、热点缓存和访问统计上。本节从一次创建请求和一次跳转请求出发,把写入、读取、缓存与异步统计串成一套可扩展架构。
学习目标
- 设计不会轻易冲突且便于扩展的短码生成方案
- 拆分短链接创建路径与高并发跳转路径
- 用缓存、异步统计和分片策略处理热点访问
先把核心读写路径拆开
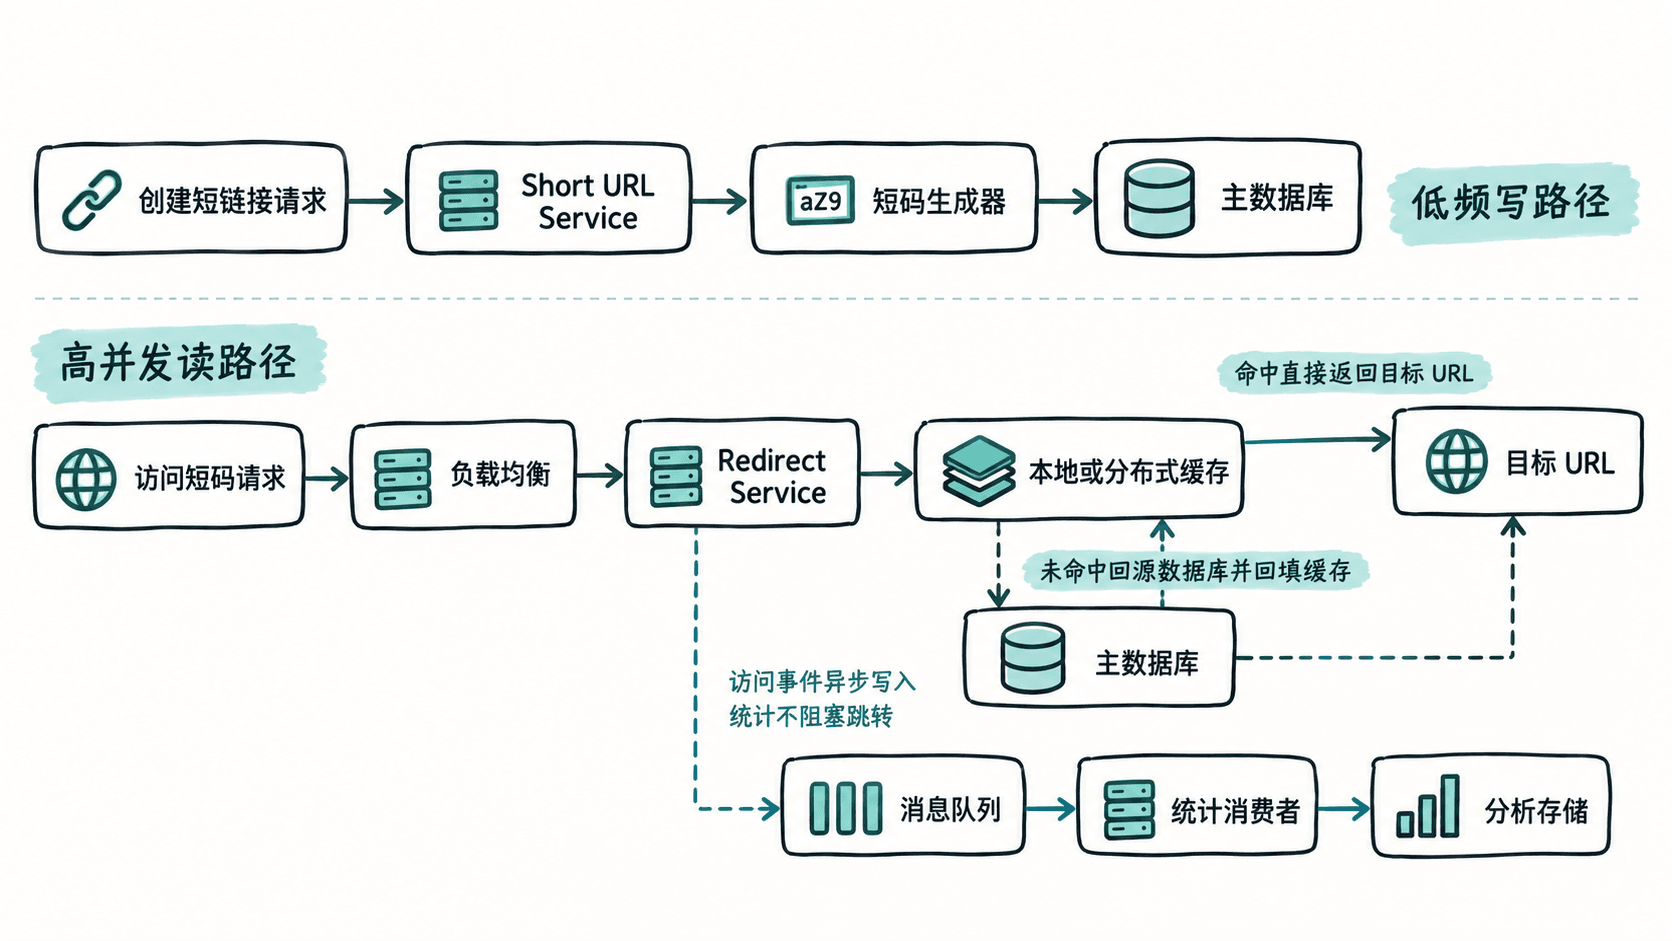
系统至少需要两个入口:创建短链接和根据短码跳转。创建通常是低频写操作,可以接受一次数据库写入;跳转则可能是数量级更高的读操作,延迟和可用性优先级更高。
创建时,服务接收原始 URL,生成唯一短码并保存 short_code -> long_url 映射。跳转时,根据短码找到目标 URL,然后返回 HTTP 重定向。访问日志和计数不应阻塞这条核心读取路径。
短码生成先解决唯一性
常见方案有随机字符串和全局 ID 编码两类。随机生成例如 7 位 Base62 字符串,实现简单,但必须检测碰撞;系统规模越大,重试和唯一约束越重要。全局 ID 方案则先得到一个唯一整数,再编码成 Base62,天然避免随机碰撞。
Base62 使用数字、小写字母和大写字母,共 62 个字符。7 位理论空间为 ,已经可以承载数万亿种组合,但实际设计不能只看空间大小,还要考虑是否允许顺序 ID 暴露业务规模。
如果直接把数据库自增 ID 转成 Base62,生成路径很简单,却容易让相邻短码呈现可枚举关系。面试中可以说明通过分布式 ID、随机扰动或加密置换降低这一问题,而不是为了隐藏 ID 引入复杂且难以维护的自定义算法。
跳转路径要围绕缓存设计
短链接的访问通常具有明显热点:少量热门链接可能获得绝大部分流量。因此跳转服务首先查询缓存,命中后直接返回目标地址;只有未命中时才访问数据库并回填缓存。
缓存键可以直接使用短码,例如 short:Ab3xYz7。热点键本身不会造成数据库压力,但可能让单个缓存分片或网络节点承受过高流量。极端热点可以增加进程内短 TTL 缓存,让请求先在应用实例内部消化一部分。
不存在的短码也要处理。攻击者连续请求随机短码时,如果每次都穿透到数据库,会形成缓存穿透。可对“确实不存在”的结果设置较短的负缓存 TTL,同时限制单客户端或单 IP 的异常请求速率。
重定向状态码需要结合产品需求选择:
| 状态码 | 浏览器含义 | 更适合的情况 |
|---|---|---|
301 |
永久重定向,客户端和中间层可能长期缓存 | 目标地址稳定且不需要精细统计 |
302 |
临时重定向,通常会再次访问短链服务 | 目标可能修改,需要持续经过服务端统计 |
多数需要运营统计和动态修改目标地址的短链接平台会优先使用 302,避免客户端长期绕过短链服务。
统计不要放进同步跳转事务
如果每次跳转都先更新数据库中的点击次数,再返回重定向,高流量短链会把一个计数行变成写热点,而且数据库抖动会直接增加用户跳转延迟。
更稳妥的方式是先完成 URL 查询和重定向,同时将访问事件写入消息队列。消费者异步聚合总点击量、时间窗口、来源、地区或设备等指标。统计链路短暂延迟不会影响主跳转路径。
访问事件通常允许至少一次投递,因此分析端要接受重复事件的可能性。需要精确去重时,可以为事件分配唯一 ID;如果业务只展示趋势或近似计数,则没有必要为了绝对精确牺牲吞吐量。
高并发下继续拆热点和容量
当单库无法承载映射规模时,可以按短码哈希分片,使不同短码均匀落到多个存储分片。因为跳转请求已携带短码,所以这种分片方式能够直接计算目标分片,不需要先做额外查询。
读扩展通常遵循“缓存优先、数据库兜底”的顺序,而不是一开始就增加大量读副本。缓存能吸收大部分重复访问,数据库主要承担缓存未命中、创建和修改操作。真正需要跨区域部署时,还要明确短链接修改后的传播延迟,以及远端缓存什么时候失效。
面试中可以把最终方案收束为两条关键链路:创建路径保证短码唯一并持久化,跳转路径以缓存为核心并把统计异步化。这样即使某个热门短链突然爆发流量,数据库和统计系统也不会轻易成为同步请求的瓶颈。