
架构与系统设计 / 系统课时
什么时候需要分库分表
什么时候需要分库分表
分库分表不是数据达到某个固定行数后的必选项,而是在单库经过索引优化、容量扩展和合理分区后,仍无法满足吞吐、容量或故障域要求时才值得引入。本篇建立一套判断顺序,把数据量、QPS、写入瓶颈和运维成本放到同一个决策中。
学习目标
- 区分“表很大”和“单库已经成为硬瓶颈”
- 用容量、吞吐和增长速度判断拆分时机
- 识别分库分表带来的路由、事务和运维成本
先证明单库真的遇到边界
需要拆分的信号通常不是某一个数字,而是多个约束同时出现。例如索引和 SQL 已经优化,CPU、磁盘 IOPS 或写入日志仍长期接近容量上限;数据增长使备份、恢复和索引维护窗口无法接受;或者热点写入集中在一个节点,继续升级单机的成本和收益已经失衡。
相反,单条慢 SQL、缺少索引、连接池配置错误或偶发流量峰值,都不应该直接推导出“必须分片”。这些问题即使放到十个分片上,也可能只是复制成十份。
容量判断最好使用压测得到的单节点持续能力,而不是数据库厂商的理论值。下面的小程序把目标峰值与团队自己测得的安全容量做比较。示例中的安全系数只是演示输入,应由实际压测、故障切换要求和资源余量决定。
measured_write_qps = 5000
safety_factor = 0.70
target_peak_write_qps = 4200

safe_write_qps = measured_write_qps * safety_factor
load_ratio = target_peak_write_qps / safe_write_qps

print(f"safe_write_qps={safe_write_qps:.0f}")
print(f"target_to_safe_ratio={load_ratio:.2f}")
print("capacity_pressure=" + ("yes" if load_ratio > 1 else "no"))
预期输出
safe_write_qps=3500
target_to_safe_ratio=1.20
capacity_pressure=yes
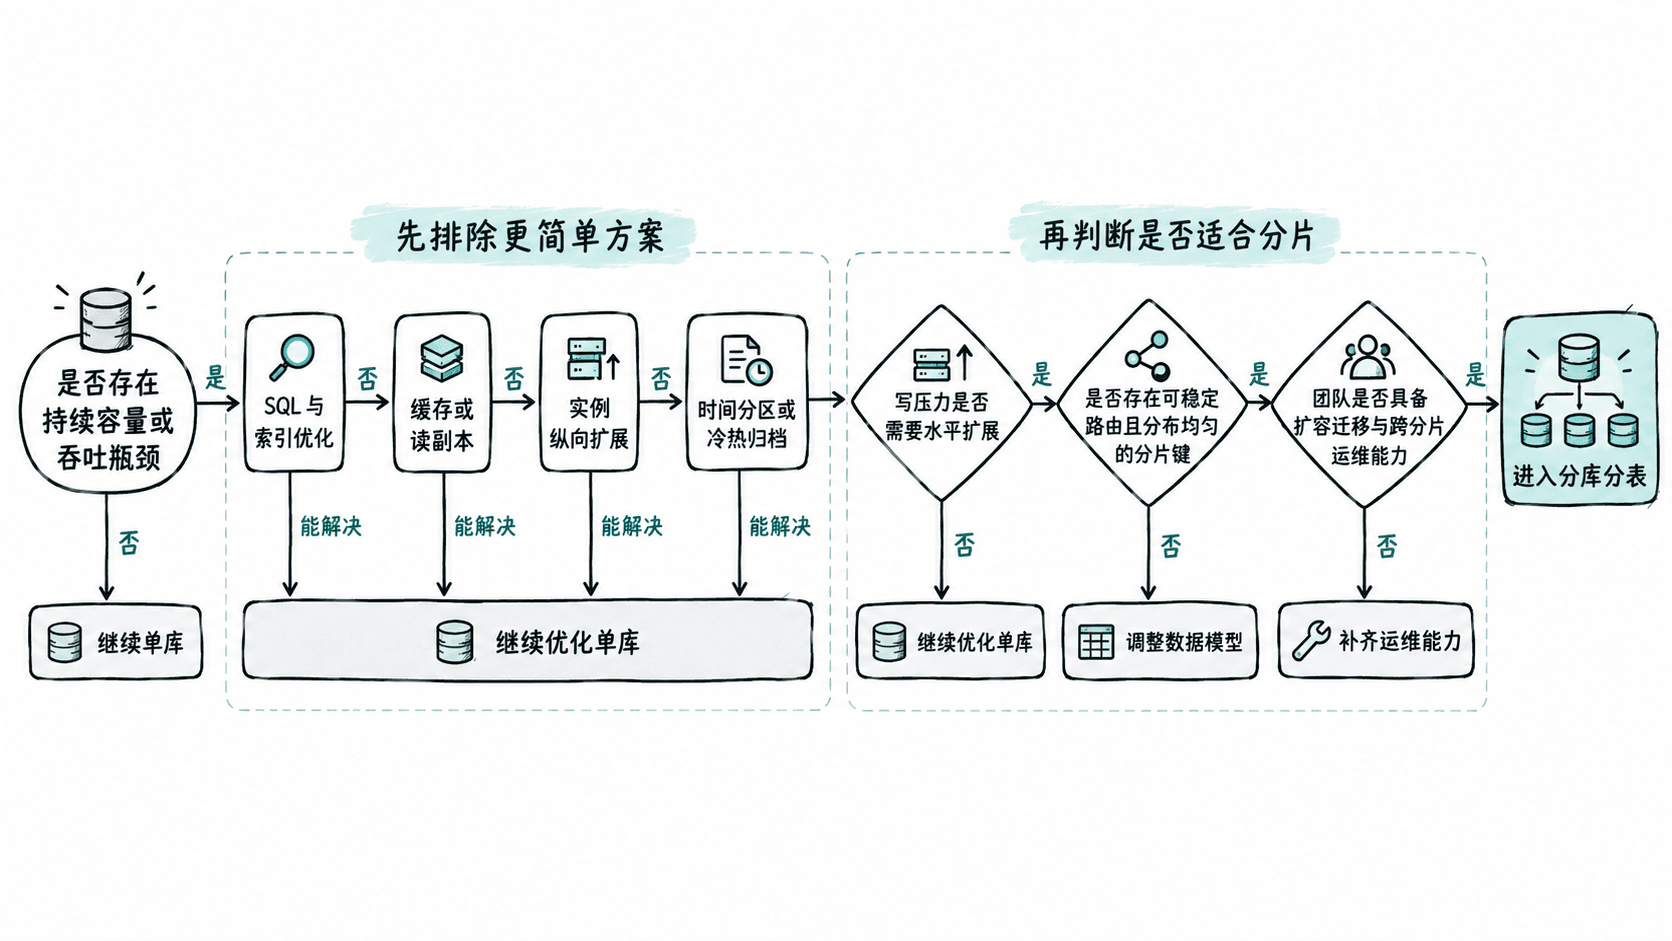
这个结果只能说明目标峰值已经超过当前定义的安全写入能力,不能单独证明应该分库分表。下一步还要判断能否通过减少同步写、升级实例、拆读副本、优化索引或调整业务模型消除瓶颈。
用四类信号判断拆分时机
可以把判断集中在四个方面。数据量关注的不只是行数,还包括索引大小、活跃数据集、备份恢复时间和未来增长速度;QPS 要区分读和写,因为读压力往往可以先通过缓存或只读副本分担,而持续写入更容易成为单主节点的上限。
写入压力还要看是否存在明显热点。如果绝大多数流量都集中到一个租户、一个热门商品或一个递增键区间,即使已经分成很多库,也可能继续把压力打到单个分片。此时需要先确认分片键是否真的能够把负载均匀分散。
最后是运维复杂度。分片会把一次简单数据库操作变成路由、扩容、数据迁移、跨分片查询和故障恢复问题。团队没有自动化迁移和可观测能力时,过早拆分往往会降低系统可靠性。
分片键决定拆分是否有效
真正开始设计分片时,最先问的不是“分成几张表”,而是请求能否根据一个稳定字段直接定位目标分片。例如按 user_id 分片适合绝大多数操作天然围绕用户展开的系统;如果大量请求必须按全局时间、商品或任意条件扫描,按用户分片就会制造大量跨分片查询。
好的分片键通常满足三个条件:高频请求能够携带它;取值分布足够均匀;业务生命周期内不会频繁变化。只满足“字段唯一”并不够,顺序订单号虽然唯一,却可能让最新写入持续集中到少数分片。
把拆分收益和代价一起回答
分库分表能把存储和读写负载水平摊到多个节点,但它会削弱单库天然提供的一些能力。跨分片事务需要重新设计一致性策略;全局唯一约束无法再简单依赖单张表;排序、分页和聚合可能需要从多个分片拉取结果再合并;扩容时还要迁移已有数据。
因此,面试中的合理答案通常不是“数据到一亿行就分表”,而是先给出当前负载与增长假设,再说明已经排除哪些更简单的方案,最后证明单节点存在持续硬瓶颈,并且业务拥有合适的分片键和足够的运维能力。只有这些条件同时成立,水平拆分才真正从一种复杂技术变成必要的容量方案。