
架构与系统设计 / 系统课时
建立个人答题模板
建立个人答题模板
系统设计题目千变万化,但高质量回答反复依赖少数固定判断:先澄清什么、怎样估量级、何时引入缓存或队列、故障发生时先看哪里。本节把这些重复决策整理成个人答题骨架,让模板帮助你保持主线,而不是把面试变成背诵标准答案。
学习目标
- 建立从需求澄清到深挖收束的个人答题骨架
- 整理可复用的估算规则、架构判断和故障模型
- 学会在不同题目中裁剪模板,而不是机械套用组件
模板保存决策顺序,不保存标准架构
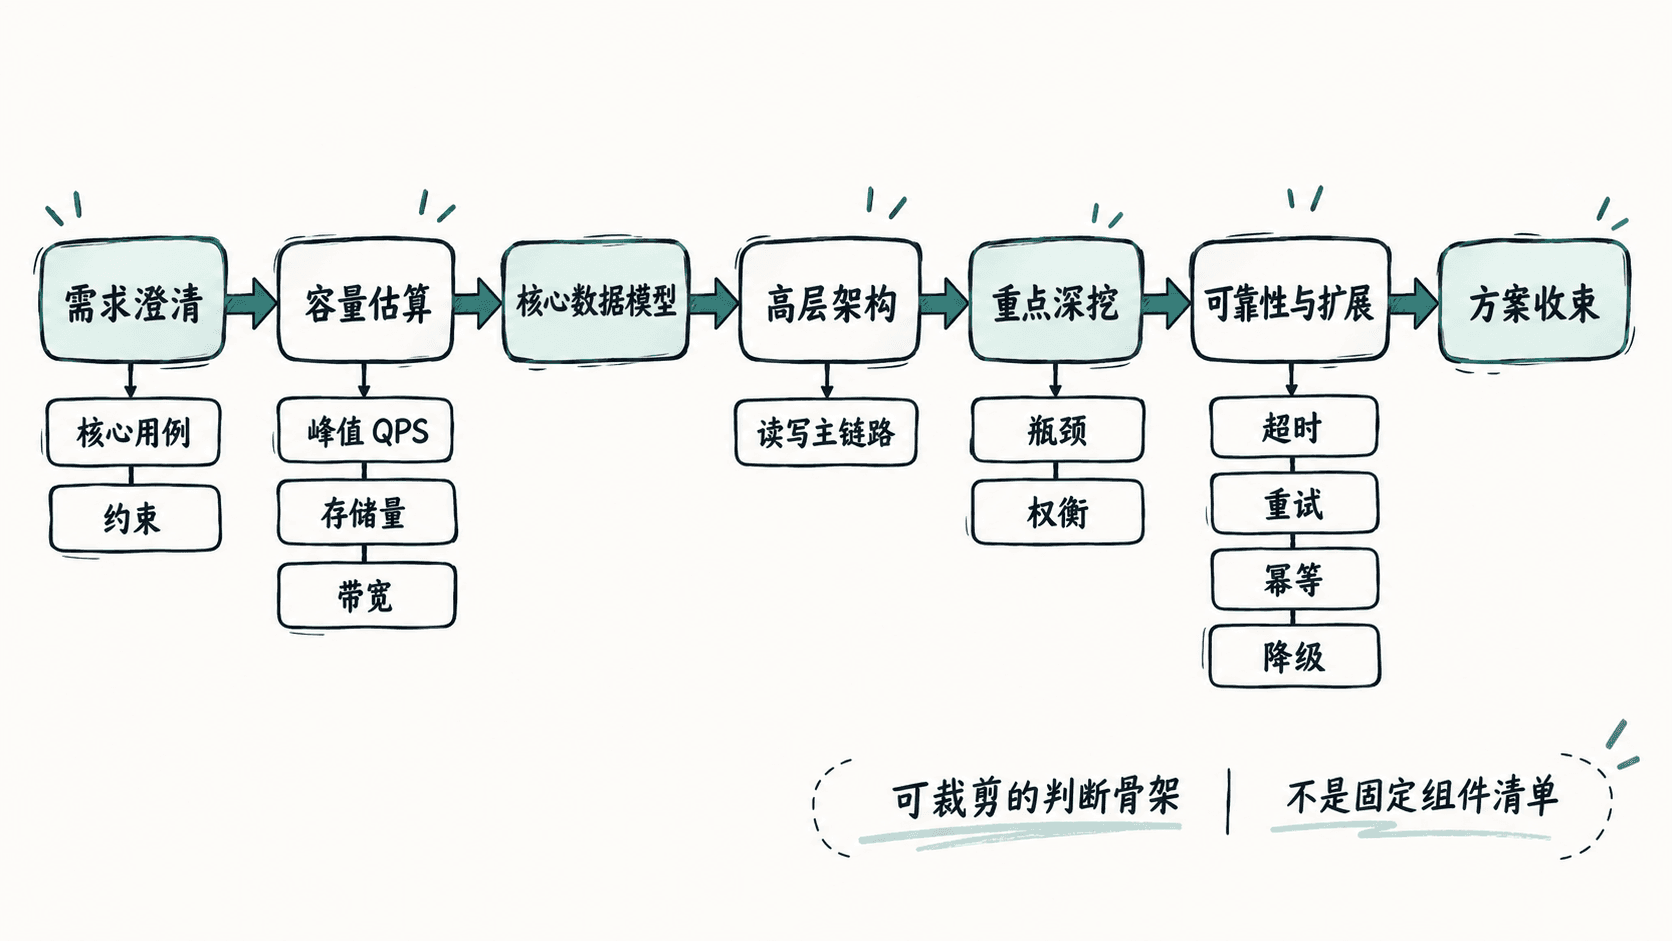
一个有效模板首先规定“按什么顺序思考”,而不是规定“必须出现哪些组件”。例如任何题目都可以先明确核心用例和约束,再做足够支撑决策的容量估算,然后画最短的端到端主链路,最后根据瓶颈或追问逐层展开。
如果模板写成“负载均衡、微服务、Redis、Kafka、分库分表”,它会诱导你无论规模和需求都堆相同组件。更好的写法是记录触发条件,例如“热点读导致数据库压力明显时评估缓存”“同步路径无法承受峰值或允许延迟处理时评估队列”。
把常用内容压缩成几张记忆卡
个人模板不需要写成完整教材。真正值得长期保留的是面试中需要快速调用、又容易遗漏的判断规则。可以把内容压缩为四组记忆卡。
第一组是需求检查。固定提醒自己确认核心用户动作、规模、读写比例、延迟目标、一致性要求,以及题目明确不要求解决的范围。问题不必全部询问,选择真正会改变架构的约束即可。
第二组是容量估算。准备少量常用关系,例如平均 QPS 来自每日请求量除以一天秒数,峰值再根据业务峰谷乘以合理系数;存储估算由新增记录数、单条大小和保留周期共同决定。模板记录公式和数量级,不记录某道题的固定答案。
第三组是架构判断。把常见机制写成“信号 → 选择”:读多且热点明显时考虑缓存,读扩展压力明显时考虑副本,写入可异步且需要削峰时考虑队列,单表持续接近容量或写吞吐边界时才进一步讨论分片。
第四组是可靠性模型。至少提醒自己检查超时、重试、幂等、部分失败、单点故障和降级路径。这样当面试官突然把问题从正常流程切到故障场景时,你仍然有稳定的检查顺序。
为深挖准备追问路径
模板还应包含几条可以向下展开的追问路径。面试官要求“再深入一点”时,不必随机挑技术细节,而是沿当前系统最可能的风险继续分析。
例如缓存可以继续追问缓存键、TTL、更新策略、击穿与雪崩;消息队列可以继续追问投递语义、重复消费、积压和死信;数据库可以继续追问访问模式、索引、事务、一致性、复制延迟和扩展边界。
这种组织方式的价值在于,同一套知识能够从主架构自然展开,而不是把背过的知识点强行塞进答案。面试官改变约束时,你也可以沿相同路径重新判断哪些设计需要变化。
用模拟题不断删改模板
个人模板应越练越短。第一次可以把提醒写得详细,但每完成一场模拟,都要检查哪些内容已经形成习惯、哪些提示从未帮助决策、哪些薄弱点仍频繁遗漏。
实际使用时,可以给自己设一个简单约束:开始答题前只看骨架,不看具体方案;完成高层架构后,再用检查项确认是否遗漏容量、数据流和故障路径。这样模板负责防漏,而真正的架构仍由题目的需求和约束决定。
当一套模板能够让你面对陌生题目时仍然稳定完成“澄清约束、估算量级、画清主链路、解释关键取舍、应对故障追问、及时收束”,它就已经完成任务。此后继续增加内容通常不如删除无效提示更有价值。