
架构与系统设计 / 系统课时
高并发数据表怎么建
高并发数据表怎么建
高并发表设计的关键不是先决定分区、分表或堆多少索引,而是先把最频繁的读写路径固定下来。本篇以订单表为例,从核心字段、联合索引、写放大和冷热数据四个角度,设计一张既能承受持续写入、又能稳定支持高频查询的表。
学习目标
- 根据真实访问模式确定核心字段和索引顺序
- 理解二级索引、随机写入与写放大之间的关系
- 判断哪些数据应留在热表,哪些适合归档或分区
先从访问模式倒推字段
系统设计面试里,看到“订单量很大”就直接讨论分库分表通常太早。应先明确最重要的访问模式,例如:用户查看最近订单、后台扫描待处理订单、按订单 ID 查询详情,以及持续创建新订单。
这些路径决定了表至少需要稳定的主键、业务过滤字段和时间字段。字段设计还要避免把高频更新但查询价值很低的大对象塞进主表,否则一条小状态更新也可能带来更多页写入、WAL 或复制流量。
下面使用 PostgreSQL 建一个最小订单表,并为两条高频查询分别建立联合索引和部分索引。
DROP TABLE IF EXISTS orders;

CREATE TABLE orders (
    id bigint GENERATED ALWAYS AS IDENTITY PRIMARY KEY,
    user_id bigint NOT NULL,
    status smallint NOT NULL,
    amount_cents integer NOT NULL CHECK (amount_cents >= 0),
    created_at timestamptz NOT NULL,
    updated_at timestamptz NOT NULL
);

CREATE INDEX idx_orders_user_created
    ON orders (user_id, created_at DESC, id DESC);

CREATE INDEX idx_orders_pending_created
    ON orders (created_at, id)
    WHERE status = 0;

INSERT INTO orders (user_id, status, amount_cents, created_at, updated_at) VALUES
(1001, 1, 2599, '2026-10-01 09:00:00+00', '2026-10-01 09:05:00+00'),
(1002, 0, 8800, '2026-10-01 09:03:00+00', '2026-10-01 09:03:00+00'),
(1001, 0, 4200, '2026-10-01 09:10:00+00', '2026-10-01 09:10:00+00');

SELECT id, user_id, status, amount_cents
FROM orders
WHERE user_id = 1001
ORDER BY created_at DESC, id DESC
LIMIT 20;
预期输出
 id | user_id | status | amount_cents
----+---------+--------+-------------
  3 |    1001 |      0 |        4200
  1 |    1001 |      1 |        2599
idx_orders_user_created 的列顺序直接对应“按用户过滤,再按时间倒序翻页”的查询。把 id 放在最后还能在时间相同时提供稳定排序。待处理订单只占全部订单的一部分时,部分索引则能避免为已完成数据维护同样规模的索引。
控制索引带来的写放大
高并发写入时,每增加一个二级索引,插入和部分更新就多维护一棵索引结构。索引并非越多越安全:一个低频报表查询如果换来了所有订单写入都多一次索引更新,整体吞吐反而可能下降。
设计时可以把索引分成三类:主链路必须使用的索引立即创建;低频运营查询优先交给分析库或离线任务;尚未证明有价值的组合索引先通过慢查询和执行计划确认,再决定是否增加。
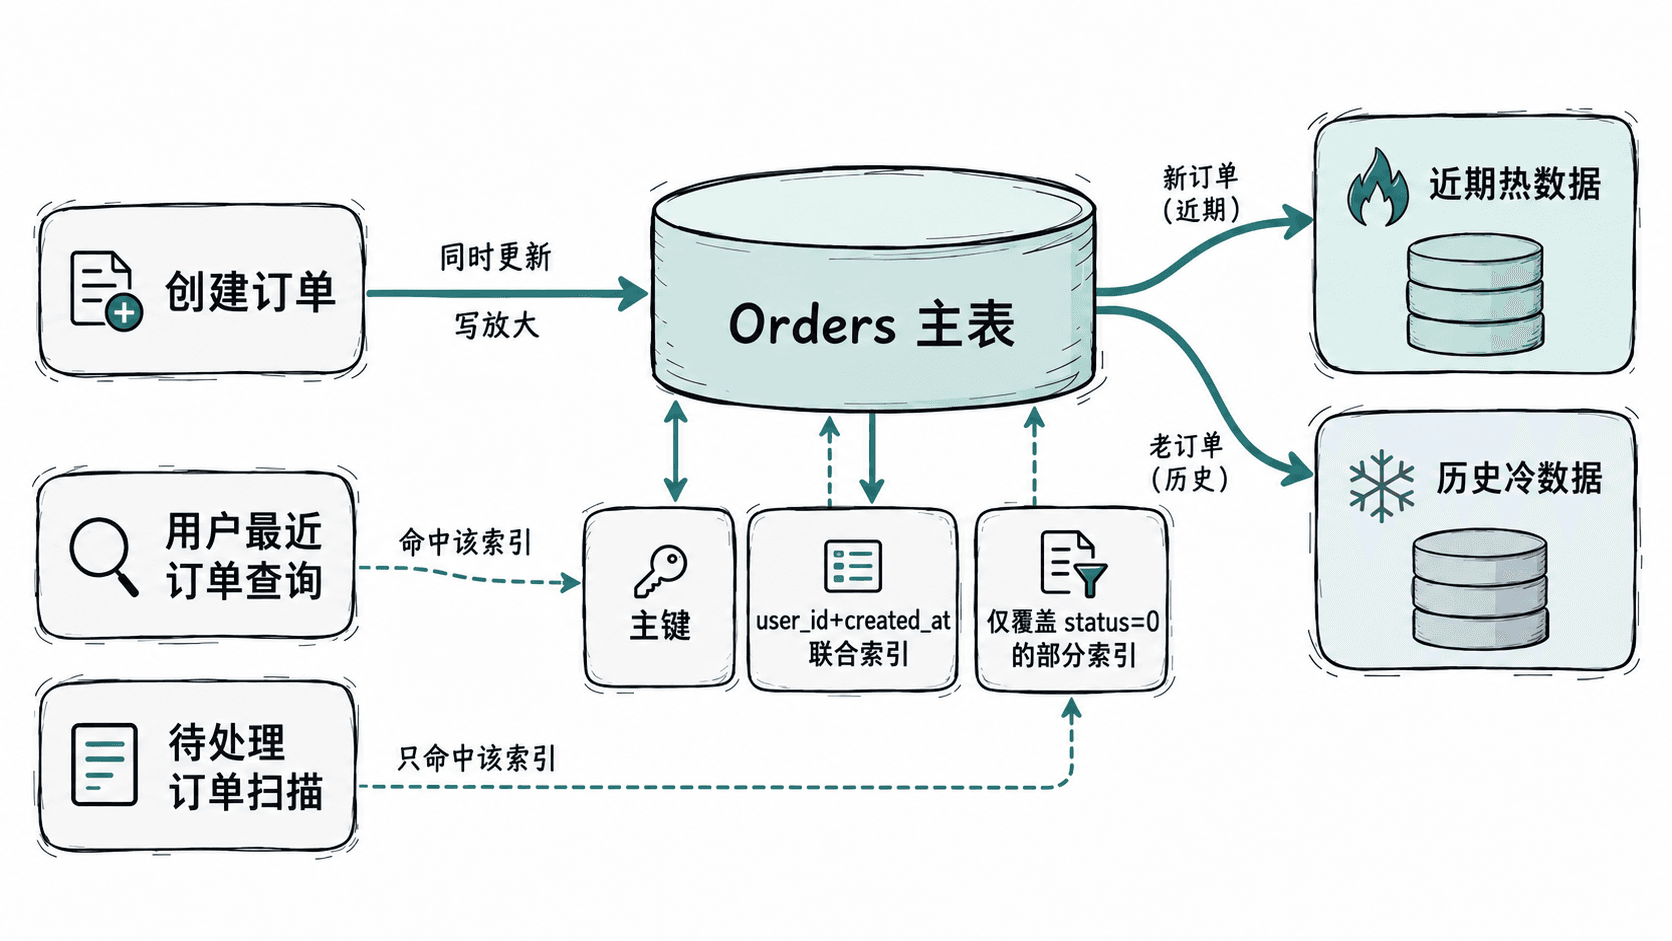
对于频繁变化的字段还要特别谨慎。例如订单状态不断变化,如果索引包含 status,每次状态迁移都可能产生额外索引维护。只有“按状态查询”确实处于核心链路时,才值得为这类字段支付写入成本。
把热点和冷数据分开考虑
表很大并不等于查询一定慢。只要核心查询能通过较小的索引快速定位数据,数亿行表也可能继续工作;真正危险的是活跃数据集不断膨胀,索引无法留在有效缓存中,同时备份、索引维护和历史扫描开始影响在线请求。
时间天然有生命周期的数据可以考虑按月或按日分区,但分区首先解决的是数据管理、裁剪和维护边界,不应被当作提升所有查询性能的万能手段。只有查询条件能够包含分区键,优化器才能有效排除无关分区。
更老的数据如果几乎不再参与在线交易,可以归档到成本更低的存储或分析系统,让主库重点维护近期活跃数据。这样通常比仅仅继续给一张无限增长的大表增加索引更可控。
让主写入路径保持简单
高并发写入路径最好只完成交易必须做的动作,例如写订单核心字段、维护必要索引并提交事务。搜索索引刷新、统计聚合、推荐特征和审计分析等派生工作,可以在业务允许时通过事件或变更数据捕获异步处理。
在系统设计面试中,一张高并发表设计得是否合理,可以用一个简单问题检查:每个字段、索引和同步写操作,是否都能对应到明确的核心访问模式或一致性要求。如果答案是否定的,它很可能正在消耗本不需要消耗的写入预算。