
游戏客户端架构 / 系统课时
排查帧率抖动
排查帧率抖动
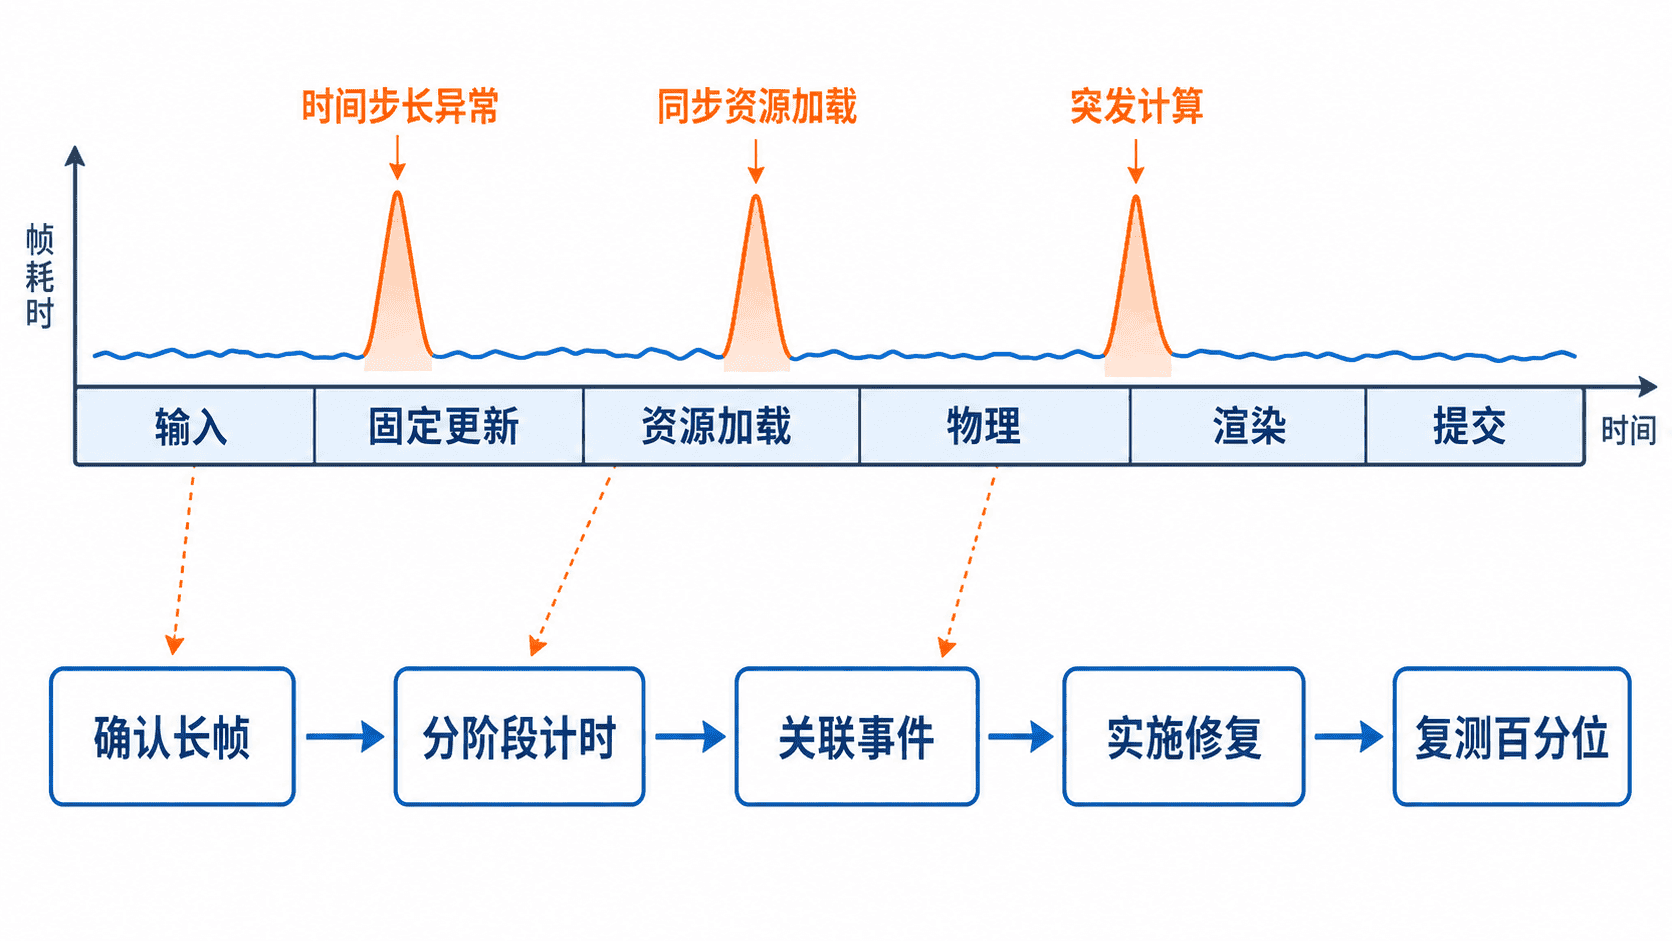
本课建立一套可重复的卡顿定位流程:先记录每帧各阶段耗时,再区分时间步长异常、同步资源加载和突发计算,最后用数据验证修复是否真正降低了长帧,而不是只提高平均帧率。
学习目标
- 用帧时间和分阶段计时识别长帧来源
- 区分时间步长、资源加载与突发计算造成的抖动
- 通过百分位和长帧次数验证优化结果
先确认抖动而不是低帧率
平均帧率低通常意味着持续负载过高,帧率抖动则表现为大多数帧正常、少数帧突然变长。以 60 FPS 为目标时,单帧预算约为 毫秒。平均值会掩盖偶发长帧,因此至少同时记录平均帧时间、最大帧时间、P95 或 P99,以及超过预算的帧数。
如果平均帧时间长期超过预算,应先降低稳定负载;如果只有 P99 和最大值异常,则继续定位偶发事件。两类问题的优化手段不同,不能只看 FPS 计数器下结论。
为每个阶段建立计时样本
下面的完整 C++ 示例使用固定样本模拟六帧数据,并找出超过 16.67 毫秒的长帧及其最耗时阶段。真实引擎中可将样本替换为高精度计时器采集的输入、更新、资源、物理和渲染耗时。
#include <algorithm>
#include <iomanip>
#include <iostream>
#include <string>
#include <utility>
#include <vector>

struct FrameSample {
    int index;
    double deltaMs;
    double updateMs;
    double resourceMs;
    double physicsMs;
    double renderMs;
};

int main() {
    const double budgetMs = 16.67;
    const std::vector<FrameSample> frames{
        {1, 16.4, 3.2, 0.1, 2.4, 7.8},
        {2, 16.6, 3.3, 0.1, 2.5, 7.9},
        {3, 41.8, 3.4, 25.0, 2.6, 8.1},
        {4, 16.5, 3.2, 0.1, 2.4, 7.7},
        {5, 29.6, 14.5, 0.1, 6.8, 7.6},
        {6, 16.7, 3.3, 0.1, 2.5, 7.9},
    };

    int longFrameCount = 0;
    for (const auto& frame : frames) {
        if (frame.deltaMs <= budgetMs) {
            continue;
        }

        ++longFrameCount;
        const std::vector<std::pair<std::string, double>> phases{
            {"update", frame.updateMs},
            {"resource", frame.resourceMs},
            {"physics", frame.physicsMs},
            {"render", frame.renderMs},
        };
        const auto worst = std::max_element(
            phases.begin(), phases.end(),
            [](const auto& left, const auto& right) {
                return left.second < right.second;
            });

        std::cout << "frame=" << frame.index
                  << " total=" << std::fixed << std::setprecision(1)
                  << frame.deltaMs << "ms"
                  << " bottleneck=" << worst->first
                  << "(" << worst->second << "ms)\n";
    }

    std::cout << "long_frames=" << longFrameCount << "\n";
    return 0;
}
保存为 frame_jitter.cpp 后编译并运行:
g++ -std=c++17 -O2 frame_jitter.cpp -o frame_jitter
./frame_jitter
预期输出:
frame=3 total=41.8ms bottleneck=resource(25.0ms)
frame=5 total=29.6ms bottleneck=update(14.5ms)
long_frames=2
这组结果说明第三帧由同步资源工作造成,第四帧正常,第五帧则需要继续拆分更新阶段。实际采样中的时间会随机器变化,应关注阶段占比和长帧关联事件,而不是要求毫秒值完全一致。
按来源继续缩小范围
时间步长异常通常来自窗口拖动、断点、系统调度或上一帧过长。应限制传入游戏逻辑的最大 deltaTime,固定步长更新还要限制单帧最多追赶次数,避免“长帧导致补算,补算又制造更长帧”的螺旋。
资源加载尖峰常伴随文件读取、图片解码、着色器编译或首次创建 GPU 资源。修复方向是预加载、后台读取、分帧上传和缓存复用;后台线程完成读取后,仍要测量主线程提交资源的耗时。
突发计算常见于一次性生成大量对象、全量寻路、粒子扩容、垃圾回收或容器重新分配。继续把异常阶段拆成更小区间,并记录当帧对象数、任务数、分配次数等事件计数,才能找到真正触发条件。
Tips:先给计时点和事件计数命名,再优化代码。没有可复现数据时,删除几行“看起来很慢”的代码通常只会转移问题。
修复后按同一场景复测
复测必须使用相同地图、相同资源和相同操作路径。对比修复前后的 P95、P99、最大帧时间和长帧次数;平均 FPS 上升但 P99 不变,说明持续负载降低了,偶发卡顿仍然存在。
还要确认优化没有改变正确性。例如限制固定更新追赶次数后,应检查角色移动、碰撞和动画在长帧后是否仍保持可接受的状态。性能修复只有在结果正确且尖峰减少时才算完成。
本课总结
- 帧率抖动要看百分位、最大值和长帧次数,不能只看平均 FPS
- 分阶段计时结合当帧事件计数,才能区分时间步长、资源和突发计算问题
- 修复后必须在同一场景复测,并同时验证性能与逻辑正确性
下一课预告
下一课将为数学、资源路径、序列化和碰撞算法建立基础自动化测试,让引擎修改后能快速发现回归。