
游戏客户端架构 / 系统课时
批量提交精灵
批量提交精灵
本课把“每个精灵调用一次绘制”改造成按渲染状态合并提交的批处理流程。完成后,你将得到一个可运行的最小批处理器,并能判断何时应刷新批次、如何验证 Draw Call 是否真正下降。
学习目标
- 理解批量提交降低 CPU 到 GPU 提交开销的原因
- 能按纹理、混合模式等状态构造批次边界
- 能用 Draw Call、批次大小和状态切换次数验证优化效果
批处理如何减少提交
一个精灵通常只包含少量顶点,但一次绘制调用仍需要在 CPU 侧检查状态、绑定资源并向图形 API 提交命令。若场景有 1000 个精灵且逐个提交,即使几何数据很少,也可能产生 1000 次 Draw Call,瓶颈会先出现在命令提交而不是像素计算。
批处理不是“把所有精灵一次画完”,而是把渲染状态兼容的精灵写入同一组顶点缓冲区,再用一次绘制调用提交。状态不兼容、缓冲区已满或一个渲染阶段结束时,才刷新当前批次。
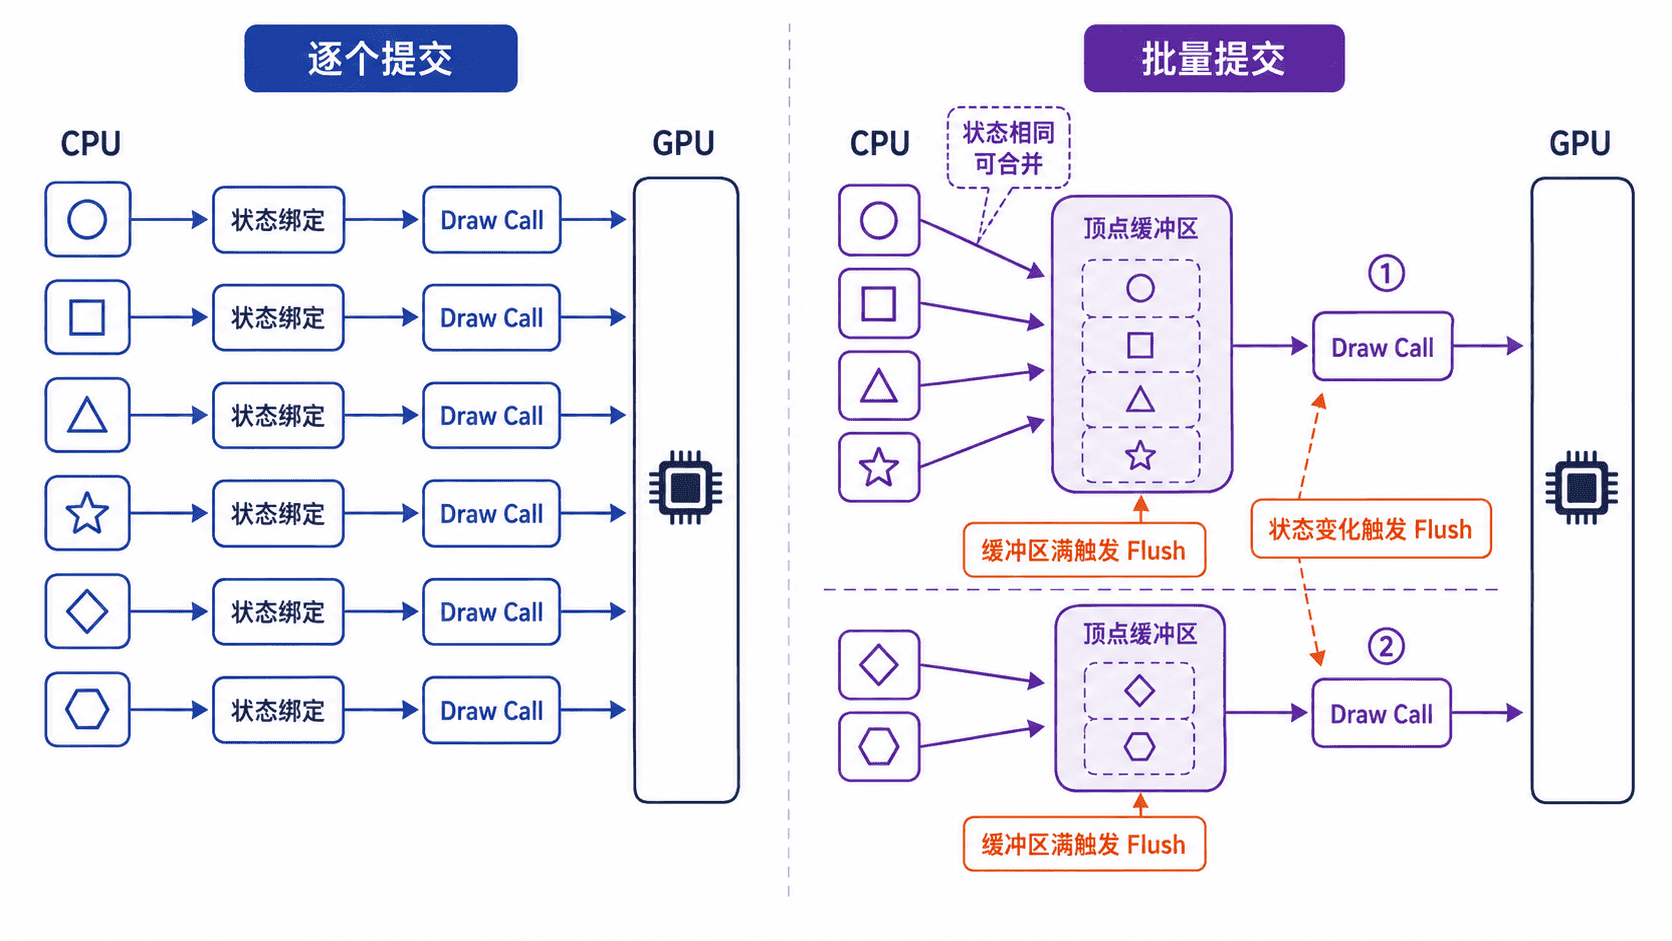
批次键应包含会影响同一次绘制结果的状态。二维精灵系统常见的批次键包括纹理图集、着色器、混合模式、裁剪区域和渲染目标。只要其中一项发生变化,就必须先提交旧批次,再开始新批次。
| 条件 | 是否刷新 | 原因 |
|---|---|---|
| 纹理、着色器和混合模式都相同 | 否 | 可以共享同一次状态绑定 |
| 纹理或混合模式变化 | 是 | 同一 Draw Call 无法使用两套不兼容状态 |
| 顶点或索引缓冲区已满 | 是 | 必须腾出空间后继续写入 |
| 一帧或一个渲染阶段结束 | 是 | 确保剩余数据被真正提交 |
透明精灵还要保持正确顺序。批处理不能随意重排所有对象,否则半透明叠加结果会改变。常见做法是先按渲染层排序,再只合并相邻且状态相同的精灵。
最小可运行实现
下面的 C++17 示例不调用具体图形 API,而是完整模拟批次键比较、容量检查、刷新和 Draw Call 统计。把 flush() 中的日志替换为真实的缓冲区上传与绘制命令,就能接入 OpenGL、Direct3D 或其他后端。
#include <iostream>
#include <optional>
#include <string>
#include <vector>

enum class BlendMode {
    Alpha,
    Additive
};

struct Sprite {
    std::string name;
    std::string texture;
    BlendMode blend;
};

struct BatchKey {
    std::string texture;
    BlendMode blend;

    bool operator==(const BatchKey& other) const {
        return texture == other.texture && blend == other.blend;
    }
};

class SpriteBatch {
public:
    explicit SpriteBatch(std::size_t capacity) : capacity_(capacity) {}

    void begin() {
        // 每帧开始时清空待提交数据和统计值。
        pending_.clear();
        currentKey_.reset();
        drawCalls_ = 0;
    }

    void submit(const Sprite& sprite) {
        BatchKey nextKey{sprite.texture, sprite.blend};

        // 状态变化或缓冲区已满时,先提交旧批次。
        if (currentKey_ &&
            (!(*currentKey_ == nextKey) || pending_.size() == capacity_)) {
            flush();
        }

        if (!currentKey_) {
            currentKey_ = nextKey;
        }

        pending_.push_back(sprite);
    }

    void end() {
        // 阶段结束时提交不足一个满批次的剩余精灵。
        flush();
        std::cout << "draw calls: " << drawCalls_ << '\n';
    }

private:
    void flush() {
        if (pending_.empty() || !currentKey_) {
            return;
        }

        const char* blendName =
            currentKey_->blend == BlendMode::Alpha ? "Alpha" : "Additive";

        std::cout << "flush texture=" << currentKey_->texture
                  << ", blend=" << blendName
                  << ", sprites=" << pending_.size() << '\n';

        ++drawCalls_;
        pending_.clear();
        currentKey_.reset();
    }

    std::size_t capacity_;
    std::size_t drawCalls_ = 0;
    std::vector<Sprite> pending_;
    std::optional<BatchKey> currentKey_;
};

int main() {
    SpriteBatch batch(3);
    batch.begin();

    batch.submit({"hero", "atlas-a", BlendMode::Alpha});
    batch.submit({"enemy", "atlas-a", BlendMode::Alpha});
    batch.submit({"coin", "atlas-a", BlendMode::Alpha});
    batch.submit({"effect", "atlas-a", BlendMode::Alpha});
    batch.submit({"panel", "atlas-b", BlendMode::Alpha});
    batch.submit({"glow", "atlas-b", BlendMode::Additive});

    batch.end();
    return 0;
}
预期输出:
flush texture=atlas-a, blend=Alpha, sprites=3
flush texture=atlas-a, blend=Alpha, sprites=1
flush texture=atlas-b, blend=Alpha, sprites=1
flush texture=atlas-b, blend=Additive, sprites=1
draw calls: 4
示例中 6 个精灵被合并为 4 次提交。若把容量从 3 提高到 4,前四个精灵可合并为一个批次,Draw Call 会进一步降为 3;但容量越大并不必然越快,还要考虑缓冲区内存、上传量和排序成本。
验证与关键边界
先记录优化前后的精灵数量、Draw Call、状态切换次数和 CPU 渲染耗时。精灵数量相同且画面一致时,Draw Call 应明显下降;若次数没有变化,通常是纹理过于分散、混合模式频繁切换,或提交顺序阻止了相邻对象合并。
不要只观察平均帧率。批处理主要减少 CPU 提交开销,在 GPU 已经满载时提升可能有限。更可靠的验收方式是确认批次统计符合预期,并用图形调试器检查一次 Draw Call 是否确实包含多个精灵的顶点和索引。
批处理还必须处理缓冲区容量、透明排序和纹理数量限制。发现画面错层、纹理串用或最后一批未显示时,应优先检查排序是否稳定、批次键是否完整,以及阶段结束时是否执行了 flush()。
本课总结
- 批处理通过合并相同渲染状态的精灵,减少 Draw Call 与状态绑定次数
- 状态变化、缓冲区满和阶段结束是最常见的刷新条件
- 优化必须同时验证画面顺序、批次统计和 CPU 渲染耗时
下一课预告
下一课将进入资源管理系统,明确资源标识、加载、缓存、引用和释放之间的职责边界,为纹理图集和其他渲染资源提供统一管理基础。