
C / C++ / 系统课时
实现一个可压测的并发 TCP 服务
实现一个可压测的并发 TCP 服务
这节课直接完成一个可运行的 Linux TCP 回显服务:它用长度帧解决粘包拆包,用 epoll 管理并发连接,用高低水位做背压,并通过结构化日志、压力客户端和限时排空验证稳定性与退出行为。
学习目标
- 实现带 4 字节长度前缀、连接级缓冲区和协议上限的 TCP 服务。
- 用
epoll在非阻塞读写中正确处理半包、短写与应用层背压。 - 通过突发并发压测、日志计数和
SIGTERM验证吞吐、错误率与优雅退出。
把服务目标收敛成验收约束
本实验把业务处理刻意简化成“收到一帧就原样回一帧”,这样压测结果主要反映网络事件循环和连接状态管理。每帧格式为 4 字节网络字节序长度 + payload,payload 最大 4096 字节;超过上限的连接直接关闭,避免恶意长度导致无限制分配。
一个连接同时维护输入缓冲区、输出缓冲区和 read_paused 状态。输出队列达到 32 KiB 高水位时移除 EPOLLIN,降到 16 KiB 低水位后再恢复读取。这里使用两个水位而不是一个阈值,是为了形成滞回,避免读事件在临界值附近频繁开关。
验收时至少看三件事:压测 errors=0;服务端处理帧数与客户端完成帧数一致;发送 SIGTERM 后不再接收新连接,并在最多 3 秒内尝试发送已经排队的响应。吞吐和尾延迟是环境相关数据,只用于同机基线或改动前后对比。
协议帧、连接状态与背压如何协作
TCP 是字节流,单次 recv 可能只得到半个帧,也可能一次得到多个帧,所以协议解析不能依赖读取次数。服务端先把字节累积到输入缓冲区,只有“4 字节头 + 完整 payload”都到齐后才生成响应;send 写不完时则保留剩余字节,等待下一次 EPOLLOUT。
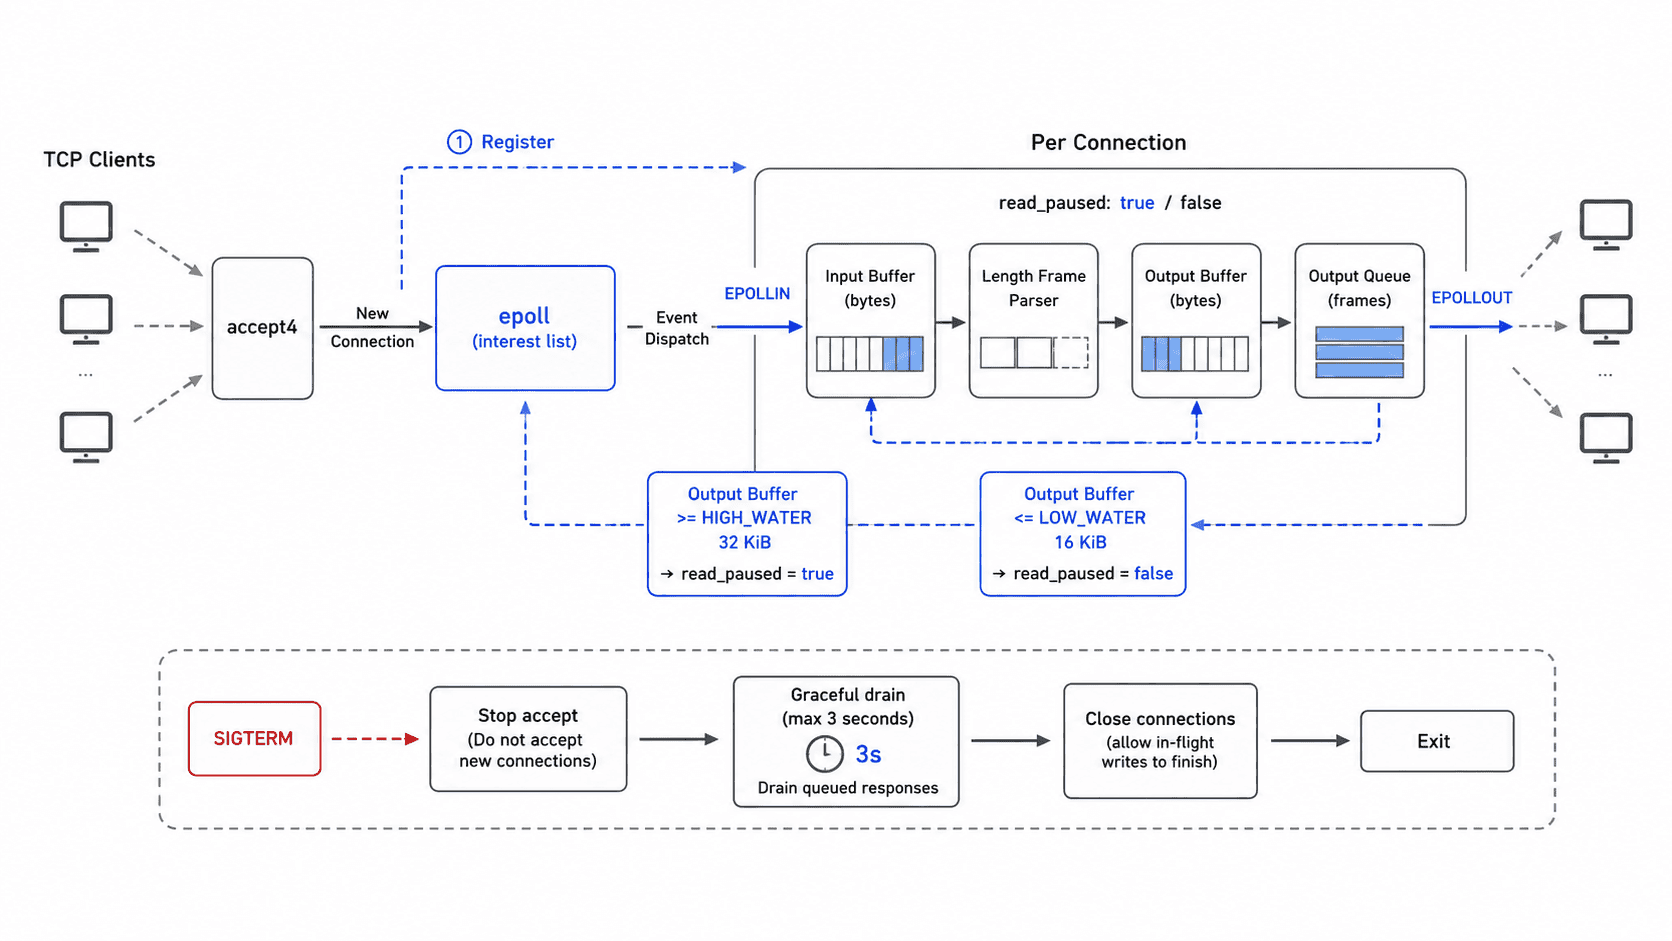
这个模型的关键不是 epoll API 本身,而是连接状态必须跨事件保存。如果把输入或输出缓冲区做成一次回调里的局部变量,遇到半包、短写或背压就会丢失上下文。实验还记录 accept、pause-read、resume-read、close 和退出汇总,压测后可以直接核对状态是否真的发生。
实现非阻塞事件循环
下面的 server.c 使用 level-triggered epoll。监听套接字和客户端套接字都设为非阻塞;信号处理器只修改 sig_atomic_t 标志,不在信号上下文里释放内存或关闭整批连接。退出阶段会先关闭监听套接字,再暂停所有连接读取,只排空已经进入输出队列的响应。
#define _GNU_SOURCE
#include <arpa/inet.h>
#include <errno.h>
#include <fcntl.h>
#include <netinet/in.h>
#include <signal.h>
#include <stdint.h>
#include <stdio.h>
#include <stdlib.h>
#include <string.h>
#include <sys/epoll.h>
#include <sys/socket.h>
#include <time.h>
#include <unistd.h>

#define MAX_EVENTS 128
#define IN_CAP 65536
#define OUT_CAP 65536
#define MAX_FRAME 4096
#define HIGH_WATER 32768
#define LOW_WATER 16384
#define DRAIN_SECONDS 3

enum { ITEM_LISTENER = 1, ITEM_CONN = 2 };

typedef struct {
    int kind;
    int fd;
} Item;

/* 每个连接独立维护输入、输出缓冲区和背压状态。 */
typedef struct Conn {
    Item item;
    unsigned char inbuf[IN_CAP];
    size_t in_len;
    unsigned char outbuf[OUT_CAP];
    size_t out_start;
    size_t out_end;
    int read_paused;
    struct Conn *next;
} Conn;

static volatile sig_atomic_t stopping = 0;
static int draining = 0;
static Conn *connections = NULL;
static uint64_t accepted = 0;
static uint64_t frames = 0;

static void on_signal(int signo) {
    (void)signo;
    stopping = 1;
}

static int set_nonblock(int fd) {
    int flags = fcntl(fd, F_GETFL, 0);
    if (flags < 0) return -1;
    return fcntl(fd, F_SETFL, flags | O_NONBLOCK);
}

static void log_event(const char *event, int fd, size_t queued) {
    fprintf(stderr, "{\"ts\":%ld,\"event\":\"%s\",\"fd\":%d,\"queued\":%zu}\n",
            (long)time(NULL), event, fd, queued);
}

static size_t queued_bytes(const Conn *c) {
    return c->out_end - c->out_start;
}

static uint32_t desired_events(const Conn *c) {
    uint32_t ev = EPOLLRDHUP;
    if (!draining && !c->read_paused) ev |= EPOLLIN;
    if (queued_bytes(c) > 0) ev |= EPOLLOUT;
    return ev;
}

static int update_interest(int epfd, Conn *c) {
    struct epoll_event ev = {0};
    ev.events = desired_events(c);
    ev.data.ptr = c;
    return epoll_ctl(epfd, EPOLL_CTL_MOD, c->item.fd, &ev);
}

static void unlink_conn(Conn *c) {
    Conn **pp = &connections;
    while (*pp && *pp != c) pp = &(*pp)->next;
    if (*pp == c) *pp = c->next;
}

static void close_conn(int epfd, Conn *c) {
    log_event("close", c->item.fd, queued_bytes(c));
    epoll_ctl(epfd, EPOLL_CTL_DEL, c->item.fd, NULL);
    close(c->item.fd);
    unlink_conn(c);
    free(c);
}

static int ensure_output_space(Conn *c, size_t need) {
    if (OUT_CAP - c->out_end >= need) return 0;
    if (c->out_start > 0) {
        memmove(c->outbuf, c->outbuf + c->out_start, queued_bytes(c));
        c->out_end -= c->out_start;
        c->out_start = 0;
    }
    return (OUT_CAP - c->out_end >= need) ? 0 : -1;
}

static int parse_frames(Conn *c) {
    size_t pos = 0;
    while (c->in_len - pos >= 4) {
        /* 帧头是网络字节序的 32 位长度,避免把 TCP 分段误当消息边界。 */
        uint32_t net_len;
        memcpy(&net_len, c->inbuf + pos, sizeof(net_len));
        uint32_t len = ntohl(net_len);
        if (len > MAX_FRAME) return -1;
        size_t frame_size = 4u + (size_t)len;
        if (c->in_len - pos < frame_size) break;
        /* 只有完整帧能进入输出队列;空间不足时暂停继续读取。 */
        if (ensure_output_space(c, frame_size) < 0) {
            if (!c->read_paused) log_event("pause-read", c->item.fd, queued_bytes(c));
            c->read_paused = 1;
            break;
        }
        memcpy(c->outbuf + c->out_end, c->inbuf + pos, frame_size);
        c->out_end += frame_size;
        pos += frame_size;
        frames++;
        if (queued_bytes(c) >= HIGH_WATER) {
            if (!c->read_paused) log_event("pause-read", c->item.fd, queued_bytes(c));
            c->read_paused = 1;
            break;
        }
    }
    if (pos > 0) {
        memmove(c->inbuf, c->inbuf + pos, c->in_len - pos);
        c->in_len -= pos;
    }
    return 0;
}

static int handle_read(int epfd, Conn *c) {
    while (!c->read_paused) {
        if (c->in_len == IN_CAP) {
            if (parse_frames(c) < 0 || c->in_len == IN_CAP) return -1;
            if (c->read_paused) break;
        }
        ssize_t n = recv(c->item.fd, c->inbuf + c->in_len, IN_CAP - c->in_len, 0);
        if (n > 0) {
            c->in_len += (size_t)n;
            if (parse_frames(c) < 0) return -1;
            continue;
        }
        if (n == 0) return -1;
        if (errno == EAGAIN || errno == EWOULDBLOCK) break;
        if (errno == EINTR) continue;
        return -1;
    }
    return update_interest(epfd, c);
}

static int handle_write(int epfd, Conn *c) {
    while (c->out_start < c->out_end) {
        ssize_t n = send(c->item.fd, c->outbuf + c->out_start,
                         c->out_end - c->out_start, MSG_NOSIGNAL);
        if (n > 0) {
            c->out_start += (size_t)n;
            continue;
        }
        if (n < 0 && errno == EINTR) continue;
        /* 非阻塞套接字返回 EAGAIN 代表本轮已写到内核发送缓冲区上限。 */
        if (n < 0 && (errno == EAGAIN || errno == EWOULDBLOCK)) break;
        return -1;
    }
    if (c->out_start == c->out_end) c->out_start = c->out_end = 0;
    /* 低水位恢复 EPOLLIN,形成高低水位滞回,避免频繁开关读取。 */
    if (!draining && c->read_paused && queued_bytes(c) <= LOW_WATER) {
        c->read_paused = 0;
        log_event("resume-read", c->item.fd, queued_bytes(c));
        if (parse_frames(c) < 0) return -1;
    }
    return update_interest(epfd, c);
}

static int accept_clients(int epfd, int listen_fd) {
    for (;;) {
        /* 新连接从创建起就是非阻塞并带 CLOEXEC,避免后续再改状态的竞态。 */
        int fd = accept4(listen_fd, NULL, NULL, SOCK_NONBLOCK | SOCK_CLOEXEC);
        if (fd < 0) {
            if (errno == EAGAIN || errno == EWOULDBLOCK) return 0;
            if (errno == EINTR) continue;
            return -1;
        }
        Conn *c = calloc(1, sizeof(*c));
        if (!c) {
            close(fd);
            return -1;
        }
        c->item.kind = ITEM_CONN;
        c->item.fd = fd;
        c->next = connections;
        connections = c;

        struct epoll_event ev = {0};
        ev.events = EPOLLIN | EPOLLRDHUP;
        ev.data.ptr = c;
        if (epoll_ctl(epfd, EPOLL_CTL_ADD, fd, &ev) < 0) {
            close_conn(epfd, c);
            return -1;
        }
        accepted++;
        log_event("accept", fd, 0);
    }
}

static void drain_and_close(int epfd) {
    draining = 1;
    time_t deadline = time(NULL) + DRAIN_SECONDS;
    struct epoll_event events[MAX_EVENTS];

    /* 退出阶段不再读新请求,只给已排队响应一个有限的排空窗口。 */
    for (Conn *c = connections; c; c = c->next) {
        c->read_paused = 1;
        update_interest(epfd, c);
    }

    while (connections && time(NULL) < deadline) {
        int n = epoll_wait(epfd, events, MAX_EVENTS, 100);
        if (n < 0) {
            if (errno == EINTR) continue;
            break;
        }
        for (int i = 0; i < n; i++) {
            Item *item = events[i].data.ptr;
            if (!item || item->kind != ITEM_CONN) continue;
            Conn *c = (Conn *)item;
            if ((events[i].events & EPOLLOUT) && handle_write(epfd, c) < 0) {
                close_conn(epfd, c);
                continue;
            }
            if (events[i].events & (EPOLLERR | EPOLLHUP | EPOLLRDHUP)) {
                close_conn(epfd, c);
            }
        }
        Conn *c = connections;
        while (c) {
            Conn *next = c->next;
            if (queued_bytes(c) == 0) close_conn(epfd, c);
            c = next;
        }
    }

    while (connections) close_conn(epfd, connections);
}

int main(int argc, char **argv) {
    int port = (argc == 2) ? atoi(argv[1]) : 9000;
    if (port <= 0 || port > 65535) {
        fprintf(stderr, "usage: %s [port]\n", argv[0]);
        return 2;
    }

    /* 信号处理器只置位,真正的资源回收留在事件循环线程执行。 */
    struct sigaction sa = {0};
    sa.sa_handler = on_signal;
    sigemptyset(&sa.sa_mask);
    sigaction(SIGINT, &sa, NULL);
    sigaction(SIGTERM, &sa, NULL);
    signal(SIGPIPE, SIG_IGN);

    int listen_fd = socket(AF_INET, SOCK_STREAM | SOCK_CLOEXEC, 0);
    if (listen_fd < 0) { perror("socket"); return 1; }
    int one = 1;
    setsockopt(listen_fd, SOL_SOCKET, SO_REUSEADDR, &one, sizeof(one));
    if (set_nonblock(listen_fd) < 0) { perror("fcntl"); return 1; }

    struct sockaddr_in addr = {0};
    addr.sin_family = AF_INET;
    addr.sin_addr.s_addr = htonl(INADDR_ANY);
    addr.sin_port = htons((uint16_t)port);
    if (bind(listen_fd, (struct sockaddr *)&addr, sizeof(addr)) < 0) {
        perror("bind"); return 1;
    }
    if (listen(listen_fd, SOMAXCONN) < 0) { perror("listen"); return 1; }

    int epfd = epoll_create1(EPOLL_CLOEXEC);
    if (epfd < 0) { perror("epoll_create1"); return 1; }
    Item listener = {.kind = ITEM_LISTENER, .fd = listen_fd};
    struct epoll_event lev = {.events = EPOLLIN, .data.ptr = &listener};
    if (epoll_ctl(epfd, EPOLL_CTL_ADD, listen_fd, &lev) < 0) {
        perror("epoll_ctl"); return 1;
    }

    fprintf(stderr, "listening on 0.0.0.0:%d\n", port);
    struct epoll_event events[MAX_EVENTS];

    /* 单线程 epoll 同时推进多个连接的读写状态,不为每个连接创建线程。 */
    while (!stopping) {
        int n = epoll_wait(epfd, events, MAX_EVENTS, -1);
        if (n < 0) {
            if (errno == EINTR) continue;
            perror("epoll_wait"); break;
        }
        for (int i = 0; i < n; i++) {
            Item *item = events[i].data.ptr;
            if (item->kind == ITEM_LISTENER) {
                if (accept_clients(epfd, listen_fd) < 0) perror("accept4");
                continue;
            }
            Conn *c = (Conn *)item;
            uint32_t ev = events[i].events;
            if ((ev & EPOLLIN) && handle_read(epfd, c) < 0) {
                close_conn(epfd, c);
                continue;
            }
            if ((ev & EPOLLOUT) && handle_write(epfd, c) < 0) {
                close_conn(epfd, c);
                continue;
            }
            if (ev & (EPOLLERR | EPOLLHUP | EPOLLRDHUP)) {
                close_conn(epfd, c);
            }
        }
    }

    epoll_ctl(epfd, EPOLL_CTL_DEL, listen_fd, NULL);
    close(listen_fd);
    fprintf(stderr, "stopping: accepted=%llu frames=%llu\n",
            (unsigned long long)accepted, (unsigned long long)frames);
    drain_and_close(epfd);
    close(epfd);
    return 0;
}
预期结果:将代码保存为 server.c 后,可以只依赖 glibc 和 Linux 系统调用完成编译;协议长度大于 4096 字节的连接会被关闭,正常完整帧会被原样回显。
编译并启动服务:
gcc -std=c11 -O2 -Wall -Wextra -Wpedantic server.c -o framed-server
./framed-server 9000 2>server.log &
SERVER_PID=$!
printf 'server pid=%s\n' "$SERVER_PID"
预期输出:
server pid=<PID><PID> 会随每次运行变化。若 gcc 有编译错误,先修正后再继续;若启动后 server.log 出现 bind: Address already in use,说明 9000 端口已被占用,需要结束占用进程或改用其他端口。
用突发并发压测验证稳定性
普通“一发一收”客户端很难把服务端输出队列推到高水位,因此压测客户端按批次连续发送多个帧,再逐个读取响应。这样既制造多连接并发,也能验证服务端在一轮 EPOLLIN 中积累输出后是否真正暂停和恢复读取。
import socket
import struct
import sys
import threading
import time

def recv_exact(sock, size):
    # TCP 只保证字节流顺序,必须循环读取到协议需要的精确长度。
    chunks = []
    left = size
    while left:
        chunk = sock.recv(left)
        if not chunk:
            raise ConnectionError("peer closed")
        chunks.append(chunk)
        left -= len(chunk)
    return b"".join(chunks)

def worker(host, port, batches, pipeline, payload_size, latencies, completed, lock):
    payload = b"x" * payload_size
    # 一次突发发送多个长度帧,既制造并发,也能逼近服务端输出高水位。
    frame = struct.pack("!I", len(payload)) + payload
    local_latency = []
    local_completed = 0
    try:
        with socket.create_connection((host, port), timeout=5) as sock:
            # 每个线程复用一条长连接,避免把建连成本重复计入每个帧。
            for _ in range(batches):
                start = time.perf_counter_ns()
                sock.sendall(frame * pipeline)
                for _ in range(pipeline):
                    length = struct.unpack("!I", recv_exact(sock, 4))[0]
                    echoed = recv_exact(sock, length)
                    if echoed != payload:
                        raise ValueError("payload mismatch")
                    local_completed += 1
                local_latency.append((time.perf_counter_ns() - start) / 1_000_000)
    except Exception:
        pass
    with lock:
        latencies.extend(local_latency)
        completed[0] += local_completed

def percentile(values, p):
    # 这里统计的是一批 pipeline 帧全部往返完成的延迟。
    if not values:
        return float("nan")
    values = sorted(values)
    index = min(len(values) - 1, int((len(values) - 1) * p))
    return values[index]

def main():
    if len(sys.argv) != 7:
        raise SystemExit(
            "usage: load_client.py HOST PORT CLIENTS BATCHES PIPELINE PAYLOAD_BYTES"
        )
    host, port_s, clients_s, batches_s, pipeline_s, payload_s = sys.argv[1:]
    port = int(port_s)
    clients = int(clients_s)
    batches = int(batches_s)
    pipeline = int(pipeline_s)
    payload_size = int(payload_s)
    latencies = []
    completed = [0]
    lock = threading.Lock()
    # 标准库线程足以制造并发 socket I/O,无需安装第三方压测包。
    threads = [
        threading.Thread(
            target=worker,
            args=(host, port, batches, pipeline, payload_size, latencies, completed, lock),
        )
        for _ in range(clients)
    ]
    start = time.perf_counter()
    for thread in threads:
        thread.start()
    for thread in threads:
        thread.join()
    elapsed = time.perf_counter() - start
    total = clients * batches * pipeline
    errors = total - completed[0]
    print(
        f"frames={total} completed={completed[0]} errors={errors} "
        f"duration={elapsed:.3f}s fps={completed[0] / elapsed:.1f}"
    )
    print(
        "batch_latency_ms "
        f"p50={percentile(latencies, 0.50):.3f} "
        f"p95={percentile(latencies, 0.95):.3f} "
        f"p99={percentile(latencies, 0.99):.3f}"
    )

if __name__ == "__main__":
    main()
预期结果:将脚本保存为 load_client.py 后无需第三方依赖;它会校验每个回显 payload,并统计完成帧数、错误数、帧吞吐以及每批 pipeline 帧的延迟分位点。
运行 20 条长连接,每条连接执行 20 个批次,每批突发 64 帧,每帧 512 字节:
python3 load_client.py 127.0.0.1 9000 20 20 64 512预期输出:
frames=25600 completed=25600 errors=0 duration=<TIME>s fps=<VALUE>
batch_latency_ms p50=<VALUE> p95=<VALUE> p99=<VALUE>
<TIME> 和 <VALUE> 取决于 CPU、内核、虚拟化和当前负载,不能拿不同机器的绝对值直接比较。这里最先检查的是 completed=25600 与 errors=0;batch_latency_ms 表示一批 64 帧全部往返完成的时间,不是单帧延迟。
核对背压、日志与优雅退出
先确认压测期间高低水位确实被触发。由于内核每次交付给用户态的字节数不同,暂停和恢复次数不是固定值,但在上述突发参数下通常都应大于 0。
printf 'pause=%s resume=%s\n' \
  "$(grep -c 'pause-read' server.log)" \
  "$(grep -c 'resume-read' server.log)"
预期输出:
pause=<VALUE> resume=<VALUE>若两个值长期都是 0,可以增大 PIPELINE 或 payload,让单连接在一次突发中产生更多待发送数据;不要通过无限增大固定缓冲区来“解决”背压,那只会把失控点推迟到更高内存占用。
压测完成后向服务发送 SIGTERM 并等待它退出,再核对汇总计数:
kill -TERM "$SERVER_PID"
wait "$SERVER_PID"
grep 'stopping:' server.log | tail -n 1
预期输出:
stopping: accepted=20 frames=25600这个结果成立的前提是前面的压测 errors=0 且没有额外客户端连接。服务收到终止信号后会停止 accept,只给已有输出最多 3 秒的排空窗口,然后关闭剩余连接;因此它不会无限等待慢客户端。
当错误率为 0、服务端帧计数与客户端完成数一致、背压日志可观察,并且 SIGTERM 能在有限时间内结束进程时,这个服务才算形成了“协议正确、连接状态可控、慢端不会无限拖垮、退出可预期”的最小工程闭环。