
C / C++ / 系统课时
排查竞态与死锁
排查竞态与死锁
并发故障最难的地方是“偶尔出错”或“程序卡住却没有崩溃”。本课建立一套可重复的定位顺序:先缩小复现,再用 ThreadSanitizer 找数据竞争,用调试器确认阻塞链,最后通过锁顺序和压力复测验证修复。
学习目标
- 区分数据竞争、死锁与活锁的可观察特征
- 使用 ThreadSanitizer 和 GDB 获取可操作的并发证据
- 通过统一锁顺序、缩小临界区和复测确认修复有效
先判断故障属于哪一类
数据竞争是未正确同步的并发内存访问,至少一个访问为写;它可能表现为结果错误、崩溃或完全正常,因此“多跑几次没问题”不能证明安全。死锁是线程彼此等待无法继续;活锁则是线程仍在运行、不断重试或让步,但业务进度长期不增长。
排查时先记录“是否还能消耗 CPU、线程是否阻塞、错误是否随负载变化、是否能稳定复现”。不要一开始就盯着某一把锁猜根因,否则很容易把结果不一致、阻塞和高 CPU 混为一谈。
按固定顺序收集证据
一个实用顺序是:先构造最小复现并保留调试符号;结果错误优先跑 ThreadSanitizer;程序卡死时抓取所有线程栈;线程持续占用 CPU 但无业务进展时检查重试循环、锁竞争和进度指标。拿到证据后再修改锁或原子操作。
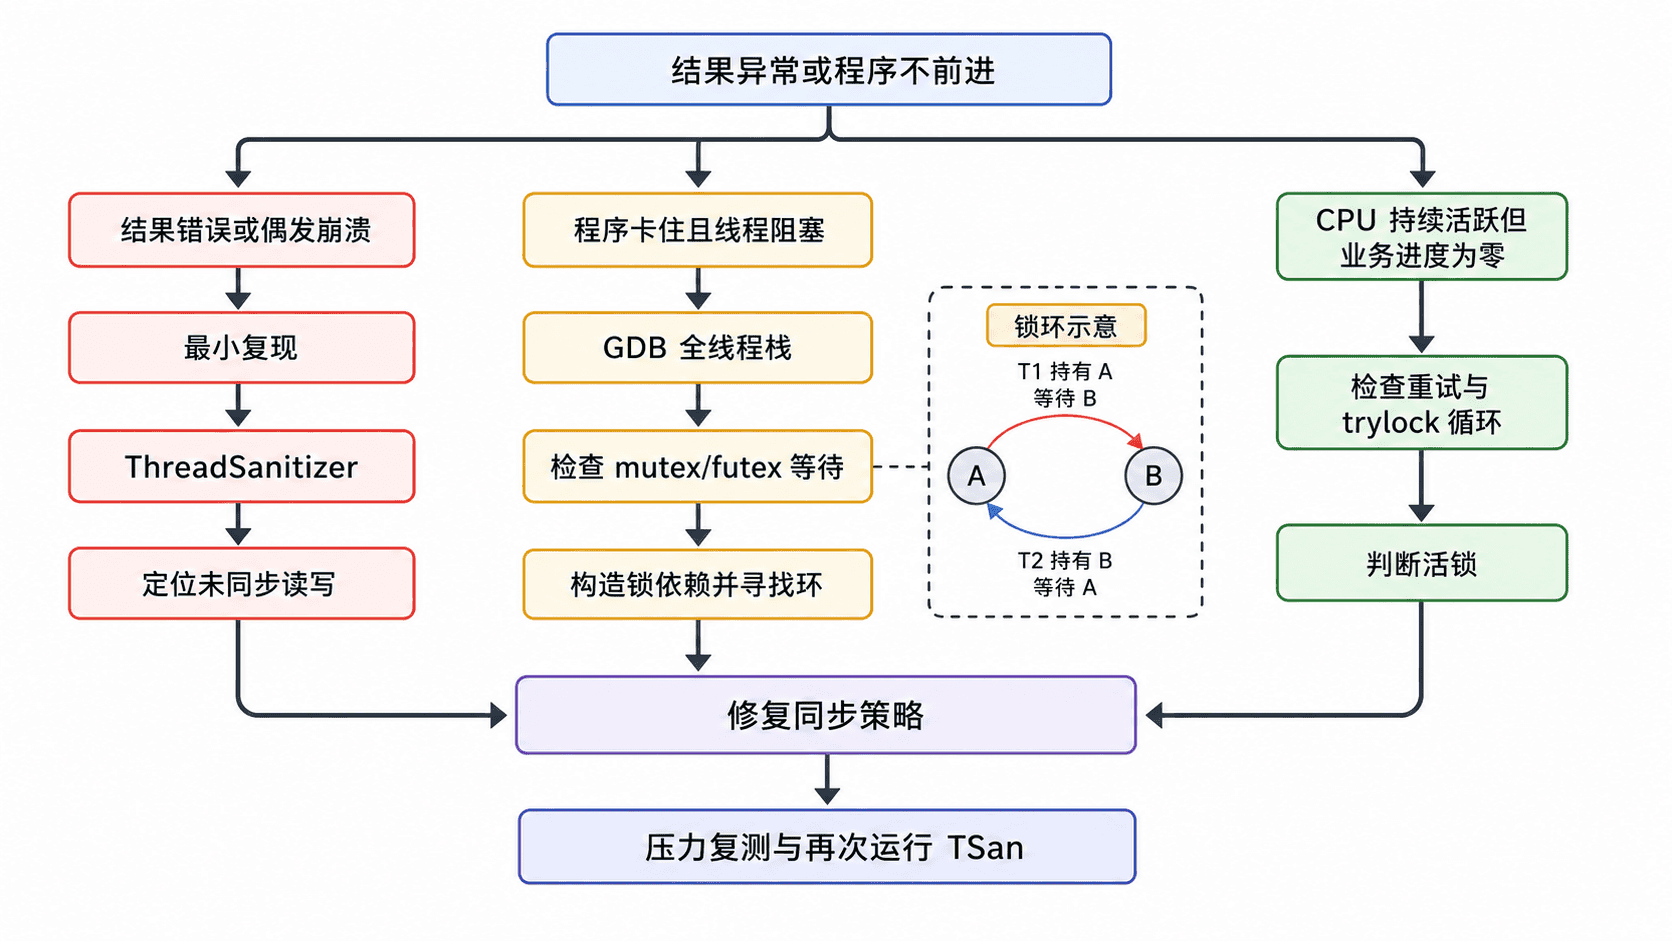
最小复现的目标不是“把所有日志都搬过来”,而是尽量保留共享对象、线程数量、同步方式和触发条件,同时删除网络、UI、业务框架等无关变量。这样 sanitizer 和调试器给出的栈才容易解释。
用 ThreadSanitizer 抓数据竞争
下面的最小程序让两个线程同时执行 counter++。这个表达式包含读、计算和写,并不是一次 C11 原子操作,因此对普通全局变量的并发执行形成数据竞争。
#include <pthread.h>
#include <stdio.h>

static int counter = 0;

static void *worker(void *arg) {
    (void)arg;
    for (int i = 0; i < 100000; ++i) {
        counter++;  // 故意保留数据竞争,供 TSan 捕获
    }
    return NULL;
}

int main(void) {
    pthread_t a;
    pthread_t b;

    pthread_create(&a, NULL, worker, NULL);
    pthread_create(&b, NULL, worker, NULL);
    pthread_join(a, NULL);
    pthread_join(b, NULL);

    printf("counter=%d\\n", counter);
    return 0;
}
用 GCC 或 Clang 的 ThreadSanitizer 构建。调试阶段保留 -g,并降低优化级别以获得更易读的栈:
cc -std=c11 -O1 -g -fsanitize=thread -fno-omit-frame-pointer -pthread race.c -o race
./race
预期结果不是固定的 counter 数值,而是 TSan 在标准错误中报告数据竞争。具体地址、线程编号和行号会随运行环境变化:
WARNING: ThreadSanitizer: data race
  Read of size 4 at <ADDR> by thread T<ID>
  Previous write of size 4 at <ADDR> by thread T<ID>
SUMMARY: ThreadSanitizer: data race race.c:<LINE> in worker
实际输出里的 <ADDR>、<ID> 与 <LINE> 会不同。修复时应回到报告中的两条冲突访问,确认它们是否应该由同一把锁、原子对象或更高层同步协议保护,而不是只压制 sanitizer 报告。
对于这个计数器,最直接的修复是让临界区由同一个互斥锁保护:
#include <pthread.h>
#include <stdio.h>

static int counter = 0;
static pthread_mutex_t lock = PTHREAD_MUTEX_INITIALIZER;

static void *worker(void *arg) {
    (void)arg;
    for (int i = 0; i < 100000; ++i) {
        pthread_mutex_lock(&lock);
        counter++;  // 对 counter 的访问全部受同一把锁保护
        pthread_mutex_unlock(&lock);
    }
    return NULL;
}

int main(void) {
    pthread_t a;
    pthread_t b;

    pthread_create(&a, NULL, worker, NULL);
    pthread_create(&b, NULL, worker, NULL);
    pthread_join(a, NULL);
    pthread_join(b, NULL);

    printf("counter=%d\\n", counter);
    return 0;
}
再次使用同样的 sanitizer 选项构建并运行:
cc -std=c11 -O1 -g -fsanitize=thread -fno-omit-frame-pointer -pthread race_fixed.c -o race_fixed
./race_fixed
预期输出:
counter=200000同时不应再出现针对 counter 的 ThreadSanitizer: data race 报告。若仍有报告,应继续按报告中的访问栈定位,不能把“结果变对了”当作同步已经正确。
用 GDB 确认死锁和锁顺序
程序长时间无进展时,先抓全线程栈,而不是立即重启。对仍在运行的目标进程,可以用批处理方式附加并一次性打印线程列表与回溯:
gdb -q -batch \
  -ex 'set pagination off' \
  -ex 'info threads' \
  -ex 'thread apply all bt' \
  -p <PID>
预期结果是得到所有线程的调用栈。真正的互斥锁死锁常表现为两个或多个线程都停在 pthread_mutex_lock 或更底层的 futex 等待路径;具体函数名和地址会因 glibc 与编译选项不同而变化:
Thread <ID-A>:
#0  <futex-wait-or-pthread_mutex_lock>
#1  lock_path_a

Thread <ID-B>:
#0  <futex-wait-or-pthread_mutex_lock>
#1  lock_path_b
如果系统的 ptrace 策略禁止附加,应从 GDB 启动目标程序或按本机调试策略处理权限,不要为了方便排查而永久放宽生产主机的安全设置。
接着回到业务代码建立“持有什么锁、正在等什么锁”的关系。如果线程 A 持有 lock_a 等 lock_b,线程 B 持有 lock_b 等 lock_a,等待图已经形成环。最稳妥的修复通常是给多把锁规定全局顺序,并让所有路径都按同一顺序获取;同时缩小持锁范围,避免在持锁期间做阻塞 I/O 或调用未知回调。
别把活锁误判成死锁
活锁时线程通常没有睡死,而是在 trylock、CAS 重试、冲突后立即让步等循环中持续消耗 CPU。判断关键不是“线程是否活着”,而是业务进度计数是否长期不增长。
修复方向包括给重试增加有界退避或随机抖动、降低同时争抢同一资源的线程数,或直接改用阻塞同步原语。如果问题本来可以通过统一锁顺序解决,就不要用双方不断释放再重试的策略绕开死锁,因为它很容易把“卡死”变成“高 CPU 但仍不前进”。
修复后要做反证式验证
修复完成后重新运行 TSan,并在接近真实并发度的压力下重复执行。对上面的修复版本,可做一个简单重复验证:
for i in $(seq 1 100); do
    ./race_fixed >/dev/null || exit 1
done
echo "stress-pass"
预期输出:
stress-pass这 100 次成功仍不是并发正确性的数学证明,但它与“TSan 无数据竞争报告、锁等待图无环、关键进度指标持续增长”组合起来,能形成比一次正常运行强得多的证据链。生产代码还应把锁顺序约定写进代码审查规则,避免同类故障在新路径中重新出现。