
C / C++ / 系统课时
处理 core dump 与线上崩溃
处理 core dump 与线上崩溃
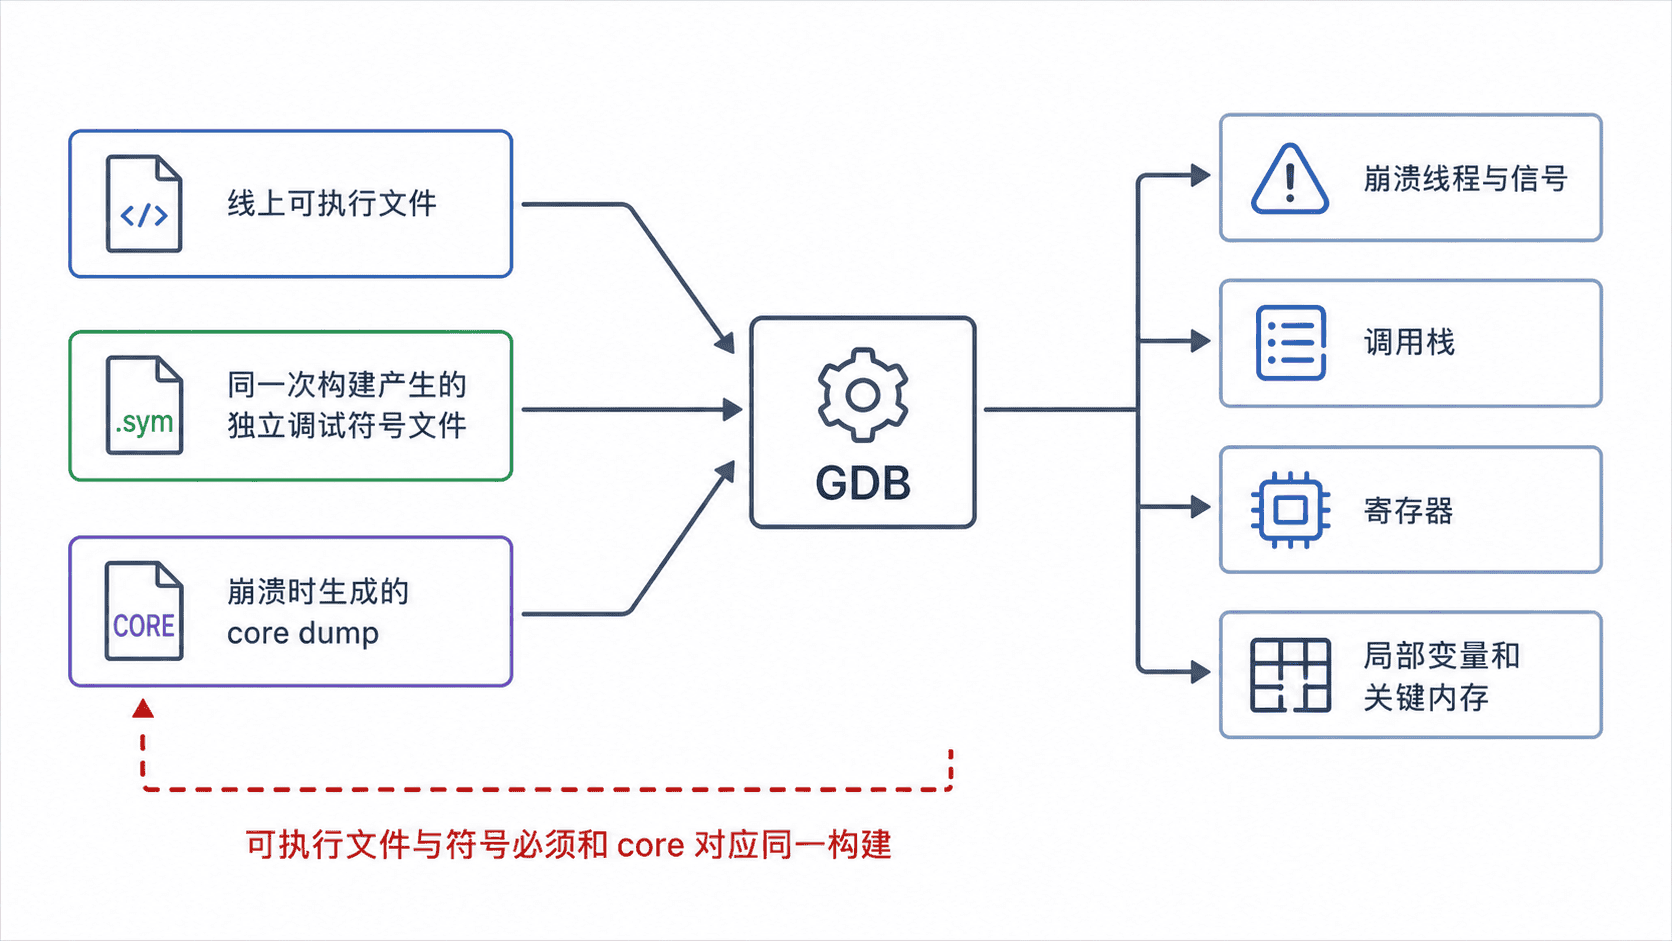
线上进程收到致命信号后,日志往往只能告诉你“崩了”。core dump 保留崩溃瞬间的进程内存与寄存器状态;配合完全匹配的可执行文件、调试符号和 GDB,可以还原崩溃线程、调用栈与关键变量。
学习目标
- 能确认 Linux 是否允许生成 core dump,并理解
core_pattern决定的保存方式 - 能为可执行文件保留独立调试符号,生成并定位一个可复现的 core 文件
- 能用 GDB 检查崩溃线程、调用栈、寄存器、局部变量和关键内存,并识别符号不匹配问题
先确认 core dump 能否落地
core 文件能否产生,至少受进程的 core 大小限制和内核 core_pattern 影响。先读取当前设置,不要一上来就改系统全局配置。
printf 'core_limit='
ulimit -c
printf 'core_pattern='
cat /proc/sys/kernel/core_pattern
预期输出
core_limit=<VALUE>
core_pattern=<CORE_PATTERN>
core_limit 为 0 时,当前 shell 启动的进程通常不会写普通 core 文件;可在实验 shell 中执行 ulimit -c unlimited。core_pattern 若以 | 开头,表示内核把 core 数据交给用户态处理程序,而不是直接按文件名写盘;使用 systemd 的机器常需要通过现有的 coredump 管理方式取回文件。
构造崩溃并保留独立符号
线上常见做法是部署较精简的二进制,同时把调试信息单独归档。下面用 objcopy 生成 crash_demo.debug,再通过 .gnu_debuglink 让 GDB 能找到匹配符号。
cat > crash_demo.c <<'EOF'
#include <stdio.h>

typedef struct {
    int id;
    char name[16];
} record_t;

__attribute__((noinline))
static void crash(record_t *r) {
    fprintf(stderr, "crashing id=%d name=%s\n", r->id, r->name);
    /* 故意写空指针,制造一个稳定的 SIGSEGV。 */
    volatile int *p = NULL;
    *p = r->id;
}

int main(void) {
    record_t r = {42, "worker"};
    crash(&r);
    return 0;
}
EOF

gcc -g -O0 -fno-omit-frame-pointer -o crash_demo crash_demo.c
objcopy --only-keep-debug crash_demo crash_demo.debug
strip --strip-debug crash_demo
objcopy --add-gnu-debuglink=crash_demo.debug crash_demo
readelf --string-dump=.gnu_debuglink crash_demo
预期输出
String dump of section '.gnu_debuglink':
  [     0]  crash_demo.debug
调试时必须让 core、可执行文件和符号文件来自同一次构建。仅仅“源码版本看起来一样”并不够;编译器、链接布局或依赖变化都可能让地址映射失真。
在实验环境生成 core 文件
为了得到确定的文件路径,下面暂时把系统级 core_pattern 指向当前实验目录,并在程序崩溃后立即恢复原值。此操作需要管理员权限,只适合隔离的实验机;生产环境应遵循既有的 coredump 策略。
mkdir -p "$PWD/cores"
ulimit -c unlimited

original_pattern=$(cat /proc/sys/kernel/core_pattern)
sudo sysctl -w "kernel.core_pattern=$PWD/cores/core.%e.%p" >/dev/null

status=0
./crash_demo || status=$?

sudo sysctl -w "kernel.core_pattern=$original_pattern" >/dev/null
printf 'exit_status=%d\n' "$status"
ls -1 cores/core.crash_demo.*
预期输出
crashing id=42 name=worker
Segmentation fault (core dumped)
exit_status=139
cores/core.crash_demo.<PID>
SIGSEGV 的信号号是 11,Bash 常把信号退出状态表示为 128 + 11 = 139;终端中的崩溃提示文字可能因 shell 和语言环境不同而变化。若没有生成文件,应依次检查 core 大小限制、core_pattern、目标目录权限、磁盘空间,以及进程是否允许被转储。
用 GDB 还原崩溃现场
GDB 需要同时加载可执行文件和 core。因为 .gnu_debuglink 已指向同目录的 crash_demo.debug,它可以恢复源码行和局部变量。批处理方式便于把关键证据一次性导出。
core_file=$(ls -1t cores/core.crash_demo.* | head -n1)

gdb -q -batch \
  -ex 'set pagination off' \
  -ex 'info threads' \
  -ex 'bt' \
  -ex 'frame 0' \
  -ex 'info locals' \
  -ex 'p *r' \
  -ex 'info registers' \
  ./crash_demo "$core_file"
预期输出
Core was generated by `./crash_demo'.
Program terminated with signal SIGSEGV, Segmentation fault.
* 1    Thread <ID>  crash (r=0x<ADDR>) at crash_demo.c:<LINE>
#0  crash (r=0x<ADDR>) at crash_demo.c:<LINE>
#1  main () at crash_demo.c:<LINE>
p = (volatile int *) 0x0
$1 = {id = 42, name = <CHAR_ARRAY>}
<REGISTER_DUMP>
info threads 中带 * 的线程是当前选中线程;多线程线上 core 还应执行 thread apply all bt 对比其他线程是否在持锁、等待或递归。info registers 输出取决于 CPU 架构,重点是保留指令指针、栈指针等现场值,再结合栈帧和反汇编判断故障指令。
从崩溃点追到真正根因
本例直接在空指针写入处崩溃,所以 p = 0x0 很接近根因。真实故障常不同:越界写可能提前破坏堆,直到稍后 free 才崩;栈内存被覆盖后,回溯甚至会断裂;优化构建还可能让局部变量显示为 <optimized out>。因此“最后一帧”是证据入口,不应自动等同于根因。
排查时先确认信号和崩溃线程,再查看完整调用栈;随后检查参数、局部变量、关键对象和寄存器,最后回看更早的内存破坏可能性。若函数名大量变成地址、源码行明显不可信或变量无法解释,优先核对二进制与符号是否来自同一构建,而不是继续猜代码逻辑。
core dump 的价值在于冻结了一个可复查的故障现场。只要转储策略可控、构建产物可追溯,并把“core + 原始二进制 + 匹配符号”作为一组保存,线上偶发崩溃就能从一条模糊日志变成可验证的调用栈、寄存器和内存证据。