
C / C++ / 系统课时
观察程序与内核的交互
观察程序与内核的交互
系统编程最重要的观察能力之一,是把“程序做了什么”还原成“它向内核请求了什么”。本课用一个最小 C 程序配合 strace,把进程装载、文件访问、内存映射、标准输出和退出这些动作逐一对上系统调用。
学习目标
- 用
strace跟踪一个 C 程序的关键系统调用,并按阶段阅读结果。 - 区分用户态库函数与真正跨越用户态/内核态边界的系统调用。
- 从
execve、openat、read、write、mmap和exit_group判断程序正在执行的工作。
先建立观察边界
开始前需要一台 Linux 环境,并已具备 C 编译器与 strace。C 代码中的函数调用不等于系统调用。printf、malloc 等函数通常先在用户态库中工作,只有需要文件、内存、进程或设备等内核资源时,才会通过系统调用进入内核。strace 观察的正是这个边界,因此它比单看源码更适合回答“程序实际向内核发出了哪些请求”。
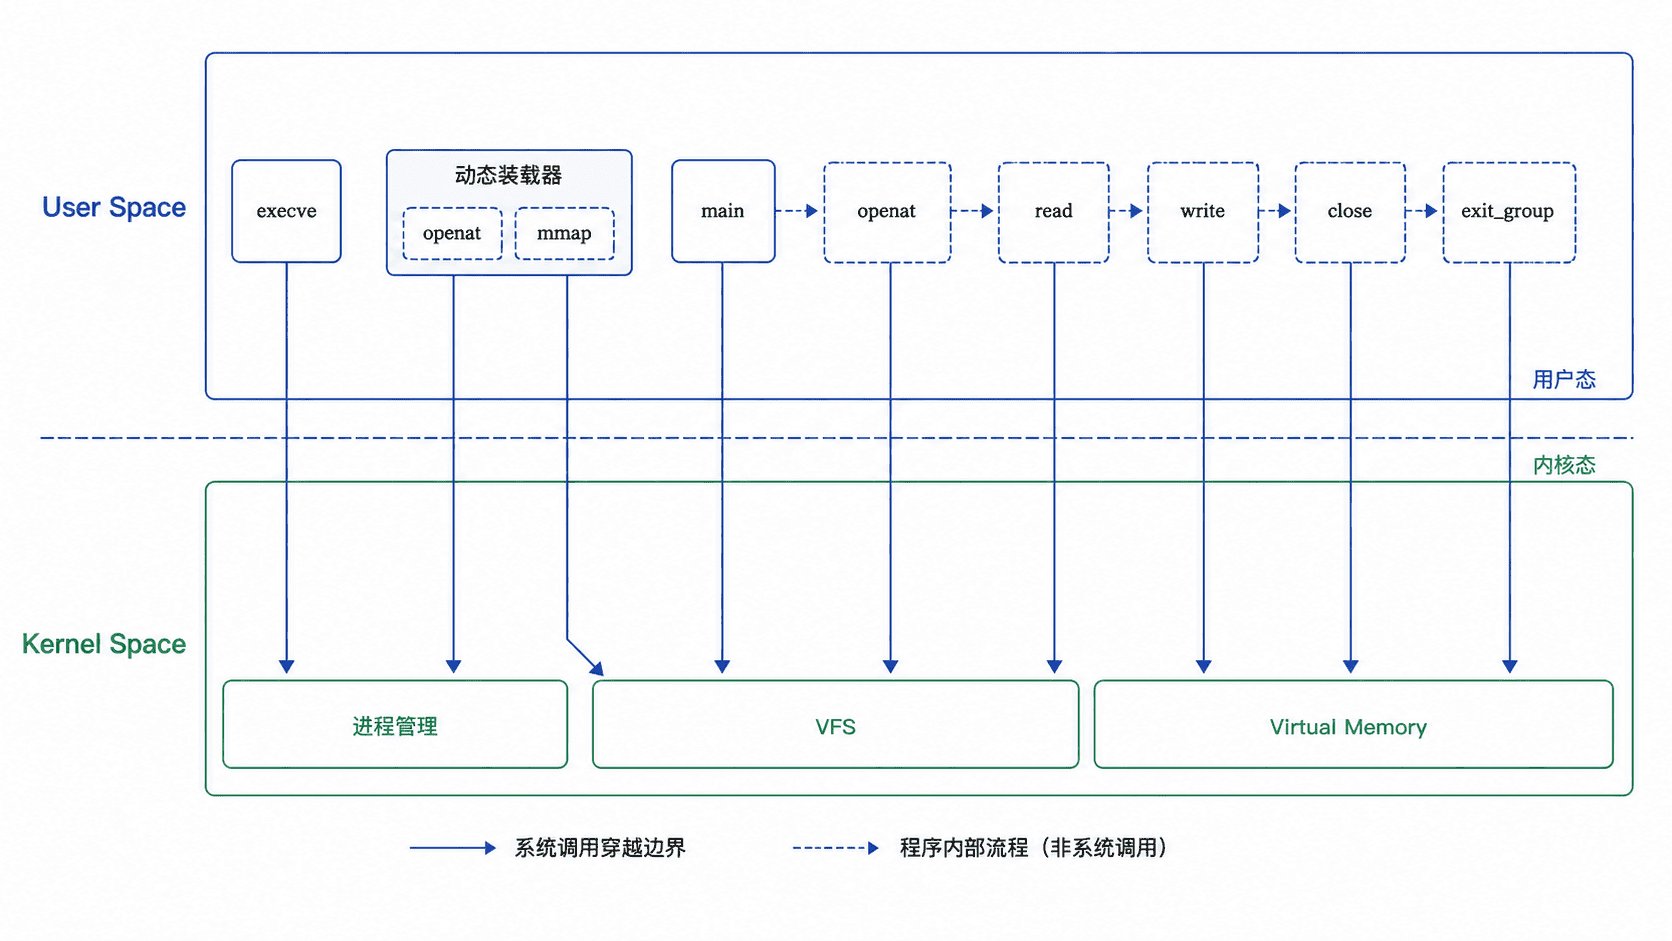
动态链接程序还会在 main 运行前产生一批系统调用,例如打开动态链接器缓存、加载 libc、建立内存映射。看到这些调用并不表示示例程序主动访问了这些文件,而是进程装载阶段的正常工作。
跟踪一个最小文件程序
下面的程序只做四件事:打开 sample.txt、读取内容、写到标准输出、关闭文件。这样可以把源码动作与内核调用直接对应起来。
#define _POSIX_C_SOURCE 200809L

#include <errno.h>
#include <fcntl.h>
#include <stdio.h>
#include <unistd.h>

int main(void) {
    char buf[128];

    int fd = open("sample.txt", O_RDONLY);
    if (fd == -1) {
        perror("open");
        return 1;
    }

    ssize_t n = read(fd, buf, sizeof buf);
    if (n == -1) {
        perror("read");
        close(fd);
        return 1;
    }

    if (write(STDOUT_FILENO, buf, (size_t)n) == -1) {
        perror("write");
        close(fd);
        return 1;
    }

    if (close(fd) == -1) {
        perror("close");
        return 1;
    }

    return 0;
}
保存为 syscall_demo.c,再创建输入文件、编译、运行并只跟踪本课关心的调用:
printf 'kernel-boundary\n' > sample.txt
gcc -std=c17 -Wall -Wextra -O0 -g syscall_demo.c -o syscall_demo
./syscall_demo
strace -o trace.log -e trace=execve,openat,read,write,mmap,close,exit_group ./syscall_demo >/dev/null
grep -E 'execve|sample.txt|mmap|read\(|write\(|close\(|exit_group' trace.log
预期输出中,地址、环境指针、文件描述符以及部分装载细节会因系统而异,下面只列关键形态:
kernel-boundary
execve("./syscall_demo", ["./syscall_demo"], <ENV>) = 0
mmap(NULL, <VALUE>, <VALUE>, <VALUE>, <VALUE>, <VALUE>) = <ADDR>
openat(AT_FDCWD, "sample.txt", O_RDONLY) = <FD>
read(<FD>, "kernel-boundary\n", 128) = 16
write(1, "kernel-boundary\n", 16) = 16
close(<FD>) = 0
exit_group(0) = ?
open() 在跟踪结果里常显示为 openat(),这是 glibc 在 Linux 上实现包装函数时可能采用的系统调用接口;因此不要用“源码函数名必须与系统调用名一致”来判断结果。真正要看的是操作语义、参数和返回值。
按阶段阅读调用链
阅读完整 trace.log 时,先把调用分为装载、业务动作和退出三个阶段。装载阶段常出现 execve、对共享库的 openat 以及多次 mmap;进入 main 后,才会出现对 sample.txt 的打开、读取和关闭;write(1, ...) 表示写标准输出;最后由 exit_group 结束进程。
返回值也很关键。成功的 openat 返回非负文件描述符,read 和 write 返回实际处理的字节数;失败通常返回 -1,随后用户态包装函数设置 errno。因此排查问题时不要只看调用名,还要同时看参数、返回值与失败位置。
避免把库行为误判成内核行为
缓冲会改变你看到的调用数量。例如多次 printf 不一定对应多次 write,因为 stdio 可能先把数据积累在用户态缓冲区,再集中写入内核。内存分配也类似,小块 malloc 可能完全在已有堆空间中完成,不会为每次分配都产生新的内存系统调用。
同样,strace 展示的是系统调用层事实,而不是完整的函数调用栈。需要分析用户态函数耗时或调用关系时,应改用调试器、采样分析器或跟踪工具;需要确认程序与内核边界时,再回到 strace。把这两个观察层次分开,才能避免“源码里有调用,为什么 trace 里没有”这类误判。