
C / C++ / 系统课时
设计 Reactor 与线程池协作
设计 Reactor 与线程池协作
Reactor 适合负责就绪事件和连接状态,线程池适合执行可能耗时的业务计算。真正困难的是两者的交界:如果工作线程直接修改连接对象、调用 epoll_ctl() 或发送数据,就会把连接生命周期变成跨线程共享状态。本节用任务消息和完成消息切断这种竞态。
学习目标
- 划分 Reactor 线程与工作线程的职责边界
- 用任务队列、完成队列和
eventfd建立安全的跨线程通信 - 用连接 ID 与 generation 校验过期任务,避免文件描述符复用导致错写
让连接状态只归 Reactor 所有
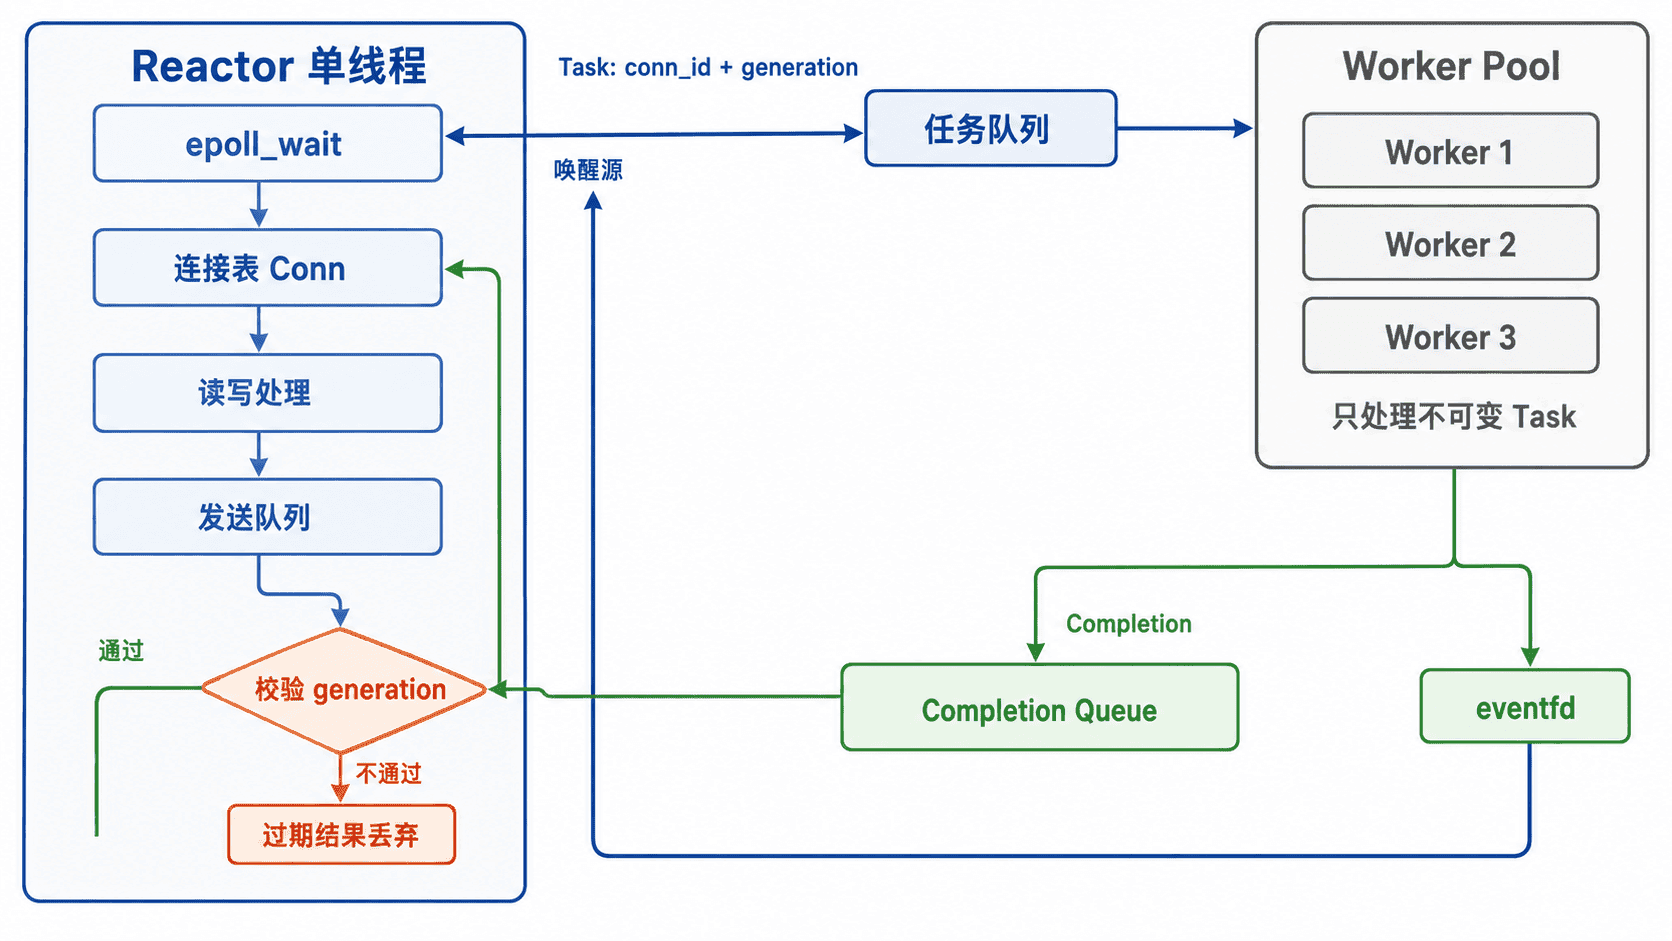
一个可靠的约束是:只有 Reactor 线程可以读写连接对象、关闭文件描述符、修改 epoll 兴趣集和维护发送队列。工作线程拿到的不是 Conn *,而是一份不可变任务,例如请求参数、连接 ID、generation 和业务数据。
任务完成后,工作线程也不直接 send()。它把结果写入完成队列,再向 eventfd 写入一个计数。Reactor 已经把该 eventfd 注册到 epoll,被唤醒后批量取出完成消息,重新核对连接身份,再把响应加入对应发送队列。
用 generation 对抗连接复用
只传文件描述符还不够。连接关闭后,Linux 很快可能把相同的 fd 数字分配给新连接;旧任务稍后完成时,如果只按 fd 查找,就可能把旧响应发送给新客户端。
因此连接表通常为每次新连接分配稳定 ID,并维护递增的 generation。提交任务时把二者一起复制进去;完成消息回来后,Reactor 只有在“连接仍存在且 generation 完全一致”时才接受结果。关闭并重建连接会改变 generation,旧任务自然失效。
主示例:eventfd 唤醒 Reactor
下面的程序启动两个工作线程。Reactor 投递三个计算任务,其中一个故意携带过期 generation。Worker 只从任务队列取值并计算平方,不接触连接表;完成后把结果放入完成队列并写 eventfd。主线程通过 epoll_wait() 收到唤醒,完成连接校验和状态更新。
#define _GNU_SOURCE
#include <pthread.h>
#include <stdint.h>
#include <stdio.h>
#include <stdlib.h>
#include <sys/epoll.h>
#include <sys/eventfd.h>
#include <unistd.h>
enum { QCAP = 16, WORKERS = 2 };
typedef struct {
int conn_id;
unsigned generation;
int value;
} Task;
typedef struct {
int conn_id;
unsigned generation;
int result;
} Completion;
typedef struct {
Task items[QCAP];
int head, tail, count, stopping;
pthread_mutex_t mu;
pthread_cond_t cv;
} TaskQueue;
typedef struct {
Completion items[QCAP];
int head, tail, count;
pthread_mutex_t mu;
} CompletionQueue;
typedef struct {
unsigned generation;
int last_result;
} Conn;
static TaskQueue tasks = {
.mu = PTHREAD_MUTEX_INITIALIZER,
.cv = PTHREAD_COND_INITIALIZER
};
static CompletionQueue completions = {
.mu = PTHREAD_MUTEX_INITIALIZER
};
static int wake_fd;
static void push_task(Task t) {
pthread_mutex_lock(&tasks.mu);
tasks.items[tasks.tail] = t;
tasks.tail = (tasks.tail + 1) % QCAP;
tasks.count++;
pthread_cond_signal(&tasks.cv);
pthread_mutex_unlock(&tasks.mu);
}
static int pop_task(Task *t) {
pthread_mutex_lock(&tasks.mu);
while (tasks.count == 0 && !tasks.stopping)
pthread_cond_wait(&tasks.cv, &tasks.mu);
if (tasks.count == 0 && tasks.stopping) {
pthread_mutex_unlock(&tasks.mu);
return 0;
}
*t = tasks.items[tasks.head];
tasks.head = (tasks.head + 1) % QCAP;
tasks.count--;
pthread_mutex_unlock(&tasks.mu);
return 1;
}
static void push_completion(Completion c) {
pthread_mutex_lock(&completions.mu);
completions.items[completions.tail] = c;
completions.tail = (completions.tail + 1) % QCAP;
completions.count++;
pthread_mutex_unlock(&completions.mu);
uint64_t one = 1;
if (write(wake_fd, &one, sizeof(one)) != sizeof(one)) abort();
}
static int pop_completion(Completion *c) {
pthread_mutex_lock(&completions.mu);
if (completions.count == 0) {
pthread_mutex_unlock(&completions.mu);
return 0;
}
*c = completions.items[completions.head];
completions.head = (completions.head + 1) % QCAP;
completions.count--;
pthread_mutex_unlock(&completions.mu);
return 1;
}
static void *worker_main(void *arg) {
(void)arg;
Task t;
while (pop_task(&t)) {
Completion c = {
.conn_id = t.conn_id,
.generation = t.generation,
.result = t.value * t.value
};
push_completion(c);
}
return NULL;
}
int main(void) {
Conn conns[2] = {
{.generation = 1},
{.generation = 1}
};
wake_fd = eventfd(0, EFD_NONBLOCK | EFD_CLOEXEC);
int epfd = epoll_create1(EPOLL_CLOEXEC);
if (wake_fd < 0 || epfd < 0) return 1;
struct epoll_event ev = {.events = EPOLLIN, .data.fd = wake_fd};
if (epoll_ctl(epfd, EPOLL_CTL_ADD, wake_fd, &ev) < 0) return 1;
pthread_t tids[WORKERS];
for (int i = 0; i < WORKERS; ++i)
pthread_create(&tids[i], NULL, worker_main, NULL);
push_task((Task){.conn_id = 0, .generation = 1, .value = 7});
push_task((Task){.conn_id = 1, .generation = 1, .value = 9});
push_task((Task){.conn_id = 0, .generation = 0, .value = 5});
int handled = 0;
while (handled < 3) {
struct epoll_event events[4];
int n = epoll_wait(epfd, events, 4, -1);
if (n < 0) return 1;
for (int i = 0; i < n; ++i) {
if (events[i].data.fd != wake_fd) continue;
uint64_t notifications;
if (read(wake_fd, ¬ifications, sizeof(notifications)) < 0)
return 1;
Completion c;
while (pop_completion(&c)) {
handled++;
Conn *conn = &conns[c.conn_id];
if (conn->generation != c.generation) {
printf("drop stale completion: conn=%d gen=%u\n",
c.conn_id, c.generation);
continue;
}
// 只有 Reactor 修改连接状态;真实服务器会在这里入发送队列。
conn->last_result = c.result;
printf("apply completion: conn=%d gen=%u result=%d\n",
c.conn_id, c.generation, c.result);
}
}
}
pthread_mutex_lock(&tasks.mu);
tasks.stopping = 1;
pthread_cond_broadcast(&tasks.cv);
pthread_mutex_unlock(&tasks.mu);
for (int i = 0; i < WORKERS; ++i)
pthread_join(tids[i], NULL);
close(epfd);
close(wake_fd);
return 0;
}保存为 reactor_pool.c 后编译运行:
gcc -O2 -Wall -Wextra -pthread reactor_pool.c -o reactor_pool
./reactor_pool
预期输出包含以下三行;两个工作线程并发执行,因此行的先后顺序可能不同:
apply completion: conn=0 gen=1 result=49
apply completion: conn=1 gen=1 result=81
drop stale completion: conn=0 gen=0
eventfd 的价值在于把“线程池有结果了”转换为普通 fd 可读事件,使 Reactor 不需要轮询完成队列。生产代码还应给固定容量队列补上满队列策略,避免工作速度持续落后时把内存压力从连接队列转移到任务队列。
明确哪些操作不能跨线程
把边界固定后,并发设计会简单很多:Reactor 负责 accept、recv、协议状态、连接关闭、epoll_ctl() 和发送队列;Worker 负责 CPU 密集计算、阻塞式存储访问或其他不依赖连接对象的任务。Worker 返回的是结果消息,而不是“请替我操作这个 Conn *”。
若业务必须取消任务,也应发送“取消意图”或在共享任务状态上使用明确的原子协议,而不是让多个线程抢着关闭同一 fd。只要连接状态保持单线程所有、跨线程只传值对象,并在回程校验 conn_id + generation,Reactor 与线程池就能在保持吞吐的同时,把最难处理的生命周期竞态压缩到清晰的消息边界上。