
AI Agent / 系统课时
长期记忆与向量存储
长期记忆与向量存储
长期记忆要解决的不是“把所有聊天都存下来”,而是让 Agent 在新会话里仍能找回稳定、相关且允许保存的信息。本节用向量检索搭建一条最小记忆链路,并说明写入筛选、召回过滤和删除边界。
学习目标
- 区分长期记忆与原始会话记录,确定值得持久化的内容。
- 理解“提取 → 向量化 → 存储 → 检索 → 注入上下文”的完整链路。
- 使用 Qdrant 完成带用户隔离的记忆写入与语义召回。
长期记忆应该保存什么
长期记忆适合保存跨会话仍有价值的信息,例如稳定偏好、长期目标、已确认的项目事实和用户明确要求记住的约定。一次性的寒暄、工具临时结果、未经确认的推测通常不应进入长期存储。
一条可检索记忆至少要同时保存两类数据:用于相似度搜索的向量,以及可读的原文和元数据。常见元数据包括 tenant_id、user_id、memory_type、created_at、来源会话和失效时间。租户与用户标识应由已经验证的服务端身份提供。这样检索时可以先按租户、用户或记忆类型过滤,再做向量相似度排序。
从写入到召回
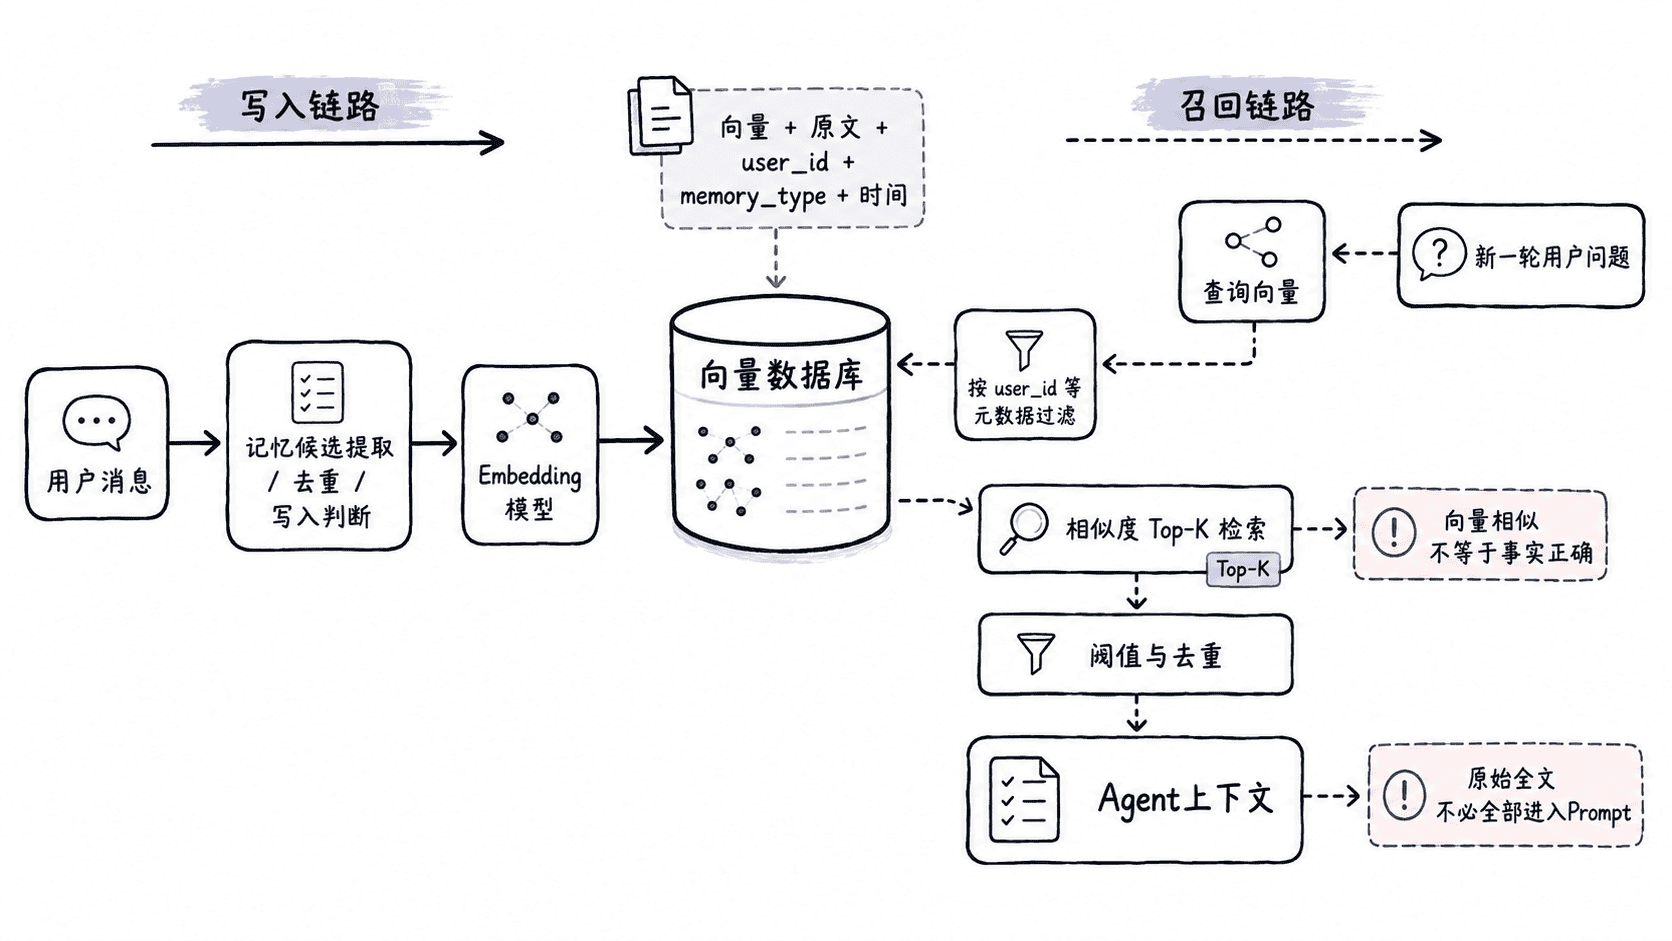
写入阶段的核心是“先判断是否值得记,再生成向量”;召回阶段则是“先限定作用域,再找相似内容”。如果跳过 user_id 等过滤条件,即使向量检索本身正确,也可能把别的用户或别的业务空间中的内容召回。
向量数据库返回的是“语义上接近的候选”,不是事实真值。Agent 仍应根据记忆来源、时间、类型和当前任务判断是否使用;对于会变化的事实,最好保留更新时间,并让权威数据源覆盖旧记忆。
用 Qdrant 跑通最小记忆库
示例使用 qdrant-client==1.15.1。每次在专用临时目录里创建本地存储,写入后关闭客户端并重开,验证磁盘数据确实可读。四维向量来自固定的教学规则,无需调用外部服务。生产系统应固定 Embedding 模型和输出维度,换模型或维度时应重新向量化或迁移集合。
import json
from tempfile import TemporaryDirectory
from uuid import NAMESPACE_URL, uuid5

from qdrant_client import QdrantClient, models


COLLECTION = "agent_memories"


def embed(text):
    if "界面" in text or "深色" in text:
        return [1.0, 0.0, 0.0, 0.0]
    if "邮件" in text:
        return [0.8, 0.0, 0.2, 0.0]
    return [0.0, 0.0, 0.0, 1.0]


def point(tenant, user, key, text, expires_at):
    stable_id = uuid5(NAMESPACE_URL, json.dumps([tenant, user, key]))
    return models.PointStruct(
        id=str(stable_id),
        vector=embed(text),
        payload={"tenant_id": tenant, "user_id": user,
                 "text": text, "expires_at": expires_at},
    )


def equality(key, value):
    return models.FieldCondition(key=key, match=models.MatchValue(value=value))


with TemporaryDirectory() as directory:
    client = QdrantClient(path=directory)
    try:
        client.create_collection(
            COLLECTION, vectors_config=models.VectorParams(
                size=4, distance=models.Distance.COSINE,
            )
        )
        client.upsert(COLLECTION, wait=True, points=[
            point("team-a", "u-42", "theme", "用户偏好深色界面", 200),
            point("team-a", "u-42", "mail", "用户不喜欢邮件通知", 200),
            point("team-a", "u-99", "theme", "别的用户的界面偏好", 200),
            point("team-b", "u-42", "theme", "别的租户的界面偏好", 200),
            point("team-a", "u-42", "expired", "已过期的界面偏好", 100),
        ])
    finally:
        client.close()

    client = QdrantClient(path=directory)
    try:
        now = 100  # 模拟服务器时间,expires_at 与它使用相同单位
        hits = client.query_points(
            collection_name=COLLECTION,
            query=embed("界面偏好"),
            query_filter=models.Filter(must=[
                equality("tenant_id", "team-a"),
                equality("user_id", "u-42"),
                models.FieldCondition(key="expires_at", range=models.Range(gt=now)),
            ]),
            with_payload=True,
            limit=5,
        ).points
        texts = [hit.payload["text"] for hit in hits]
        assert texts == ["用户偏好深色界面", "用户不喜欢邮件通知"]
        for text in texts:
            print(text)
    finally:
        client.close()
预期输出如下。
用户偏好深色界面
用户不喜欢邮件通知
示例故意写入与查询高度相关的其他用户、其他租户和已到期记录。查询前即限定租户、用户和时间范围。过期过滤只负责阻止召回,实际删除需另外执行。写入、修改和删除同样应按服务端鉴权所得范围限制;稳定 ID 用来重试和定位,不能作为授权凭据。
控制召回质量
不要把所有相似结果直接塞进模型上下文。通常先限制 Top-K,再结合相似度阈值、记忆类型、时间衰减和去重做二次筛选;对“用户明确偏好”与“模型曾经推断过的事实”也应设置不同可信等级。
当一次对话产生多条近义记忆时,优先更新已有记录或做摘要合并,避免向量库被重复内容淹没。长期记忆的目标是提供少量、可靠、可追溯的上下文,而不是把历史对话换一种形式永久堆积。