
AI Agent / 系统课时
RAG 基本原理
RAG 基本原理
RAG 把“从外部知识中找证据”和“让模型组织答案”拆成两个阶段,使 Agent 能利用模型参数之外的私有、专业或持续变化的信息。本节重点理解检索、上下文构造与生成之间的边界,以及 RAG 真正适合解决的问题。
学习目标
- 说明 RAG 从用户问题到最终回答的完整数据流
- 区分检索系统与生成模型各自负责的问题
- 判断哪些知识场景适合使用 RAG,以及哪些问题不能靠 RAG 自动解决
RAG 先找资料再生成答案
RAG 是 Retrieval-Augmented Generation,即检索增强生成。用户提出问题后,系统不会只依赖大模型训练时记住的内容,而是先到外部知识库检索相关资料,再把筛选后的内容连同问题一起交给模型生成答案。
一个典型链路包含查询理解、检索候选片段、过滤或重排、构造上下文、模型生成和结果返回。知识库通常来自产品文档、内部制度、技术手册或其他经过治理的数据源。
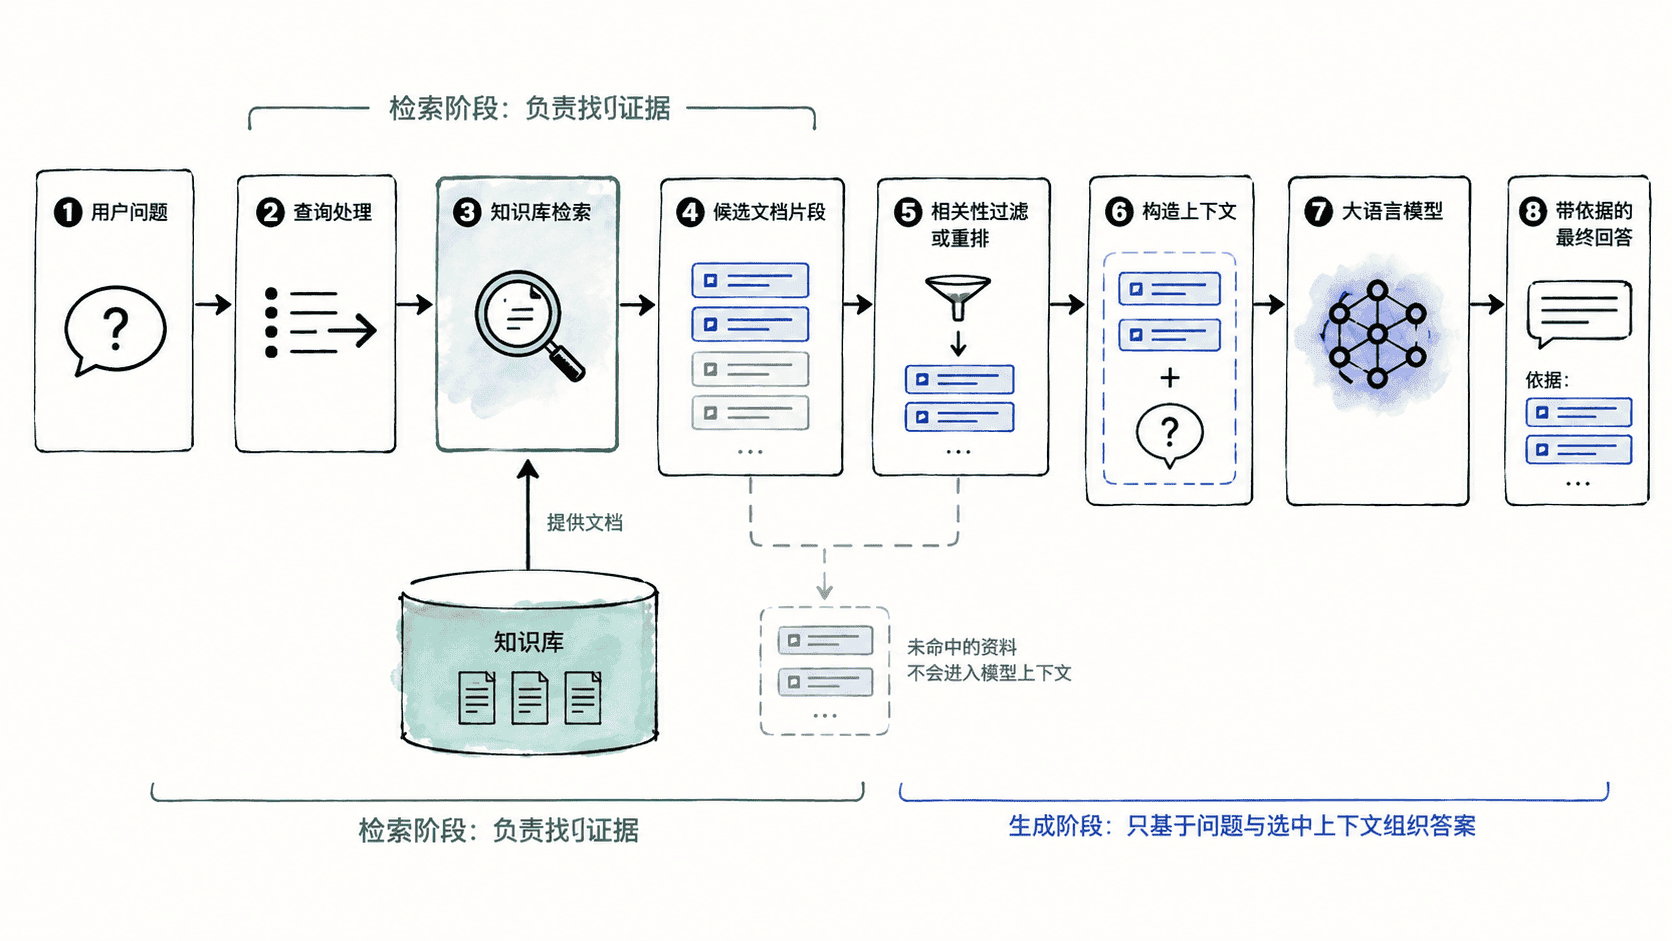
检索和生成解决不同问题
检索器回答的是“哪些资料与当前问题最相关”。它可能使用关键词检索、向量检索或混合检索,并返回若干候选片段。生成模型回答的则是“怎样根据这些片段组织一个符合用户意图的回答”。
例如用户询问“公司报销申请必须在多久内提交”,知识库中可能存在几十份制度文件。RAG 首先找到包含报销时限的相关段落,再把这些段落提供给模型。模型无需提前记住整套内部制度,也不需要重新训练才能利用更新后的文件。
这也说明了一个重要边界:检索增强的是上下文,不是模型参数本身。资料变更需要进入可查询的索引版本,并处理旧片段和缓存后,后续检索才会使用新资料。模型权重无需随文档更新。
检索质量决定答案上限
如果正确资料没有被检索出来,生成模型通常无法凭空恢复遗漏的事实。因此 RAG 的效果不能只看最终语言是否流畅,还要分别检查检索命中率和生成阶段是否忠实使用证据。
常见问题包括文档切分过碎导致语义不完整、切分过大引入无关内容、用户查询与文档措辞差异过大,以及检索出的多个片段互相矛盾。应用应根据已验证的用户和权限限定检索范围,在把候选加入上下文前再次检查版本及访问权限。文档正文属于检索数据,其中的指令文字不能提升权限或授权调用工具。
例如两份虚构制度分别写着“旧版,7 天内”和“现行版,15 天内”。若现行条款经核对覆盖当前问题,答案可写成“现行报销时限为 15 天,见制度 v2 第 4 条”。若检索只命中旧版,或不能确认哪一版适用,就应说明缺少可确认的现行证据,并给出需要查证的范围。
判断什么时候值得使用 RAG
RAG 很适合知识量较大、内容经常变化或无法放进模型训练数据的场景,例如企业内部知识问答、产品文档助手、技术支持 Agent 和需要引用专业资料的分析任务。更新知识时通常只需更新索引,而不必重新训练模型。
如果任务主要依赖通用推理、数学计算或固定规则,加入检索层未必有价值。对于库存、订单状态、实时监控指标等必须读取当前系统状态的问题,也更适合直接调用数据库或业务 API;RAG 可以解释文档,却不能代替实时事实查询。
设计 RAG 时可以始终沿着一条证据链检查:问题是否找到了正确资料,正确资料是否进入了上下文,最终回答是否忠实依据这些资料。分别核对候选中的有效来源、实际入模片段,以及答案引用能否支持关键结论。仅有一个合法的引用编号,还要继续核对其内容和适用范围。