
AI Agent / 系统课时
任务分解与子任务编排
任务分解与子任务编排
复杂任务真正难的不是“拆得越细越好”,而是把目标拆成有明确输入、输出和依赖关系的可执行单元,再按依赖顺序调度,并在失败时只重跑必要部分。
学习目标
- 把模糊目标拆成边界清晰、可验收的子任务
- 使用依赖关系识别可串行与可并行执行的任务
- 实现一个能检测阻塞与循环依赖的最小 DAG 调度器
从目标拆成可验收子任务
一个好的子任务应能回答四个问题:输入是什么、产出是什么、依赖谁、怎样算完成。比如“生成发布说明”不要直接拆成“分析一下”“再写一下”这种不可验收动作,而应拆成“收集提交记录”“读取发布配置”“汇总变更”“检查风险”“合成发布说明”等明确结果。
拆分粒度应服务于调度和恢复。任务太大,一处失败就要整体重跑;任务太小,则会增加模型调用次数、状态传递和调度开销。通常以“可以独立验证,并且失败后值得单独重试”为合适边界。
用依赖图组织执行顺序
子任务之间通常不是一条直线。全部前置节点都成功后,任务才具备运行条件。同一批任务还需满足资源约束才能并行,例如不能未经协调地写同一文件。这样的依赖网络可建模为有向无环图,也就是 DAG。
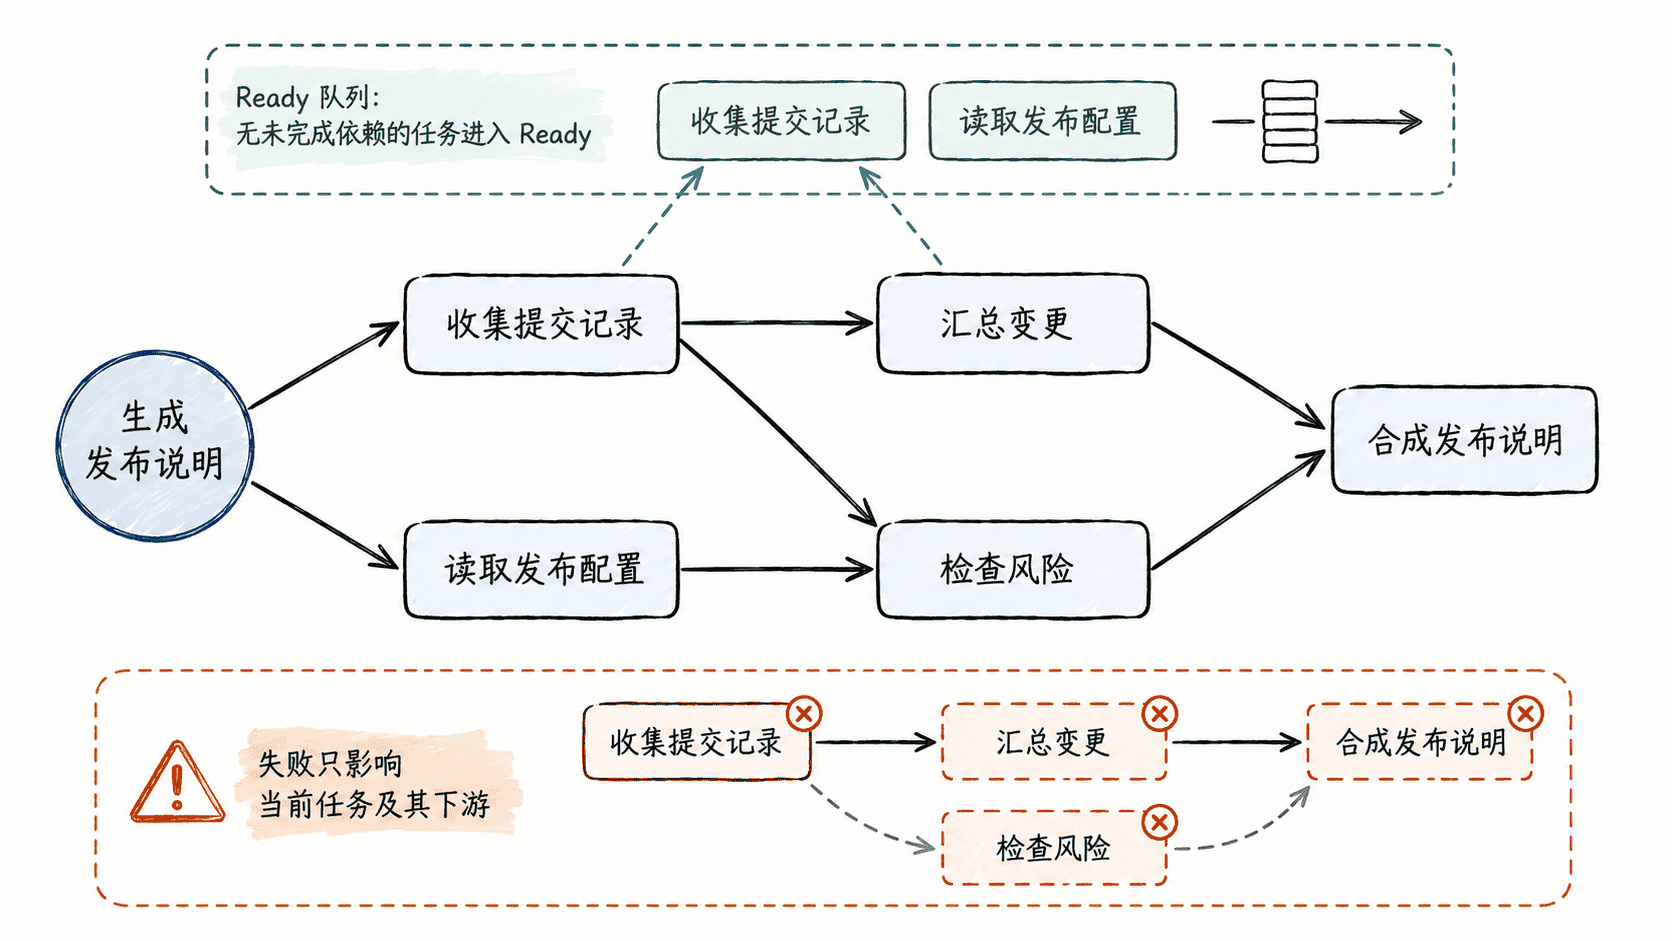
DAG 的价值是把“执行顺序”从自然语言里显式化。这样调度器可以自动发现并行机会,也能在任务永久失败时准确知道哪些下游任务不能继续。
实现一个最小 DAG 调度器
下面用 Python 模拟发布说明生成流程。为了聚焦编排,任务函数返回固定结果;调度器先区分缺失依赖和循环依赖,运行时再区分节点失败与下游阻塞。
from graphlib import CycleError, TopologicalSorter

TASKS = {
    "commits": (set(), lambda _: "export"),
    "config": (set(), lambda _: "1.8.0"),
    "risk": ({"config"}, lambda _: "low"),
    "compose": ({"commits", "risk"}, lambda out: f"{out['commits']}, risk={out['risk']}"),
}

def run_dag(tasks, simulate_failure=None):
    graph = {name: dependencies for name, (dependencies, _) in tasks.items()}
    missing = {dep for dependencies in graph.values() for dep in dependencies} - graph.keys()
    if missing:
        raise ValueError(f"missing dependencies: {sorted(missing)}")

    order = TopologicalSorter(graph)
    try:
        order.prepare()
    except CycleError as error:
        raise ValueError(f"dependency cycle: {error.args[1]}") from error

    status = {}
    output = {}
    while order.is_active():
        for name in sorted(order.get_ready()):
            dependencies, task = tasks[name]
            if any(status[dep] != "succeeded" for dep in dependencies):
                status[name] = "blocked"
            else:
                try:
                    if name == simulate_failure:
                        raise RuntimeError("simulated failure")
                    output[name] = task({dep: output[dep] for dep in dependencies})
                except RuntimeError:
                    status[name] = "failed"
                else:
                    status[name] = "succeeded"
            order.done(name)
    return status, output

print(run_dag(TASKS))
print(run_dag(TASKS, simulate_failure="config"))
成功时,最终产物是 export, risk=low。模拟配置失败时,独立的 commits 仍成功,risk 和 compose 变成 blocked。TopologicalSorter.done 只表示该节点已被调度器处理,因此失败也要标记。业务状态保存在 status,用于判断下游能否真正运行。本例串行执行同批任务,展示的是调度逻辑。
失败、重试与重新规划
失败处理应基于依赖图,而不是简单“从头再来”。临时网络错误可以对当前子任务做有限次数重试;输入缺失或权限不足属于前置条件失败,应立即停止相关下游;如果执行结果证明原计划不再成立,例如发现目标 API 不支持某能力,才需要重新规划后续 DAG。
调度器还应保存任务状态,例如 Pending、Running、Succeeded、Failed,以及输出摘要和错误原因。恢复时只需重新调度失败任务和受其影响的下游,而不必重复已经成功且结果仍有效的节点。
用验收条件约束规划结果
任务分解的终点不是“所有节点都跑过”,而是总目标满足验收条件。对于发布说明,可以检查版本号是否存在、变更摘要是否非空、风险检查是否完成、最终文档是否成功生成。只有这些条件成立,整个计划才应标记为完成。
因此,一个可靠的 Agent 规划器应同时维护依赖关系和验收条件:依赖关系决定“先做什么”,验收条件决定“什么时候真的做完”。这两者结合后,复杂任务才能被稳定地调度、重试和恢复。