
AI Agent / 系统课时
项目需求分析与架构设计
项目需求分析与架构设计
本项目以“智能客服工单 Agent”为实战目标:用户提交订单或售后问题,Agent 判断需要哪些只读工具,获取知识库与订单事实,再生成可审计的答复。先把需求、边界和模块契约定清楚,后续实现才不会把模型能力与业务权限混在一起。
学习目标
- 把模糊的“做一个 Agent”拆成可验收的输入、输出与失败边界
- 设计模型、编排器、工具、状态与审计之间的职责关系
- 用最小项目契约约束后续代码实现和验收方式
先固定可验收的项目边界
实战场景只解决一条主链:用户询问“订单为什么还没发货”,Agent 可以查询知识库规则和订单状态,然后生成答复。第一版不允许修改订单、不自动退款,也不直接访问数据库;订单状态和规则必须通过工具取得。订单编号来自请求,账户身份来自已认证入口,读取订单前须校验归属。
验收标准应当在写代码前确定。一次成功运行至少满足:能接收自然语言问题;最多执行 4 个 Agent 步骤;只调用白名单工具;工具调用记录名称和分类后的执行结果;拿到足够事实后停止循环并给出最终答复;任何越权写操作都被拒绝。
把需求变成一条执行链
用户请求进入系统后,先由 Agent 编排器保存本次运行状态,再把当前问题和已取得的观察结果交给模型。模型只能返回两类动作:调用某个工具,或结束并给出最终答案。工具执行结果重新进入运行状态,直到得到答案或达到步数上限。
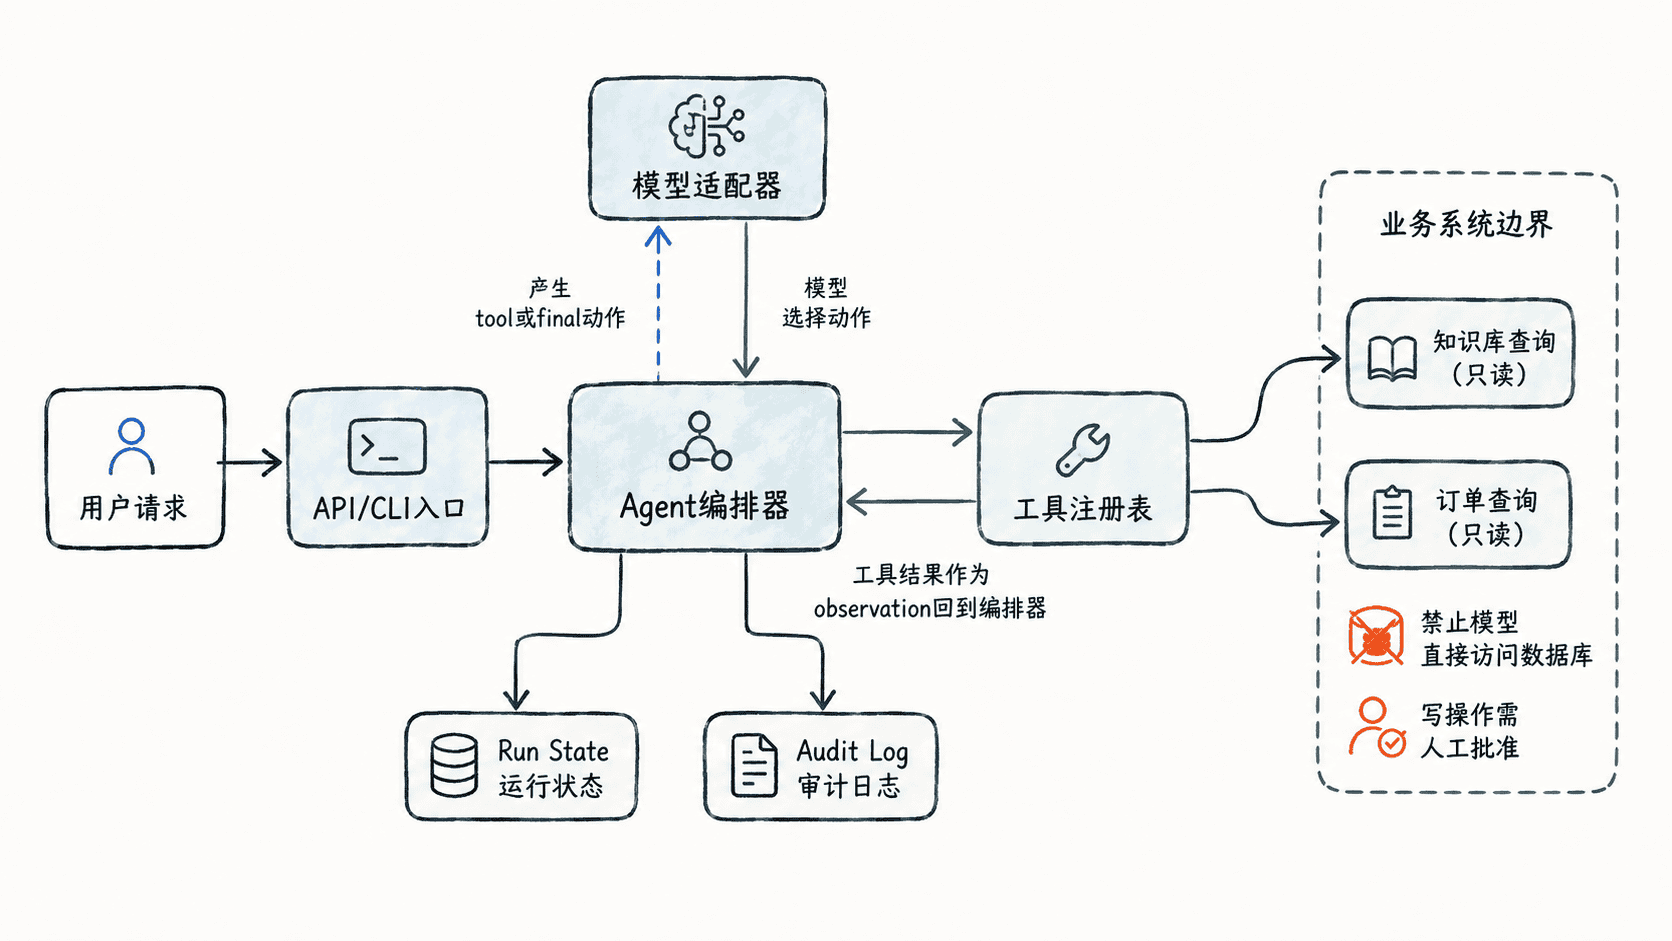
这条链路的关键不是“让模型拥有更多能力”,而是让模型只负责决策,让工具负责受控访问业务系统,让编排器负责循环、超时、步数和审计。这样模型即使输出错误工具名,也只会在编排层失败,而不会绕过权限边界。
明确模块职责和数据契约
项目可以拆成五个模块:入口层负责接收问题;模型适配器把上下文转换成 tool 或 final 动作;Agent 编排器负责循环;工具层校验参数并调用外部能力;状态与审计层记录每一步。模块之间只传结构化数据,不让模型直接拼接 SQL、HTTP 地址或凭据。
| 模块 | 负责什么 | 不负责什么 |
|---|---|---|
| 入口层 | 接收问题、生成运行 ID | 决定调用哪个工具 |
| 模型适配器 | 产生下一步动作 | 直接访问业务系统 |
| Agent 编排器 | 步数、循环、错误与停止 | 实现具体业务查询 |
| 工具层 | 参数校验、权限与业务访问 | 自行决定对话策略 |
| 状态与审计 | 保存观察结果和调用记录 | 修改模型决策 |
建议先把这些约束写成项目契约,后续实现必须服从它,而不是边写代码边改变规则。
project: support-agent
entrypoint: cli
max_steps: 4

actions:
  - tool
  - final

tools:
  read:
    - search_kb
    - get_order_status
  write: []

audit:
  record_tool_name: true
  record_argument_summary: false
  record_result_status: true

acceptance:
  - no_direct_database_access
  - reject_final_without_required_evidence
  - check_order_belongs_to_account
  - reject_unregistered_tools
  - fail_when_max_steps_exceeded
这段 YAML 是配置契约,不是可执行脚本。验证时要逐项映射到代码:max_steps 对应循环上限,tools.read 对应注册表白名单,write 为空意味着第一版不存在自动写操作,各条验收约束对应第三节的测试或实现中的运行时检查。
先设计失败,再开始实现
Agent 最常见的问题不是正常路径,而是“模型要求调用不存在的工具”“工具超时”“参数缺失”“工具返回错误事实”以及“循环一直不结束”。因此架构阶段就要决定:未知工具立即失败;工具异常被记录为观察结果或转人工;每次运行有最大步数;写工具必须独立审批;日志中不得记录密钥和完整敏感数据。
第一版项目的完成标准不是功能最多,而是边界最清楚:只读工具能够稳定返回事实,模型只能在受控动作集合里决策,编排器能够停止、失败和审计。这套契约可以直接作为核心实现、自动化测试和上线评审的共同验收基线。