
AI Agent / 系统课时
ReAct 推理框架
ReAct 推理框架
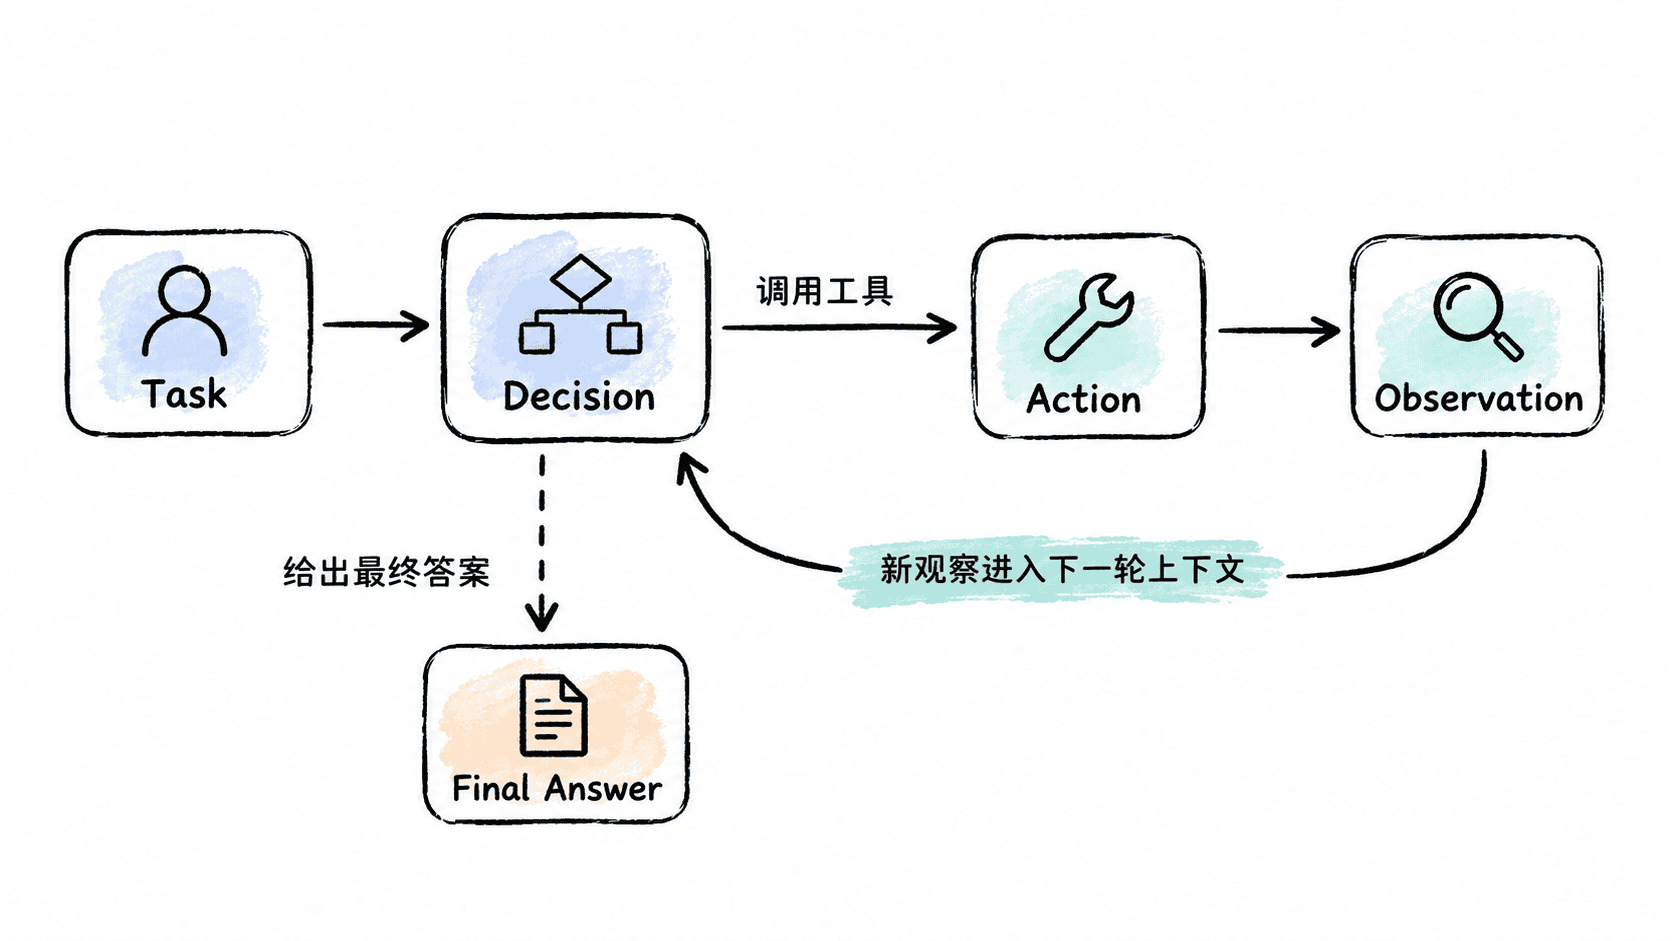
ReAct 解决的是 Agent 不能只“想”也不能只“做”的问题:它把决策、工具调用和环境观察串成循环,让模型依据最新结果决定下一步,直到得到答案或触发停止条件。
学习目标
- 说清 ReAct 中决策、行动、观察三者的职责与循环关系
- 实现一个带工具调用、观察回填和停止条件的最小 ReAct Agent
- 识别无限循环、错误工具调用和不可验证输出等常见风险
ReAct 的核心循环
ReAct 可以理解为“根据当前状态决定下一步动作,再把动作结果加入状态”。论文与早期示例常用 Thought、Action、Observation 表达这一过程;在工程实现中,不需要把模型的完整内部推理暴露出来,只要让模型输出可执行的动作决策、参数和最终答案即可。
一次循环通常包含三类状态:当前任务、已有观察结果、下一步决策。若决策是工具调用,运行工具并得到 Observation;若决策是 Final,则结束循环。关键不是固定标签,而是“新观察必须影响下一次决策”。
用结构化动作实现最小 ReAct
下面的示例不用外部模型服务,而是用确定性的 decide 函数模拟“模型决策”,这样可以直接运行并观察 ReAct 控制循环本身。接入模型时,可以让模型提出结构化动作。宿主仍负责校验动作、执行工具、检查完成证据和处理超时。
def decide(observations):
    if "read_primary" not in observations:
        return "read_primary"
    if observations["read_primary"] is not None:
        return "finish"
    if "read_backup" not in observations:
        return "read_backup"
    return "finish"


def run_agent(primary, backup, max_steps=3, choose=decide):
    tools = {"read_primary": lambda: primary, "read_backup": lambda: backup}
    observations = {}

    for _ in range(max_steps):
        decision = choose(dict(observations))
        if decision == "finish":
            value = observations.get("read_primary")
            if value is None:
                value = observations.get("read_backup")
            if value is None:
                return "no_evidence", None, list(observations)
            return "ok", value, list(observations)
        if decision not in tools:
            return "tool_denied", None, list(observations)
        if decision in observations:
            return "duplicate_action", None, list(observations)
        observations[decision] = tools[decision]()

    return "step_limit", None, list(observations)


print(run_agent(391, None))
print(run_agent(None, 391))
print(run_agent(None, None))
print(run_agent(None, 391, max_steps=2))
主源有结果时,只查一次。主源返回 None 时,下一步改查备用源。两边都没有数据时返回 no_evidence。最后一组虽然查到了备用源,但步数用尽,来不及走完成校验,因此返回 step_limit。这里的数字是合成数据。调用真实工具时,暂时超时、查无记录与权限拒绝应保留各自的状态,后续可以采取不同动作。
给循环加上工程边界
实际 Agent 至少需要三类边界。第一是步数或时间上限,防止模型在同一工具之间反复循环;第二是工具白名单与参数校验,避免生成一个名称正确但参数危险的调用;第三是可验证的结束条件,例如必须拿到订单状态、测试通过或目标文件生成成功后才能结束。
还应记录每轮的动作名、参数摘要、工具耗时和结果状态,用于调试与审计。日志可以保存“调用了什么、得到什么”,但不需要保存或展示模型的私有思维链。
什么时候使用 ReAct
ReAct 适合步骤数事先不完全确定、每一步都可能产生新信息的任务,例如检索后继续查询、根据 API 返回值选择下一接口、排查失败后切换诊断动作。若任务本身是固定流程,例如“读取文件后按模板转换再保存”,直接使用确定性工作流通常更简单、成本更低,也更容易测试。
先看决策分支能否在程序里穷举。主源失败后查备用源这类固定分支可直接写成规则。遇到需要结合不断新增的证据选择行动、路径难以预先列全的任务,再考虑让模型参与决策。