
AI Agent / 系统课时
日志、监控与可观测性
日志、监控与可观测性
Agent 出错时,仅看到“回答不对”无法判断问题发生在模型调用、工具执行还是编排逻辑。本课建立一条最小可观测链路:用结构化日志记录关键事件,用关联 ID 串起一次请求,再用 Trace 查看内部调用路径,并据此定义监控指标和告警。
学习目标
- 为 Agent 运行记录可检索、可关联的结构化日志
- 用关联 ID 和 Trace 把一次请求中的模型与工具调用串起来
- 选择错误率、延迟、用量和质量信号建立监控与告警
先明确三类证据
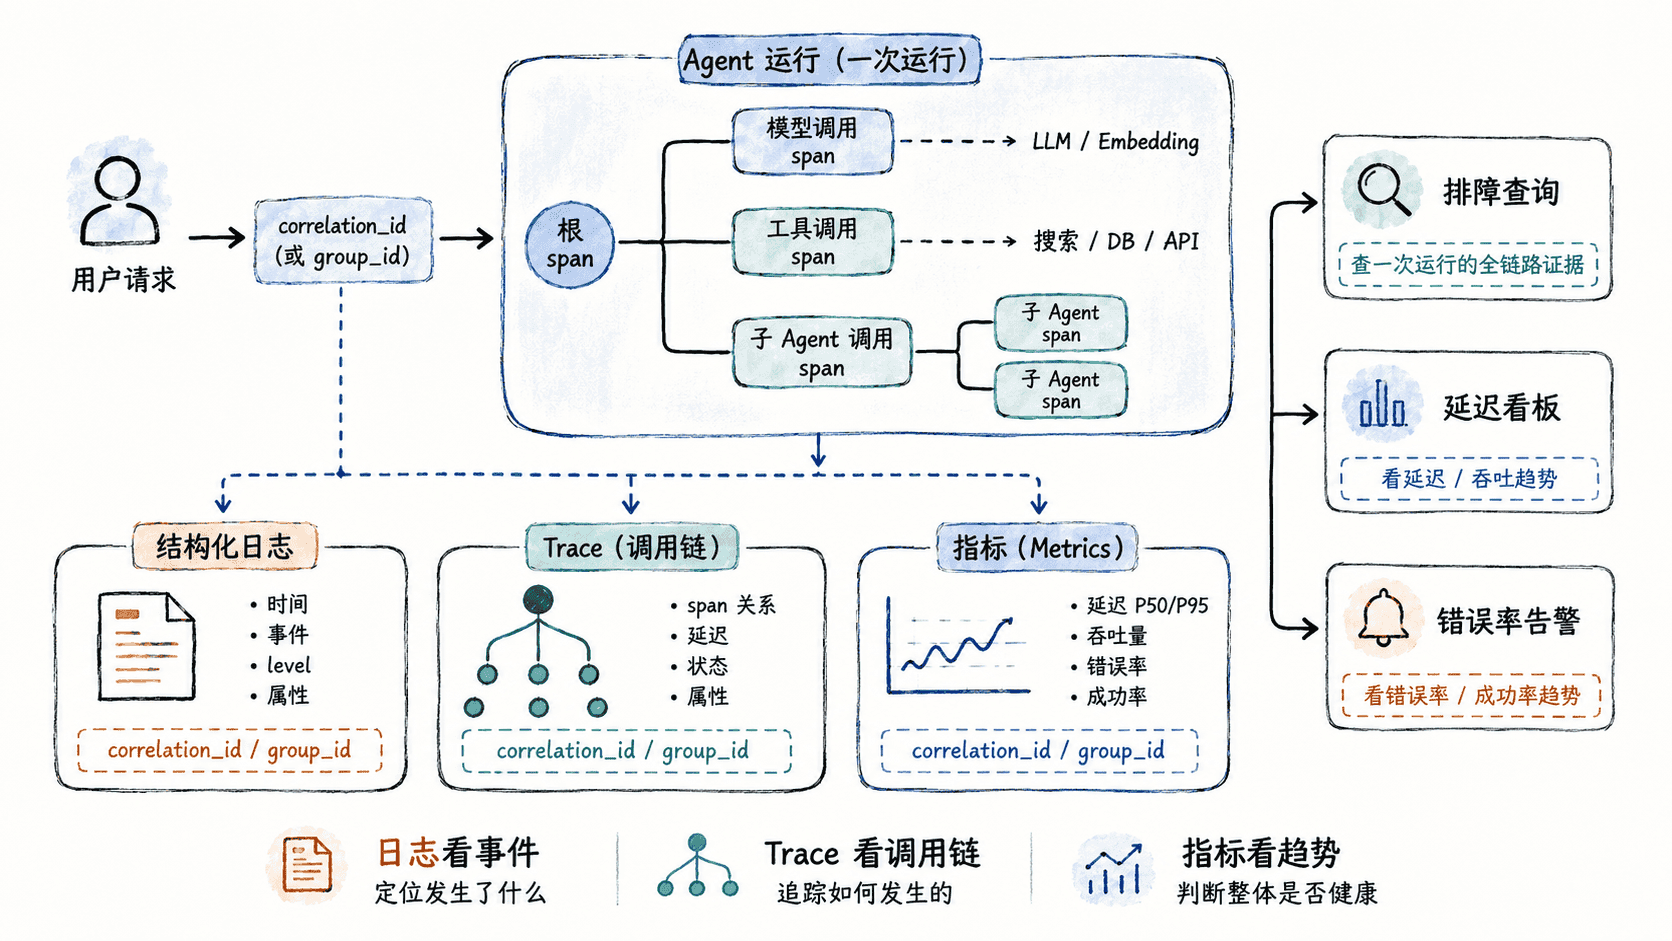
日志回答“发生了什么”,Trace 回答“时间花在哪一段调用上”,指标回答“系统整体是否正在恶化”。日志可以保存 trace ID 来关联单次请求。指标只应按服务、工具、结果类别等有限维度聚合,可在支持的后端用 exemplar 从指标样本跳到 trace。请求 ID 不应作为常规指标标签。
| 证据 | 适合回答的问题 | 最小字段 |
|---|---|---|
| 结构化日志 | 哪次请求失败、失败类型是什么 | event、correlation_id、agent、outcome |
| Trace | 哪个 Agent、模型或工具最慢 | workflow、span、父子关系、耗时 |
| 指标 | 错误率和延迟是否持续升高 | 请求数、错误数、延迟分布、用量 |
为一次运行建立关联 ID
在第一章的虚拟环境中安装 openai-agents。下面示例用 SDK 创建 trace 和工具 span,并在日志里同时写入 SDK 的 trace ID 和应用请求 ID。工具读取固定测试数据。作为独立演示脚本,它用 set_trace_processors([]) 移除进程中的所有 trace 处理器,避免导出事件。不要把这行直接放进已有共享遥测配置的应用。
import json
import time
import uuid

from agents import function_span, set_trace_processors, trace

def emit(event, **fields):
    print(json.dumps({"event": event, **fields}, ensure_ascii=False))

def lookup_order(order_id):
    if order_id != "demo":
        raise LookupError("unknown order")
    return "paid"

def run(order_id):
    started = time.perf_counter()
    correlation_id = uuid.uuid4().hex
    with trace("support-request", group_id=correlation_id) as workflow:
        fields = {"correlation_id": correlation_id, "trace_id": workflow.trace_id}
        emit("agent.run.start", **fields)
        try:
            with function_span("lookup_order") as span:
                emit("tool.start", span_id=span.span_id, **fields)
                status = lookup_order(order_id)
        except LookupError as error:
            emit("agent.run.error", outcome="error", error_type=type(error).__name__,
                 latency_ms=round((time.perf_counter() - started) * 1000, 1), **fields)
            return None
        emit("agent.run.finish", outcome="ok",
             latency_ms=round((time.perf_counter() - started) * 1000, 1), **fields)
        return status

if __name__ == "__main__":
    set_trace_processors([])
    run("demo")
    run("absent")
脚本输出六行 JSON。前 3 行是开始、工具开始、完成,后 3 行是开始、工具开始、错误。每次运行内部的两个 ID 一致,不同运行各有一对 ID。示例配置下可从日志核对关联关系。若部署在已配置导出器的环境,可用同一个 SDK trace ID 查找调用链。
OpenAI Agents SDK 的默认跟踪路径可能记录模型或工具的输入输出。真实调用前按数据约束选择导出位置与保留方式,可用 RunConfig(trace_include_sensitive_data=False) 限制 SDK 自动 span 的敏感内容。手工写入的日志、metadata 和自定义 span 属性仍要单独审查。
把运行数据变成监控信号
监控不要从“有哪些字段可采集”开始,而要从“什么变化需要人工介入”开始。Agent 服务至少关注四类信号:请求成功与错误率、端到端和关键 span 的延迟、模型或工具用量、任务质量信号。
延迟应看分布而不是只看平均值,例如持续观察 p50、p95 和 p99;错误也要区分模型超时、工具失败、权限拒绝和业务校验失败。质量信号可以来自结构化验收、人工升级率或规则命中率,不能只用 HTTP 200 代替“任务成功”。
用同一关联键排查一次故障
出现告警后,先按时间窗口和错误类型找到异常日志,再用 correlation_id 锁定具体请求;随后查看该请求对应的 Trace,判断耗时或错误落在模型、工具还是子 Agent;最后回到相应组件的细粒度日志确认根因。
这条顺序能避免“先翻所有日志”的低效做法。日志负责找到样本,Trace 负责缩小故障边界,指标负责确认它是单点异常还是系统性趋势。
生产环境不要记录过量数据
可观测性系统本身也有成本和安全边界。不要默认记录完整提示词、用户消息、工具返回体或密钥;对高基数字段谨慎做指标标签;对成功请求可采样 Trace,但错误、超时和高延迟请求应提高保留率。
最终要做到的是:从一条告警能定位到一批异常请求,从其中一个 correlation_id 能找到完整调用链,再从具体 span 回到可执行的修复动作。这样日志、监控和 Trace 才构成真正的排障体系。