
AI Agent / 系统课时
短期记忆与上下文管理
短期记忆与上下文管理
短期记忆解决的是“本轮 Agent 怎样带着必要信息继续工作”。由于模型每次调用都受上下文窗口限制,应用必须主动决定保留什么、丢弃什么、何时摘要。本篇给出一套可直接落地的裁剪顺序和摘要策略。
学习目标
- 理解上下文窗口为什么会成为 Agent 的硬约束
- 按信息价值设计“保留、裁剪、摘要”三类处理
- 避免摘要失真、关键信息丢失和上下文无限增长
上下文窗口不是永久记忆
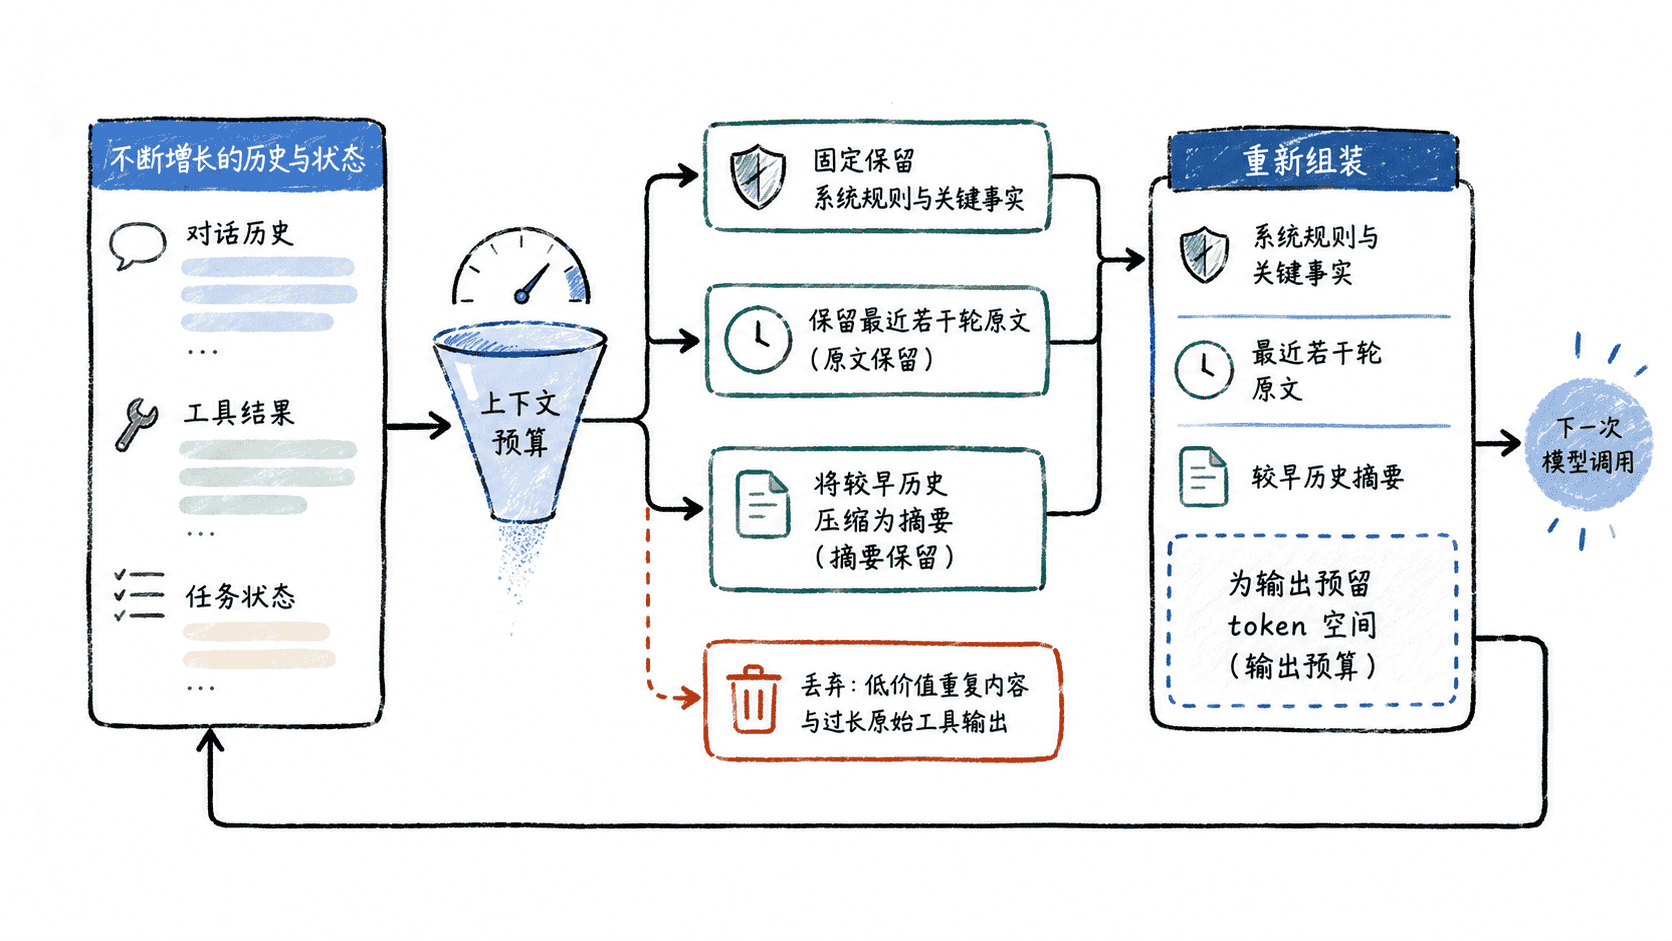
模型一次推理能够读取的内容总量有限,系统提示、用户消息、历史回复、工具结果以及本次需要生成的输出都会共同占用上下文预算。对话持续变长后,应用不能简单地把全部历史原样重复发送。
短期记忆可以由应用显式组装,也可以在支持的接口上用服务端会话标识衔接。无论采用哪种方式,应用都应保存任务状态、授权结论和工具执行记录。显式组装时,每次调用模型前,从历史记录中挑选当前任务仍然需要的信息,再组装成新的上下文。彼此独立的模型请求不会自动继承历史。如果使用 Responses API 的 previous_response_id 串联响应,上一轮 instructions 不会自动带到下一轮,需要重新传入仍然有效的应用指令。
先分信息价值再做裁剪
裁剪不应只按“最旧优先删除”。更稳妥的做法是先给信息分层,再决定保留方式。
| 信息类型 | 推荐处理 |
|---|---|
| 系统规则、安全约束、任务目标 | 固定保留,不参与普通裁剪 |
| 用户明确确认的关键事实 | 保留原文或结构化状态 |
| 最近几轮推理所需上下文 | 优先保留原文 |
| 较早但仍有用的讨论 | 压缩成摘要 |
| 重复寒暄、已失效分支 | 直接丢弃 |
| 很长的工具原始输出 | 提取结论、ID、错误码等必要字段 |
这套顺序的重点是:先保护不可丢的信息,再压缩可替代的信息,最后删除低价值信息。如果一开始只按消息条数截断,很容易把任务目标或用户刚确认的限制一起删掉。
一套可执行的压缩流程
每次准备调用模型时,可以按固定顺序构造上下文:
- 先放入必须长期生效的系统规则和当前任务目标。
- 加入不能被摘要替代的结构化状态,例如用户选择、任务阶段、关键 ID。
- 从最新消息向前保留若干轮原始对话,保证局部语义连续。
- 对更早但仍相关的历史生成摘要,只保留事实、决策、未完成事项和约束。
- 删除重复内容与已完成分支,对超长工具结果只保留后续推理真正需要的字段。
- 检查完整请求的 token 用量,包括消息、工具定义与结果,并预留输出和安全空间。例如假设窗口为 8000 token,给本次输出留 1000,再留 500 的余量,输入目标最多为 6500。实际口径按模型和接口计数。
摘要应描述“发生了什么”和“哪些约束仍有效”,而不是重写一遍聊天内容。对于金额、日期、标识符、用户明确选择等高风险事实,最好保存为独立结构化字段,不只依赖自然语言摘要。
防止摘要越压越错
长期运行的 Agent 如果不断“摘要上一版摘要”,误差可能逐轮累积。更可靠的做法是保留可追溯的原始记录,并在需要重新压缩时,从原始消息或结构化事件中生成新摘要,而不是无限递归压缩旧摘要。
工具调用与对应结果要按协议成组保留,尤其要保留匹配的调用标识。若整组旧交互已结束,可以在确认恢复状态后压缩成摘要;尚未完成的工具动作要从应用的持久化记录判断,不能由摘要猜测。网页正文、日志和数据库结果常常比聊天消息更占空间;如果后续只需要“错误码为 429、请求 ID 为 <ID>”,就不应把数千行原始文本持续塞回上下文。
什么时候触发压缩
最简单的策略不是“每轮都摘要”,而是在上下文使用量接近预算阈值时触发压缩,同时保留最近窗口。例如可以在输入目标用量达到七成时开始整理历史,并在组装完成后再次检查上限。比例只是一个可调整的触发点,单次工具结果也可能超过剩余空间。
压缩后的上下文必须仍能回答三个问题:当前目标是什么、已经确认了什么、下一步还缺什么。只要这三项能够稳定保留,短期记忆就不再是“聊天记录越存越多”,而是一套受预算约束、可校验的运行状态管理机制。