
AI Agent / 系统课时
自我反思与纠错机制
自我反思与纠错机制
一个可靠的 Agent 不应把第一次生成结果直接当作最终答案。本节用“生成、评估、定位问题、定向修正、停止”的闭环,说明如何把反思变成可验证、可终止的纠错过程,而不是让模型无限重复思考。
学习目标
- 解释生成器、评估器和修正步骤在反思流程中的职责
- 设计带明确评价标准与停止条件的纠错循环
- 识别无限重试、错误自证和无效改写等常见风险
反思不是简单地再问一次模型
最弱的做法是把第一次答案重新交给模型,再问一句“请检查是否正确”。这种方式没有明确判据,模型可能只是换一种措辞,也可能继续坚持原来的错误。
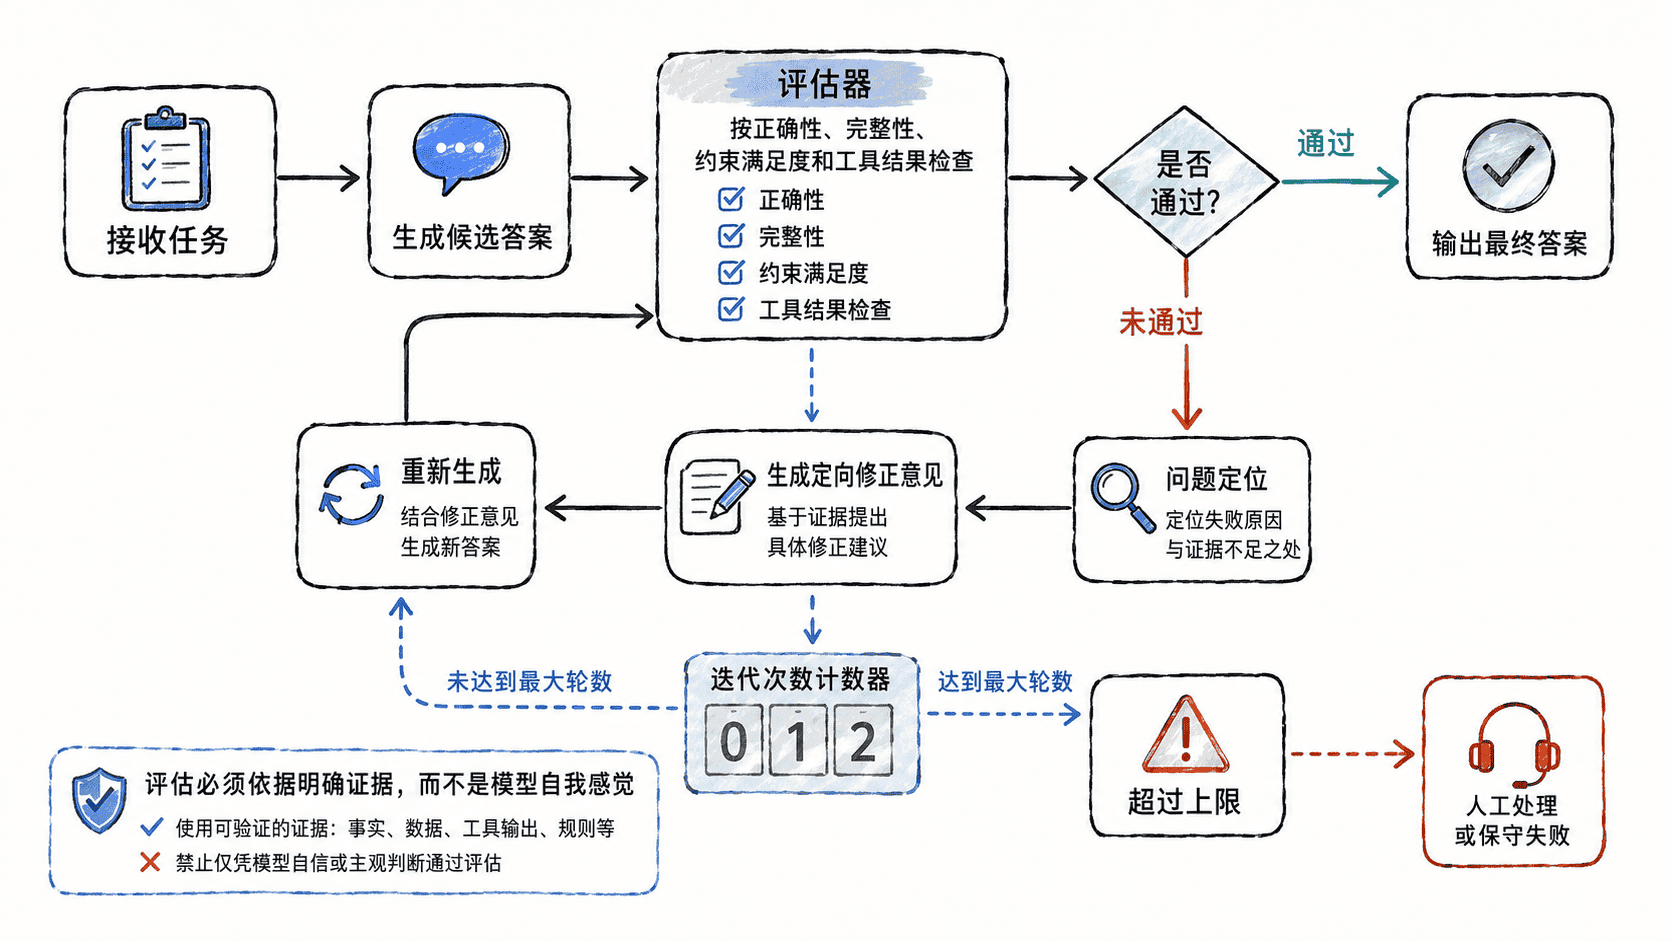
有效的反思需要把一次任务拆成几个可检查的阶段:先产生候选结果,再依据任务要求、工具执行结果或外部事实进行评估;只有发现具体问题时才生成修正指令,然后重新检查修正版。
给评估器明确的判据
反思是否有效,主要取决于“怎样判错”。评价标准应该来自任务本身。例如代码 Agent 可以检查测试是否通过,数据 Agent 可以检查查询结果是否满足约束,使用工具的 Agent 可以核对工具返回值,而不是只让语言模型主观打分。
评价结果最好同时包含“是否通过”和“具体问题”。修正器随后只处理已经定位的问题,避免每轮都重写整份答案。对于高风险任务,还应优先使用程序校验、测试、规则引擎或权威数据源提供证据。
实现一个有限纠错循环
下面的可运行 Python 示例用确定性规则模拟评估器,重点展示控制循环。真实 Agent 可以由模型提出报告修订,由确定性程序检查字段是否与独立测试结果一致。
def verify_report(report, checks):
    expected = {
        "total": len(checks),
        "failed": sum(not passed for passed in checks.values()),
        "ready": all(checks.values()),
    }
    errors = {}
    for field, value in expected.items():
        actual = report.get(field)
        if type(actual) is not type(value) or actual != value:
            errors[field] = value
    return errors


def revise(report, evidence, fix, limit):
    candidate = dict(report)
    for edits in range(limit + 1):
        corrections = verify_report(candidate, evidence)
        if not corrections:
            return "verified", candidate, edits
        if edits == limit:
            return "limit", candidate, edits
        updated = fix(dict(candidate), corrections)
        if updated == candidate:
            return "stalled", candidate, edits
        candidate = updated


checks = {"startup": True, "rollback": False}
initial = {"total": 2, "failed": 0, "ready": True}
print(revise(initial, checks, lambda draft, errors: {**draft, **errors}, limit=2))
print(revise(initial, checks, lambda draft, errors: draft, limit=2))
print(revise(initial, checks, lambda draft, errors: {**draft, **errors}, limit=0))
第一组在一次改动后返回 verified,报告为 {'total': 2, 'failed': 1, 'ready': False}。这表示报告准确,测试仍有一项失败。第二组未修正内容,返回 stalled。第三组没有改动预算,返回 limit。测试证据由验证器持有,修正器只能改候选报告;实际系统还需检查测试来源、时效和覆盖面。
设置停止条件与失败出口
反思循环至少应在“已经通过评价”和“达到最大轮数”两种情况下停止。还可以增加成本预算、总耗时、连续两轮无改善等条件,防止 Agent 因一个无法解决的问题持续消耗模型调用。
如果达到上限仍然失败,不应把最后一次结果伪装成成功。更稳妥的做法是保留已发现的问题,返回受限结果,或者把任务升级给人工处理。这样,反思机制提升的是结果可靠性,而不是单纯增加模型思考次数。