
AI Agent / 系统课时
成本控制与性能优化
成本控制与性能优化
AI Agent 的成本与延迟通常不是由单次模型调用决定,而是被规划轮次、上下文长度、工具调用和重试共同放大。本课建立一套可量化的优化方法:先测调用链,再削减无效轮次与 Token,最后用缓存、并发和模型分层验证收益。
学习目标
- 能把一次 Agent 请求拆成模型、工具、重试和上下文四类成本来源
- 能用可观测指标定位慢点,并针对调用次数与上下文长度做优化
- 能用质量、延迟和成本三项指标验证优化是否真正有效
先把成本和延迟拆开测
不要从“换更便宜的模型”开始。一个 Agent 可能为了同一问题连续规划 5 次、重复传入整段历史消息,并在工具失败后自动重试。此时模型单价只是表面因素,真正应先记录每次运行的模型调用次数、输入输出 Token、工具耗时、重试次数和总耗时。
可以把单次请求成本近似看成:
其中 表示 Token 数, 是每 Token 单价, 是搜索或其他外部工具成本。价目若按每百万 Token 给出,代入前要除以 。输入的普通、缓存命中和缓存写入部分按对应模型的适用费率互斥计数。延迟则更受串行链路影响:即使每次调用都不慢,五个依赖前一步结果的调用也会累加等待时间。
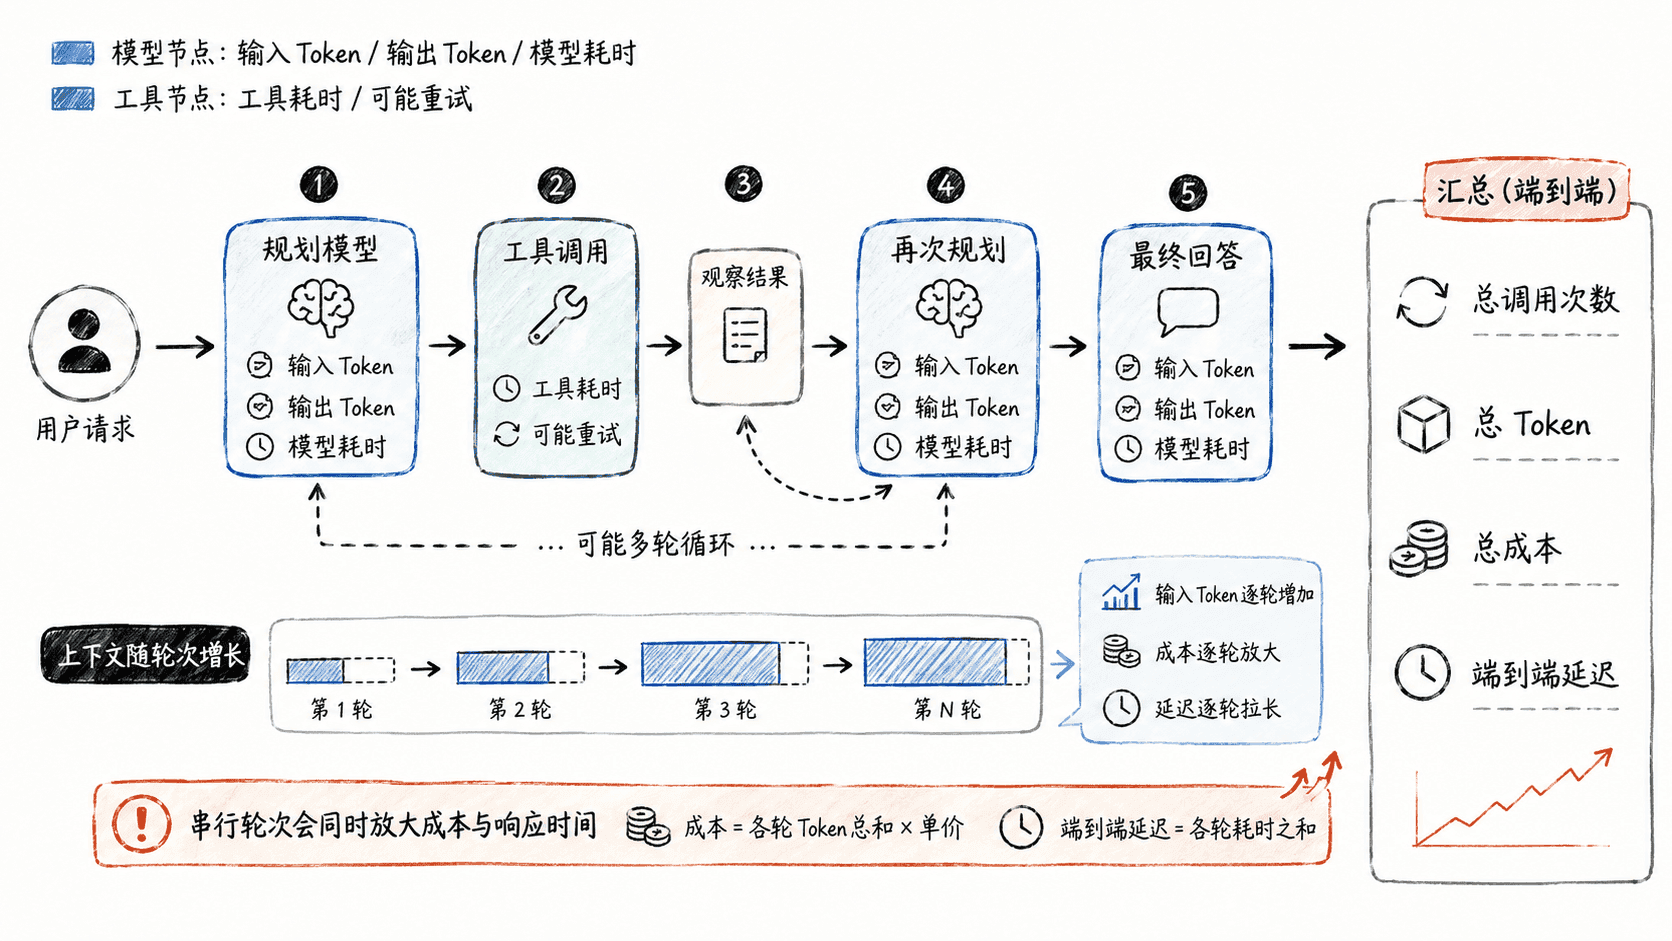
下面用合成的 usage 和时间线比较两种编排。费率只用于教学计算。真实数据应读取 SDK 返回的用量和服务当前价目。
from decimal import Decimal

MILLION = Decimal(1_000_000)
INPUT = Decimal("2")
CACHED = Decimal("0.5")
OUTPUT = Decimal("8")

def call_cost(input_tokens, cached_tokens, output_tokens):
    if not 0 <= cached_tokens <= input_tokens or output_tokens < 0:
        raise ValueError("invalid usage")
    return ((input_tokens - cached_tokens) * INPUT
            + cached_tokens * CACHED + output_tokens * OUTPUT) / MILLION

calls = [(1800, 1200, 100), (600, 0, 200)]
total = sum(call_cost(*call) for call in calls) + Decimal("0.002")
print(f"cost={total:.4f}")

# 规划 500 ms,两个独立工具 200/300 ms,汇总 400 ms
serial = 500 + 200 + 300 + 400
parallel = 500 + max(200, 300) + 400
print(f"serial={serial} ms, parallel={parallel} ms")
结果是 cost=0.0074,串行 1400 ms、并行 1200 ms。两种方式调用次数相同,因此在这组假设下成本相同。真实端到端耗时由入口与结束时间相减,可能还包含排队和退避。存在并发时,把全部 span 耗时相加会重复计算重叠部分。
优先削减无效调用和上下文
第一类收益通常来自减少模型轮次。能用确定性代码完成的参数校验、权限判断、日期计算和格式转换,不要交给模型反复推理。工具返回已经包含最终事实时,也不必再让 Agent“确认一次”。同时给循环设置最大迭代次数,并区分可重试错误与业务错误,避免错误路径无限消耗。
第二类收益来自缩短上下文。历史消息不应永久原样追加,可以保留最近对话,将较早内容压缩成摘要;工具返回只保留后续推理需要的字段;检索结果按相关度取少量片段。上下文压缩后必须检查事实是否仍然足够,否则省下 Token 却增加幻觉,得不偿失。
用模型分层、缓存和并发继续优化
当任务质量允许时,可以把不同步骤分给不同能力的模型:分类、意图识别、格式整理使用轻量模型,复杂规划或最终高风险回答再升级到更强模型。模型分层必须按任务难度路由,而不是全局硬切,否则容易出现成本下降但失败率上升。
应用结果缓存可以复用检索或确定性工具的结果。缓存键应包含权限范围、数据版本和影响结果的输入,并根据时效设定失效策略。模型提示词缓存则复用相同前缀的处理状态,仍会生成新的响应。把稳定部分放前面,用实际返回的缓存用量观察命中情况。
工具之间没有依赖关系时可并行执行。例如同时查询天气和汇率,比串行等待两个工具更快。但一旦第二个工具参数依赖第一个结果,就必须保持顺序。并发优化的是墙钟时间,不会自动减少调用次数,因此仍要单独核算成本。
用三项指标验收优化
每次优化至少同时比较质量、延迟和成本。质量可以用任务成功率、人工评分或固定评测集;延迟重点看 p50、p95 和最慢工具;成本看单请求平均 Token、模型调用次数与外部工具费用。只看平均耗时可能掩盖少数超慢请求,只看 Token 又可能漏掉昂贵的搜索或浏览器调用。
一次可靠的优化结果应类似“任务成功率不下降,p95 从 4.2 秒降到 2.9 秒,单请求模型调用从 4.1 次降到 2.6 次,输入 Token 下降 35%”。如果成本下降但失败重试变多,或响应更快但答案质量明显下降,就不算完成优化。
最终目标不是把 Token 压到最低,而是在给定质量门槛下,用最少的调用轮次、最短的必要上下文和合适的执行并发完成任务。