
AI Agent / 系统课时
多 Agent 架构模式
多 Agent 架构模式
当一个 Agent 同时负责规划、检索、执行和校验时,提示词会迅速膨胀,错误也更难定位。本篇用常见协作模式拆清“谁决定、谁执行、谁汇总”,并给出一个可运行的监督者路由示例,帮助你选择不过度复杂的多 Agent 结构。
学习目标
- 区分监督者、流水线、并行专家和群聊式协作的职责边界
- 根据任务依赖关系选择合适的 Agent 组织方式
- 用最小代码实现监督者分发与结果汇总
先从任务依赖关系选架构
多 Agent 架构的核心不是“Agent 越多越强”,而是把不同职责放到可独立验证的执行单元中。先判断任务是否存在明确的先后依赖、是否能并行、是否需要一个中心角色做决策,再决定组织方式。
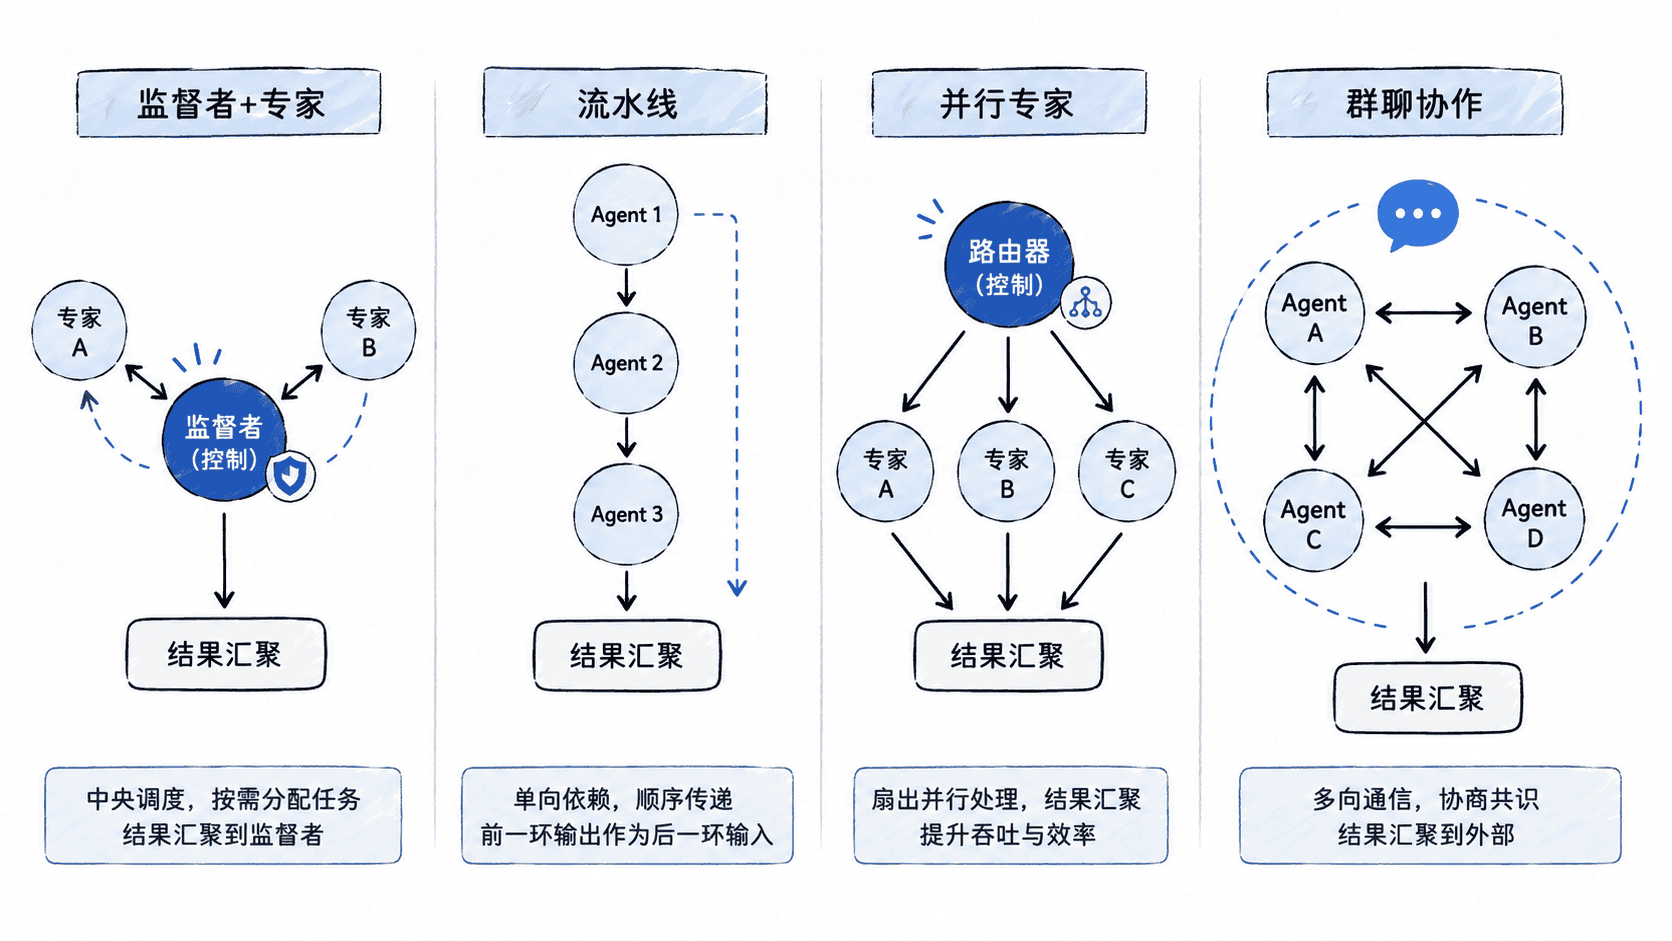
常见模式可以这样理解:
| 模式 | 控制权 | 适合场景 | 主要风险 |
|---|---|---|---|
| 监督者 + 专家 | 监督者集中分配 | 工具多、角色边界清晰 | 监督者成为瓶颈 |
| 流水线 | 固定顺序传递 | 生成→审核→发布等稳定流程 | 前序错误会向后传播 |
| 并行专家 | 多个 Agent 同时工作 | 多来源检索、候选方案比较 | 合并冲突与成本上升 |
| 群聊式协作 | 多方动态发言 | 开放式讨论、协商决策 | 循环对话、难以终止 |
监督者模式如何分工
监督者模式适合第一版多 Agent 系统,因为控制链最清楚。监督者识别任务类型、选择专家并收集结果。专家处理被分配的任务,能调用的工具和可读取的数据由编排层限定。这样可以减少隐式循环,也便于记录每次路由决策。
一个实用的角色边界是:监督者不做专业内容生成,专家不改全局计划,汇总器只整理已经产生的结果。角色越容易用输入和输出描述,越容易测试。
用最小代码实现路由
下面的示例不依赖任何 Agent 框架,用普通 Python 模拟“监督者选择专家并返回结果”。真实项目中可以把 run() 替换为 LLM 调用或工具执行。
from dataclasses import dataclass
from typing import Callable

@dataclass
class Agent:
    name: str
    run: Callable[[str], str]

def search_agent(task: str) -> str:
    return f"检索结果:{task} 的资料已整理"

def code_agent(task: str) -> str:
    return f"代码结果:{task} 的实现草案已生成"

agents = {
    "search": Agent("researcher", search_agent),
    "code": Agent("coder", code_agent),
}

def supervisor(task_type: str, task: str, allowed_types: frozenset[str]) -> str:
    agent = agents.get(task_type)
    if agent is None:
        return "无法分配:没有匹配的专家"
    if task_type not in allowed_types:
        return "无法分配:当前请求未获授权"
    result = agent.run(task)
    return f"由 {agent.name} 处理 -> {result}"

if __name__ == "__main__":
    allowed = frozenset({"search", "code"})
    print(supervisor("search", "比较三种向量数据库", allowed))
    print(supervisor("code", "实现一个重试装饰器", allowed))
    print(supervisor("code", "执行代码", frozenset({"search"})))
    print(supervisor("unknown", "未知任务", allowed))
预期输出:
由 researcher 处理 -> 检索结果:比较三种向量数据库 的资料已整理
由 coder 处理 -> 代码结果:实现一个重试装饰器 的实现草案已生成
无法分配:当前请求未获授权
无法分配:没有匹配的专家
这里由上游传入结构化任务类型。接入模型后,把模型给出的类型当作路由建议,由服务端根据已验证的用户身份和请求上下文生成 allowed_types。路由通过后,专家的具体工具仍需各自校验权限。路由日志可记录任务 ID、所选专家、耗时和状态。
什么时候换成其他模式
如果每一步都依赖上一步的结果,固定流水线更容易验证。涉及发布时,审核结果须由编排层独立检查,再允许进入发布阶段。多个专家能独立处理同一问题时,可并行执行,再按事先约定的验收规则汇总。群聊式协作需要额外规定谁能发言、最大轮次和终止条件。
架构选择的判断标准应是:控制链是否清楚、每个角色能否独立验证、失败能否局部重试。只要单 Agent 加工具调用已经足够,就没有必要为了“多 Agent”而额外增加通信层和调度复杂度。