
AI Agent / 系统课时
文档处理与向量索引构建
文档处理与向量索引构建
RAG 能否稳定检索,首先取决于进入索引的数据质量。本节从原始文档出发,完成切分、向量化、元数据绑定和最小向量索引构建,并用一次查询验证召回结果,形成可迁移到真实向量数据库的基础流程。
学习目标
- 理解文档切分、向量化、索引写入之间的职责边界
- 为每个片段保留可追踪的文档与位置元数据
- 构建并验证一个可运行的最小向量检索索引
从文档到可检索片段
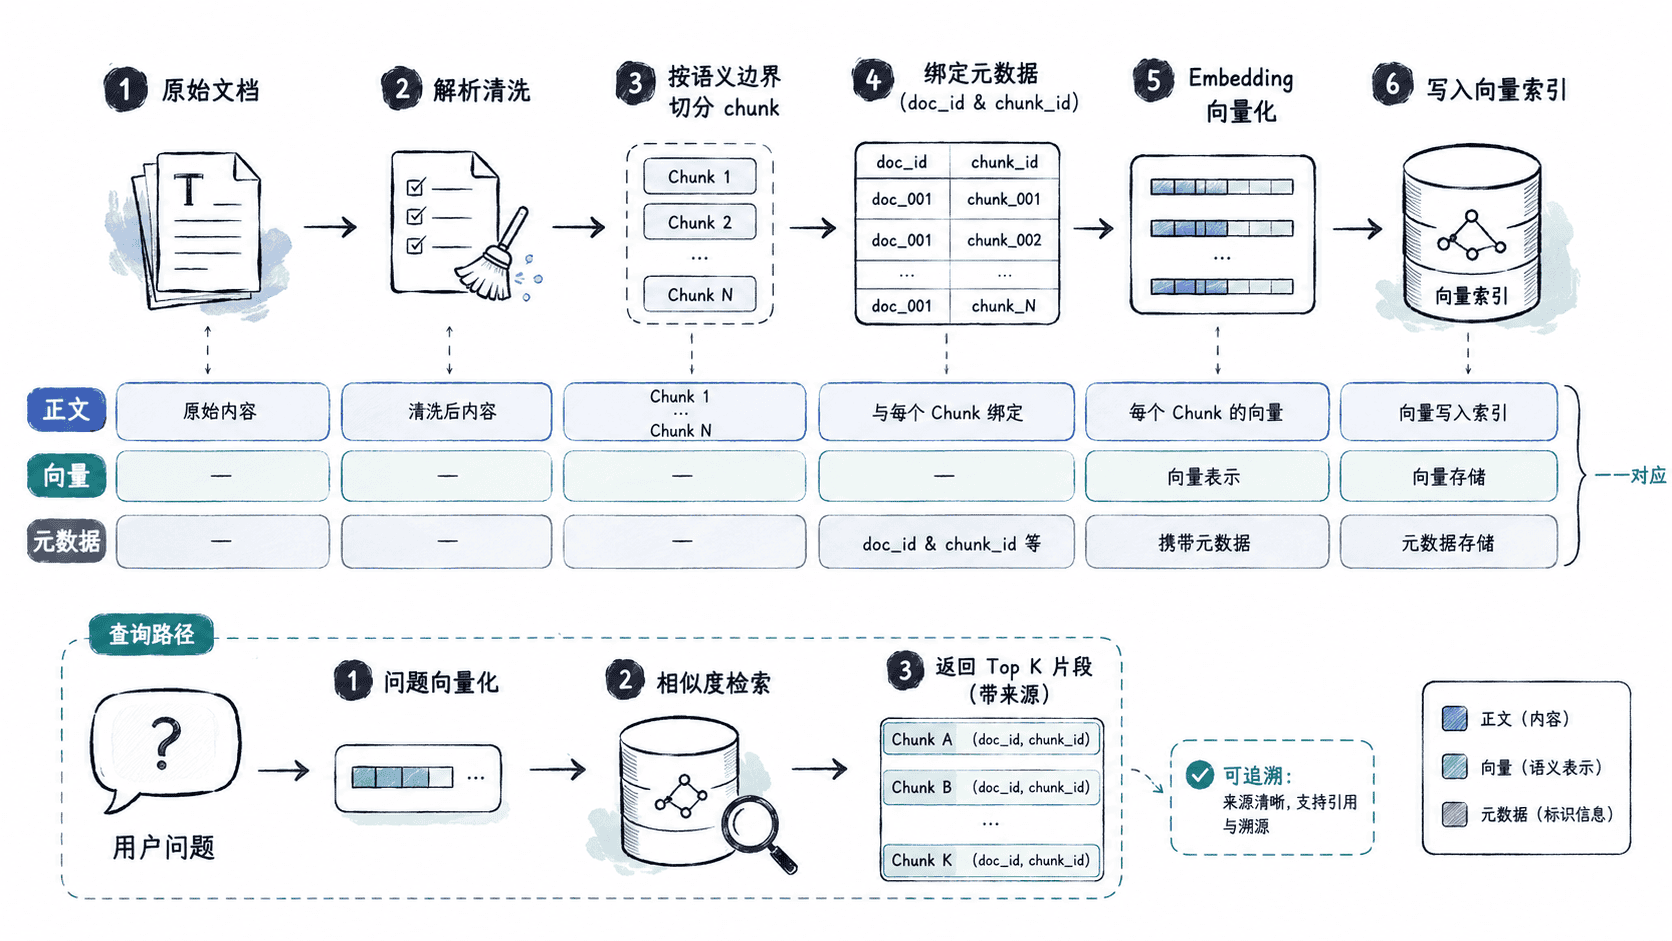
索引的最小单位通常不是整篇文档,而是 chunk。整篇文档过长时,一个向量会混合多个主题;切得过碎又会失去上下文。工程上应优先按标题、段落、句子等自然边界切分,再用长度上限约束片段大小,必要时加入少量重叠以保留跨边界语义。
片段记录应保留 tenant_id、doc_id、源版本、chunk_id 和原文偏移,并按需要加上来源 URI 与访问规则。权限范围由服务端根据已验证身份确定。检索命中后,这些字段既用于回溯来源,也能参与过滤和权限控制。
构建最小可运行索引
下面用 Python 标准库实现一个教学版 flat index。示例用哈希词项向量模拟 Embedding,因此可以零依赖运行;生产环境应把 embed 替换为稳定的语义向量模型,并把内存列表替换为支持持久化和近似最近邻检索的向量数据库或索引库。
import hashlib
import math
import re

def tokenize(text: str) -> list[str]:
    # 同时保留英文单词和单个中文字符,便于示例在零依赖环境运行。
    return re.findall(r"[a-z0-9]+|[\u4e00-\u9fff]", text.lower())

def embed(text: str, dim: int = 64) -> list[float]:
    if dim <= 0:
        raise ValueError("dim must be positive")
    vec = [0.0] * dim
    for token in tokenize(text):
        digest = hashlib.sha256(token.encode("utf-8")).digest()
        bucket = int.from_bytes(digest[:4], "big") % dim
        vec[bucket] += 1.0
    norm = math.sqrt(sum(x * x for x in vec)) or 1.0
    return [x / norm for x in vec]

def chunk_text(text: str, size: int = 42, overlap: int = 8):
    if not 0 <= overlap < size:
        raise ValueError("require 0 <= overlap < size")
    chunks = []
    start = 0
    while start < len(text):
        end = min(start + size, len(text))
        chunks.append((start, end, text[start:end]))
        if end == len(text):
            break
        start = end - overlap
    return chunks

def cosine(a: list[float], b: list[float]) -> float:
    if not a or len(a) != len(b):
        raise ValueError("vectors must have the same positive dimension")
    return sum(x * y for x, y in zip(a, b))

documents = {
    "agent-guide": "Agent 在执行任务前,可以先检索知识库。文档需要先切分为较小片段,再生成向量并写入索引。检索时把用户问题向量化,召回相似片段,最后把片段交给模型生成答案。",
    "tool-guide": "工具调用适合访问实时系统。Agent 应验证工具参数和返回值,并把失败信息纳入下一步决策。"
}

records = [
    ("team-a", doc_id, "v2", text) for doc_id, text in documents.items()
]
records.extend([
    ("team-b", "agent-guide", "v2", documents["agent-guide"]),
    ("team-a", "agent-guide", "v1", documents["agent-guide"]),
    ("team-a", "restricted", "v2", documents["agent-guide"]),
])

index = []
for tenant, doc_id, version, text in records:
    for chunk_id, (start, end, chunk) in enumerate(chunk_text(text)):
        index.append({
            "tenant": tenant, "doc_id": doc_id, "version": version,
            "chunk_id": chunk_id, "start": start, "end": end,
            "text": chunk, "vector": embed(chunk),
        })


def search(query, tenant, allowed_versions):
    qv = embed(query)
    if not any(qv):
        return []
    candidates = [
        item for item in index if item["tenant"] == tenant
        and allowed_versions.get(item["doc_id"]) == item["version"]
        and any(item["vector"])
    ]
    return sorted(candidates, key=lambda item: cosine(qv, item["vector"]), reverse=True)[:3]


query = "Agent 如何先检索知识库并把相似文档交给模型回答"
allowed = {"agent-guide": "v2", "tool-guide": "v2"}  # 模拟服务端鉴权及索引路由
hits = search(query, "team-a", allowed)
assert len(hits) == 3
assert all(hit["tenant"] == "team-a" and hit["version"] == "v2"
           and hit["doc_id"] in allowed for hit in hits)
assert search("?!", "team-a", allowed) == []
qv = embed(query)
for hit in hits:
    score = cosine(qv, hit["vector"])
    print(f'{hit["doc_id"]}#{hit["chunk_id"]} score={score:.3f} {hit["text"]}')
预期输出:
agent-guide#1 score=0.478 ,再生成向量并写入索引。检索时把用户问题向量化,召回相似片段,最后把片段交给模型生成
agent-guide#0 score=0.405 Agent 在执行任务前,可以先检索知识库。文档需要先切分为较小片段,再生成向量并写
agent-guide#2 score=0.396 片段交给模型生成答案。
这个结果说明查询向量与 agent-guide 的三个片段更接近。教学版哈希向量只用于演示数据流,不能代表真实语义质量;真实系统应通过离线检索集验证 Embedding 模型、chunk 大小与召回数量,而不是仅凭单次查询判断效果。
写入索引时保留可恢复信息
向量本身无法解释来源,因此索引记录至少要同时保存 chunk 文本和稳定标识。重新切分或更换 Embedding 模型时,可写入新的索引版本,核对文档覆盖、向量维度和访问规则后再切换读流量。更新或删除要使旧版本及时停止召回。示例的局部片段序号只能与租户、文档及源版本合用,才能唯一回溯来源。
验证索引是否真的可用
构建完成后至少检查三件事:目标文档是否都产生了 chunk、每个 chunk 是否有向量和元数据、代表性问题能否召回正确来源。若召回内容主题正确但上下文残缺,优先调整自然边界和重叠;若完全召回不到语义相关内容,再检查 Embedding 模型、向量维度、距离度量和查询预处理。
索引构建的核心不是“把文本变成向量”这一行代码,而是让 原文、片段、向量、元数据和版本 始终保持可追踪的一致关系。做到这一点,后续的检索融合、重排序和生成优化才有可靠输入。