
AI Agent / 系统课时
检索结果融合与生成优化
检索结果融合与生成优化
单一路径检索很容易偏科:向量检索擅长语义近似,关键词检索更容易命中编号、专有名词和精确短语。本节把多路召回、排序融合、二阶段重排和上下文拼接串成一条可验证链路,让最终交给模型的证据更相关、更少重复。
学习目标
- 使用稳定的融合方法合并不同检索器的候选结果
- 理解重排序与初始召回各自解决的问题
- 按预算、去重和来源约束组织最终生成上下文
先扩大召回,再统一排序
混合检索常见做法是同时运行向量检索与关键词检索。两路分数通常不在同一尺度上,直接相加会让某一路因为数值范围更大而占优。若没有可靠的分数校准,可以先按各自名次使用 Reciprocal Rank Fusion,也就是 RRF:
其中 是文档 在第 路中从 1 开始的名次, 为非负的平滑常数。某一路未返回该文档,就没有该路贡献;同一 ID 在同一路只贡献一次。RRF 只依赖名次,因此适合把 BM25、向量相似度等异构检索结果合并成一个候选集。
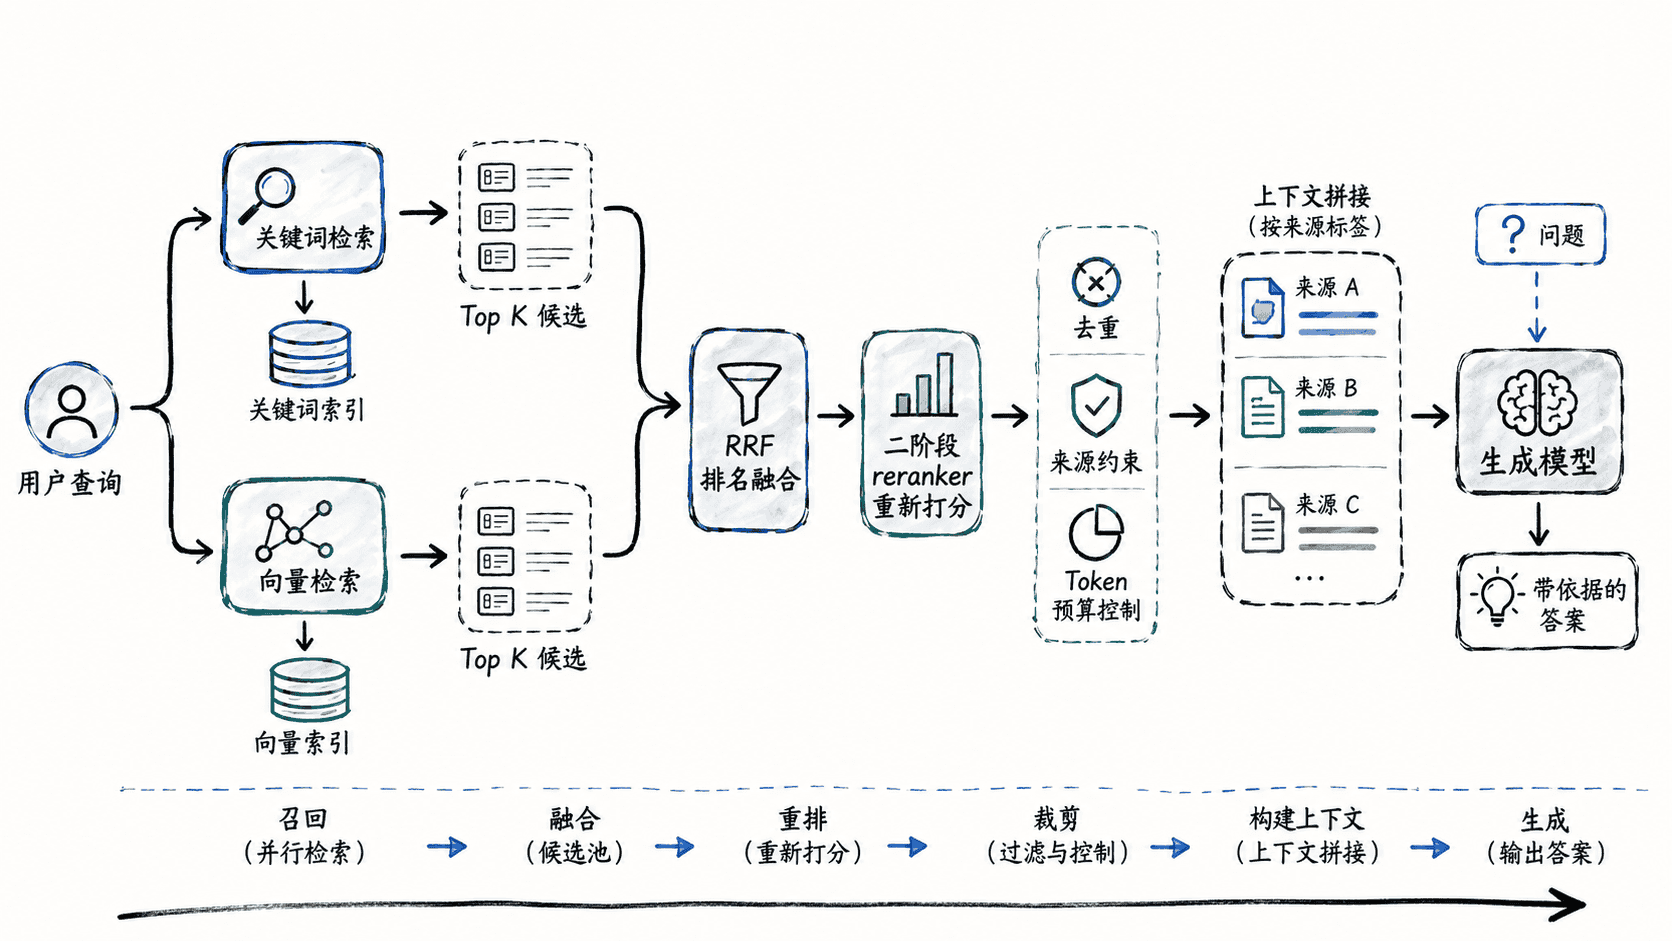
用 RRF 和重排生成候选顺序
下面的最小示例提供两份已有排名,先用 RRF 融合,再用一个可运行的词项重合函数模拟二阶段 reranker。真实项目可以把 rerank 替换为 cross-encoder 或 LLM reranker,但仍应保留同样的“先召回、后精排”边界。
from collections import defaultdict
import re

documents = {
    "d1": "RAG 应先从知识库召回候选片段,再把高相关内容交给模型生成答案。",
    "d2": "向量检索擅长语义相似,关键词检索擅长命中产品名、编号和精确术语。",
    "d3": "上下文拼接要控制长度、去重,并保留来源标识,避免低价值片段挤占窗口。",
    "d4": "重排序器会对查询和候选片段重新打分,再选择最适合进入上下文的内容。"
}

dense_rank = ["d4", "d1", "d1", "d3", "d2"]
keyword_rank = ["d2", "d3", "d1", "d4"]

def rrf(rankings: list[list[str]], k: int = 60) -> dict[str, float]:
    if k < 0:
        raise ValueError("k must be nonnegative")
    scores = defaultdict(float)
    for ranking in rankings:
        for rank, doc_id in enumerate(dict.fromkeys(ranking), start=1):
            scores[doc_id] += 1.0 / (k + rank)
    return scores

def tokens(text: str) -> set[str]:
    return set(re.findall(r"[a-z0-9]+|[\u4e00-\u9fff]", text.lower()))

def overlap(query, doc_id):
    q = tokens(query)
    return len(q & tokens(documents[doc_id])) / max(len(q), 1)


query = "怎样融合关键词和向量检索,并控制最终上下文"
# 生产检索应在每一路候选生成前鉴权;这里额外保护融合输入。
allowed = {"d1", "d2", "d3", "d4"}
rankings = [[doc_id for doc_id in ranking if doc_id in allowed]
            for ranking in (dense_rank + ["restricted"], keyword_rank)]
fused = rrf(rankings)
assert fused == rrf([["d4", "d1", "d3", "d2"], keyword_rank])
fused_order = sorted(fused, key=lambda doc_id: (-fused[doc_id], doc_id))
ordered = sorted(fused, key=lambda doc_id: (-overlap(query, doc_id), -fused[doc_id], doc_id))

budget = 90
parts = []
for doc_id in ordered:
    text = f"[{doc_id}] {documents[doc_id]}"
    candidate = "\n".join([*parts, text])
    if len(candidate) <= budget:
        parts.append(text)

context = "\n".join(parts)
assert len(context) <= budget
assert "[restricted]" not in context
print("融合顺序:", " > ".join(fused_order))
print("重排顺序:", " > ".join(ordered))
print("上下文:")
print(context)
print("字符数:", len(context))
预期输出:
融合顺序: d2 > d4 > d1 > d3
重排顺序: d2 > d4 > d3 > d1
上下文:
[d2] 向量检索擅长语义相似,关键词检索擅长命中产品名、编号和精确术语。
[d4] 重排序器会对查询和候选片段重新打分,再选择最适合进入上下文的内容。
字符数: 76示例先按词项重合重排,融合分数仅用于同分时比较。budget 以字符简化演示,统计真正拼接后的来源标记与换行。接入真实模型时应改用目标模型对应的 tokenizer 计算 token,并为系统提示、用户问题和模型输出预留空间,不能把整个上下文窗口都分配给检索片段。
拼接上下文不是简单取 Top K
最终上下文要同时满足相关性、覆盖度和预算。相邻 chunk 高度重叠时,应优先合并或去重;同一来源连续命中多个片段时,可限制单来源占比,避免一个文档挤掉其他证据。对需要引用或审计的 Agent,还应给每个片段保留稳定来源标识,让模型能够把结论和证据对应起来。
用生成结果反推检索问题
生成质量下降时不要只调 Prompt。若答案遗漏事实,先检查相关片段是否进入候选池;候选池里有但未进入上下文,再检查融合、重排和预算;正确证据已经进入上下文但模型仍回答错误,才重点检查提示词、指令冲突和模型能力。
工程验收应把“召回是否正确”和“回答是否正确”分开评估。检索层可以记录 Recall@K、MRR 或人工相关性标签,生成层再检查事实一致性、引用覆盖与无依据回答。这样才能判断问题究竟出在召回、排序、上下文组织还是最终生成。