
AI Agent / 系统课时
常见故障排查与调试技巧
常见故障排查与调试技巧
Agent 故障通常表现为“工具没调用”“工具调用失败”“回答与工具结果矛盾”或“循环不结束”。高效排查的关键不是反复改提示词,而是沿调用链收集证据:先确认模型决策,再检查参数、工具结果、状态更新与最终回答。
学习目标
- 能按固定顺序定位工具调用失败、循环和幻觉输出
- 能用结构化 trace 区分模型决策错误、工具错误与状态同步错误
- 能通过最小复现和回归用例确认修复没有引入新问题
先按调用链定位故障层
排查时先把一次失败请求拆成五段:输入与上下文、模型决策、工具参数、工具执行、最终回答。只看最终文本会丢失大量信息。例如“查不到订单”可能是模型根本没选查询工具,也可能是订单号格式错误、工具超时、权限不足,或工具成功后结果没有写回 Agent 状态。
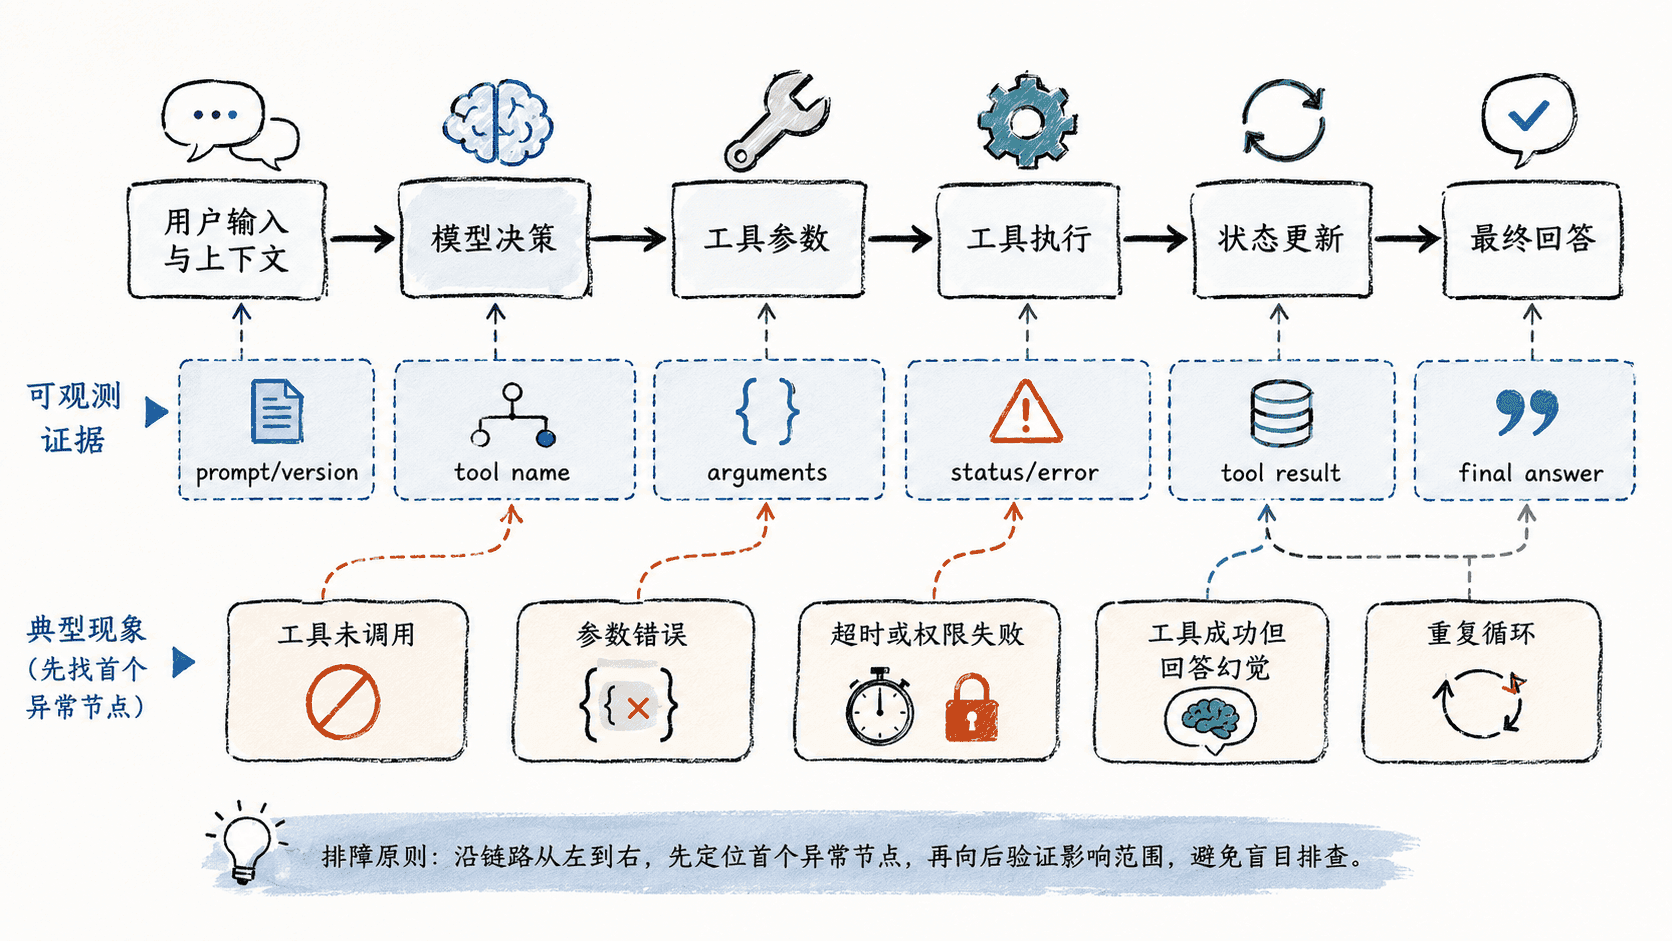
调试日志至少要能关联同一次运行中的所有步骤,并记录工具名、参数摘要、状态码、耗时、错误类型和模型轮次。敏感字段如访问令牌、身份证号和完整用户输入应在写日志前脱敏。
下面的脚本模拟三类常见故障,并把第一个观察到的异常标为排查起点。样例覆盖同一条顺序调用链。并发调用需要按父子 span 和时间线核对,不能按日志到达顺序推断因果。
from dataclasses import dataclass

@dataclass
class Step:
    name: str
    status: str
    detail: str

def diagnose(steps: list[Step]) -> str:
    for step in steps:
        if step.status != "ok":
            return f"first_observed_failure={step.name} detail={step.detail}"
    return "no_recorded_failure" if steps else "no_trace_evidence"

def main() -> None:
    cases = {
        "bad_args": [
            Step("model_decision", "ok", "tool=lookup_order"),
            Step("tool_arguments", "error", "order_id is empty"),
        ],
        "tool_timeout": [
            Step("model_decision", "ok", "tool=lookup_order"),
            Step("tool_arguments", "ok", "order_id=123"),
            Step("tool_execution", "error", "timeout"),
        ],
        "hallucination": [
            Step("model_decision", "ok", "tool=lookup_order"),
            Step("tool_arguments", "ok", "order_id=123"),
            Step("tool_execution", "ok", "status=refunded"),
            Step("final_answer", "error", "answer says pending"),
        ],
    }

    for name, steps in cases.items():
        print(name, diagnose(steps))

if __name__ == "__main__":
    main()
预期输出
bad_args first_observed_failure=tool_arguments detail=order_id is empty
tool_timeout first_observed_failure=tool_execution detail=timeout
hallucination first_observed_failure=final_answer detail=answer says pending
真实系统中不应只记录字符串错误,而应保留可筛选的错误码,例如 INVALID_ARGUMENT、TIMEOUT、PERMISSION_DENIED 和 RATE_LIMITED。这样才能判断是提示词、参数校验、后端服务还是配额策略出了问题。
工具调用失败要区分四种原因
工具失败首先检查“有没有调用”,再检查“调用了什么”。模型没有选择正确工具,多半属于工具描述不清、工具数量过多或路由规则不足;工具已选择但参数缺失,则应优先增加 schema 约束和参数校验,而不是在提示词里堆更多自然语言要求。
如果参数正确但执行失败,要根据错误类型处理。超时可以设置明确 deadline,并只对幂等操作做有限重试;权限错误应检查调用身份和授权范围;限流错误应采用退避与并发限制;业务错误如“订单不存在”通常不应自动重试。把所有异常都统一重试,会把小故障放大成高成本循环。
幻觉输出要核对事实来源
当工具返回成功但最终回答错误时,重点检查两件事:工具结果有没有完整写回上下文,以及最终提示是否明确要求以工具结果为事实来源。常见问题包括工具结果被截断、字段名映射错误、旧状态覆盖新状态,或模型在已有事实之外自行补充结论。
对于订单状态、账户余额、库存和审批结果这类可验证事实,应在最终回答前做结构化校验。让模型先返回结构化的 order_id、status 和 tool_call_id。应用核对三项是否与同一工具回执一致,再用确认过的状态渲染说明。直接匹配“待处理”可能把“先前待处理,现已退款”误判为冲突。高风险场景还应保留引用到具体工具结果的 trace 证据。
循环与间歇性错误怎么抓
Agent 不停重复同一个工具,通常是“停止条件没有被状态表示”。检查每轮模型输入中是否包含上一轮工具结果、完成标记是否被更新,以及规划器是否知道什么条件代表任务已经结束。应设置最大轮次、重复工具调用检测和总耗时预算,触发后返回可诊断错误,而不是静默继续。
间歇性错误最适合用请求 ID 和最小复现处理。保存失败请求的模型版本、提示词版本、工具 schema、输入摘要、随机参数和关键工具响应;在授权范围内,用脱敏测试夹具逐步缩小输入。先回放已经捕获的工具响应,再注入延迟和失败来观察编排是否有竞态。若故障随模型输出变化,同一输入可多次运行并记录失败比例。
修复后必须做回归验证
修复不能只验证“刚才那条请求好了”。至少把故障输入加入固定回归集,并同时覆盖一个正常样例和一个边界样例。对于工具问题,要确认成功率和错误码分布恢复;对于幻觉问题,要比较工具事实与最终回答的一致率;对于循环问题,要观察最大轮次和端到端耗时是否受控。
一套可执行的排障习惯是:从首个可见异常追溯其输入、依赖和状态,再修复经复现确认的原因,再用 trace 和回归用例证明问题消失。只有在证据指向模型决策本身时,才进入提示词、工具描述或模型选择的调整。