
计算机网络 / 系统课时
服务重启后客户端为何雪崩重连
服务重启后客户端为何雪崩重连
一次正常发布也可能把 WebSocket 服务推入第二次故障:成千上万客户端同时断线,又按照相同的固定间隔一起重连,瞬间把握手、鉴权和订阅恢复流量集中到几秒内。本篇用退避、随机抖动和稳定期重置把重连峰值摊开,并说明怎样验证策略真的生效。
学习目标
- 解释服务重启后固定间隔重连为何会形成同步峰值。
- 实现带指数退避、随机抖动和稳定期重置的客户端重连策略。
- 用重连速率、握手失败率和服务端资源曲线验证恢复过程。
雪崩不是断线本身,而是客户端重新同步
服务重启会同时关闭一批长连接。如果所有客户端都在断线后固定等待 1 秒再连接,那么第一次重连会集中发生;服务若来不及处理,一部分客户端再次失败,又会在下一个固定间隔同时重试,形成周期性的尖峰。
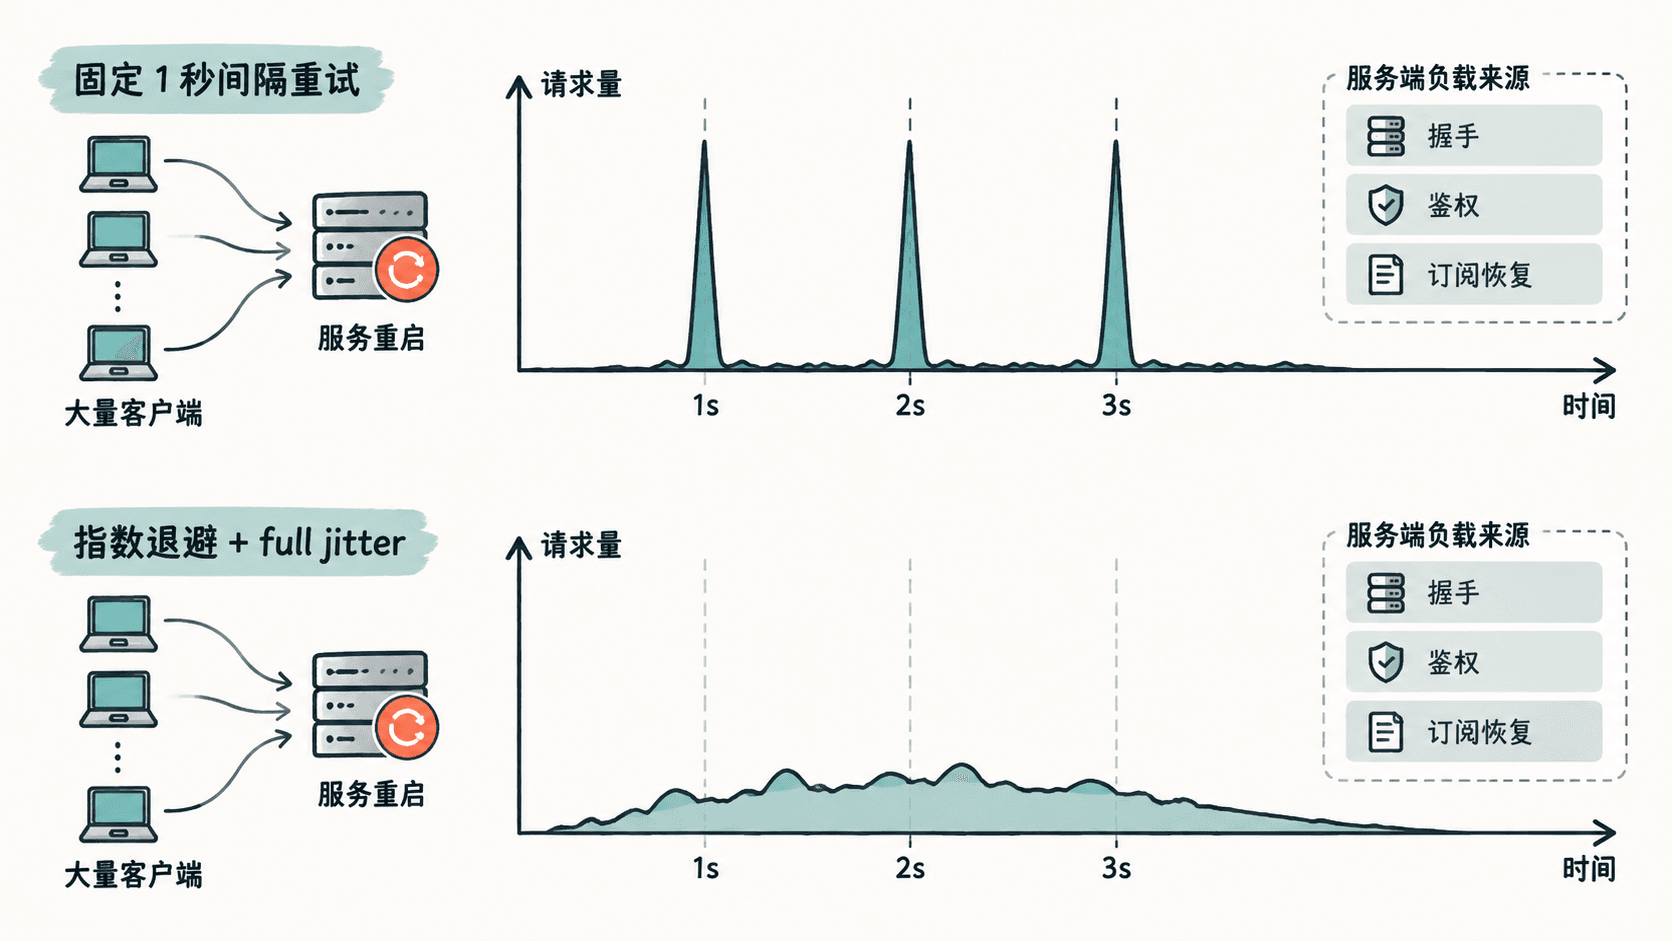
重连的压力不只来自 TCP 或 WebSocket 握手。很多系统在连接建立后还会立即做登录校验、恢复订阅、同步离线状态和补拉数据,因此一个“连接成功”可能触发多次下游调用。恢复策略必须同时保护网关、鉴权服务、消息系统和业务后端。
用指数退避加随机抖动打散客户端
常用做法是让第 n 次失败的最大等待时间按指数增长,再从 0 到这个上限之间随机取值,并设置封顶值。这样不同客户端不会因为相同的失败时刻和相同的等待时长再次同步。
下面是浏览器端的完整重连器。假设 WebSocket 路径为当前站点的 /ws;如果你的路径不同,只改 WS_PATH。连接成功后不会立刻把失败次数清零,而是连续稳定一段时间后再重置,避免服务抖动时不断回到最激进的低延迟重试。
const WS_PATH = "/ws";
const BASE_DELAY_MS = 500;
const MAX_DELAY_MS = 30000;
const STABLE_MS = 10000;

class ReconnectingSocket {
  constructor(path) {
    this.path = path;
    this.attempt = 0;
    this.timer = null;
    this.stableTimer = null;
    this.stopped = false;
    this.ws = null;
  }

  start() {
    this.stopped = false;
    this.connect();
  }

  connect() {
    const scheme = location.protocol === "https:" ? "wss" : "ws";
    const url = `${scheme}://${location.host}${this.path}`;

    this.ws = new WebSocket(url);

    this.ws.onopen = () => {
      console.log("[open] connected");
      clearTimeout(this.stableTimer);
      this.stableTimer = setTimeout(() => {
        this.attempt = 0;
        console.log("[stable] retry counter reset");
      }, STABLE_MS);
    };

    this.ws.onclose = () => {
      clearTimeout(this.stableTimer);
      if (!this.stopped) this.scheduleReconnect();
    };
  }

  scheduleReconnect() {
    const exponent = Math.min(this.attempt, 10);
    const ceiling = Math.min(
      MAX_DELAY_MS,
      BASE_DELAY_MS * 2 ** exponent
    );
    const delay = Math.floor(Math.random() * ceiling);

    console.log(
      `[reconnect] attempt=${this.attempt} delay=${delay}ms`
    );

    this.attempt += 1;
    clearTimeout(this.timer);
    this.timer = setTimeout(() => this.connect(), delay);
  }

  stop() {
    this.stopped = true;
    clearTimeout(this.timer);
    clearTimeout(this.stableTimer);
    this.ws?.close(1000, "client stop");
  }
}

const socket = new ReconnectingSocket(WS_PATH);
socket.start();
预期输出
[open] connected
[reconnect] attempt=0 delay=<TIME>ms
[reconnect] attempt=1 delay=<TIME>ms
[open] connected
[stable] retry counter reset
<TIME> 每次都会不同,这是随机抖动的预期行为。真正线上实现还应根据业务决定是否在网络离线、用户退出或鉴权永久失败时停止自动重连,避免对不可恢复错误无限重试。
恢复订阅也要做节流
即使连接已经被打散,所有客户端在 open 后立刻恢复几十个订阅,也可能把峰值从“握手阶段”搬到“订阅恢复阶段”。更稳妥的做法是让客户端分批恢复订阅,或者由服务端对恢复请求做速率限制,并优先恢复最重要的频道。
如果系统支持会话恢复或断点续传,还要限制补拉窗口。服务重启后让所有客户端同时请求很长时间范围的历史消息,会把数据库或消息存储变成新的瓶颈。恢复链路要按“连接、鉴权、订阅、补拉”分别观察,而不是只统计 WebSocket 建连成功率。
怎样复现并验收重连策略
在预发布环境选择一批可控客户端,建立稳定连接后重启一个 WebSocket 实例,记录每秒重连尝试数、握手失败数、鉴权请求量、订阅恢复量,以及服务端 CPU、事件循环延迟和连接建立耗时。测试规模不必等于生产,但客户端数量必须足够看出固定重试与随机退避的峰值差异。
验收时不要只看“最终都连回来了”。更重要的是重连请求是否被摊到多个时间窗口、峰值是否低于服务端可持续处理能力、失败后的下一轮重试是否继续被打散,以及恢复期间正常在线用户的消息延迟是否仍在目标范围内。只要重试仍呈现整齐的周期性尖峰,就说明客户端之间仍存在同步因素,需要继续检查固定定时器、统一启动时间或过早重置重试次数。