
计算机网络 / 系统课时
消息堆积怎样定位瓶颈
消息堆积怎样定位瓶颈
WebSocket 延迟持续升高时,先不要把问题归咎于“网络慢”。真正要做的是把消息从生产、应用队列、单连接发送缓冲到客户端接收这条链路拆开观察,找出哪一段的输入速率长期高于输出速率,再决定是限流、扩容还是淘汰慢客户端。
学习目标
- 用生产速率、消费速率和队列长度判断是否发生持续性堆积。
- 区分应用层待发送队列、TCP 发送队列与客户端处理变慢三类瓶颈。
- 按证据定位慢客户端,并用背压和有界队列避免拖垮整个实例。
先判断堆积发生在哪一层
消息堆积本质上是“进入某一层的速率长期大于离开该层的速率”。如果生产速率只是短时突增,而队列随后能回落,这是可吸收的突发;如果队列长度持续上升,同时端到端延迟不断变大,就说明系统已经进入不可持续状态。
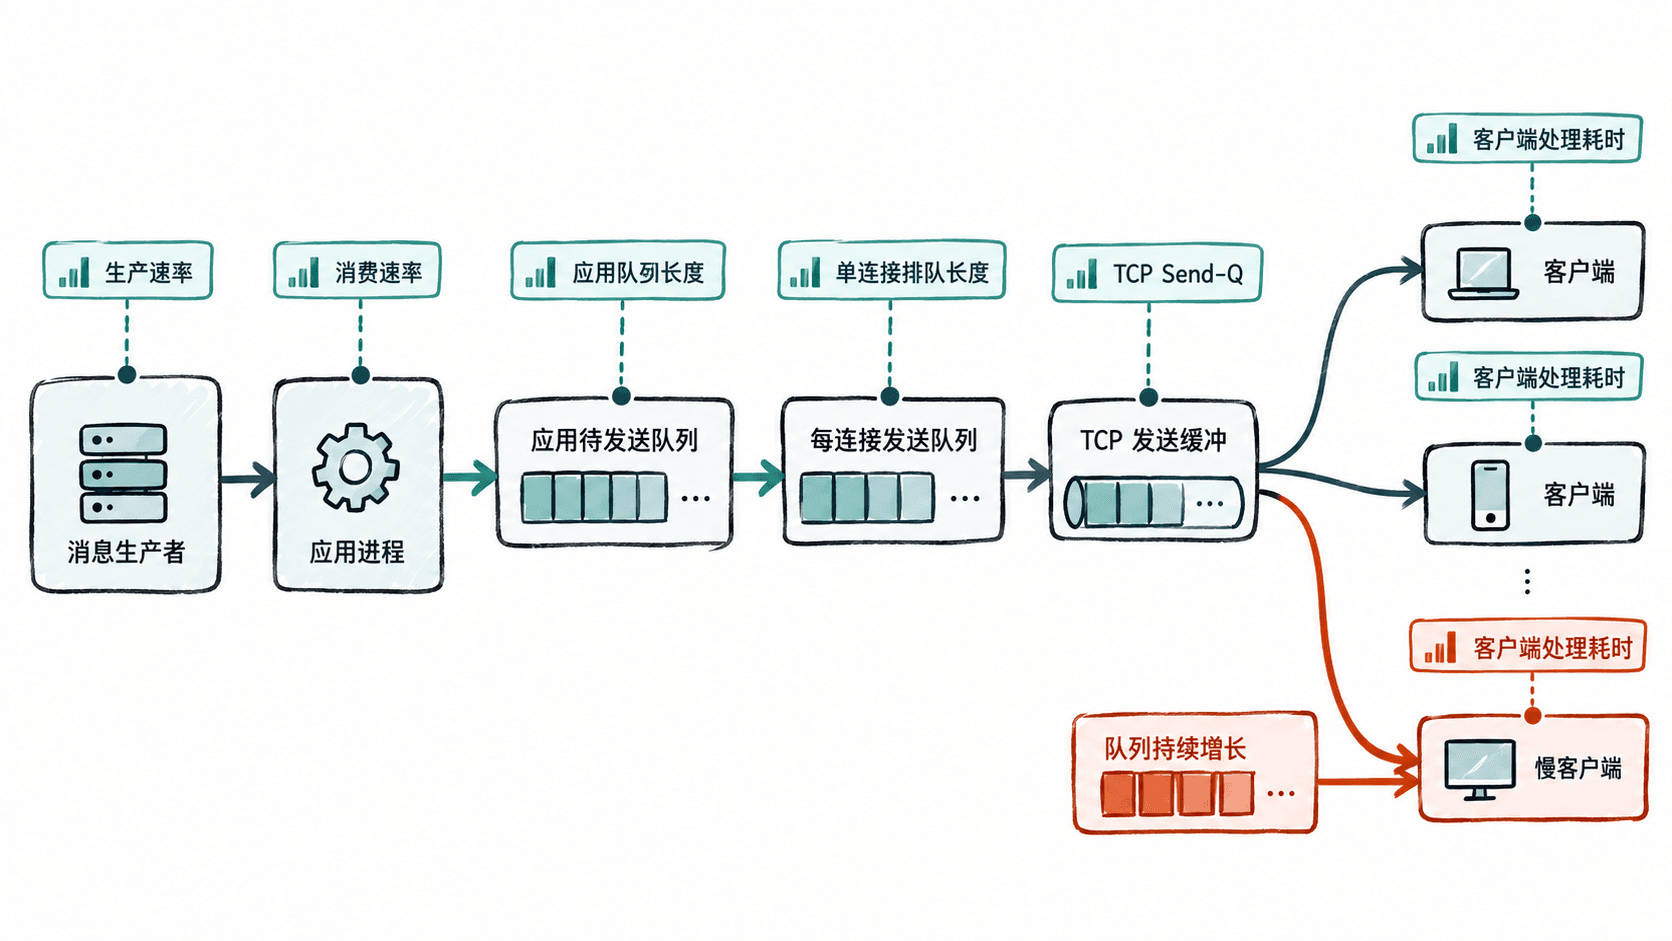
排查时至少同时看三组趋势:单位时间进入系统的消息数、成功发送完成的消息数,以及待发送消息或字节数。仅看“当前连接数”很容易误判,因为同样是一万连接,全部空闲和大量连接持续写满缓冲的压力完全不同。
用速率和队列走势先做第一轮分流
可以把判断压缩成四种常见形态:
| 观测现象 | 更可能的瓶颈位置 | 下一步 |
|---|---|---|
| 生产速率持续高于发送完成速率,所有连接都变慢 | 服务端整体处理能力不足 | 看 CPU、事件循环、序列化、下游依赖与实例容量 |
应用总队列上升,但 TCP Send-Q 普遍不高 |
应用内部消费或调度太慢 | 查线程池、事件循环阻塞、锁和队列消费者 |
只有少数连接的排队量和 Send-Q 很高 |
慢客户端或链路质量差 | 按连接定位并执行超时、降级或断开策略 |
| 队列稳定但业务延迟升高 | 问题可能不在发送队列 | 继续检查上游生产时间、消息处理和客户端渲染 |
应用指标名称取决于你的实现,但至少应能回答“每秒入队多少、每秒发送完成多少、当前排队多少、发送耗时分位数是多少、哪些连接长期处于高水位”。如果只能看到总吞吐,无法区分单个慢连接,就很难判断是否出现 head-of-line 式的资源占用。
检查 TCP 发送队列而不是只看应用日志
在 Linux 上,可用 ss 观察已建立连接的 Send-Q。先把 PORT 设置为 WebSocket 服务实际监听端口,再执行:
: "${PORT:?请先设置 PORT}"
ss -tn state established "( sport = :$PORT )"
预期输出
State Recv-Q Send-Q Local Address:Port Peer Address:Port
ESTAB 0      0      10.0.0.10:<PORT> 10.0.1.21:<PORT>
ESTAB 0      262144 10.0.0.10:<PORT> 10.0.1.37:<PORT>
实际地址、端口和队列数会不同。这里最值得关注的不是某一瞬间出现非零 Send-Q,而是同一连接的发送队列是否连续多个采样周期维持高位或继续增长。若只有少数连接如此,而其他连接正常,慢客户端的可能性很高;若大量连接同时升高,则要继续检查实例出口、CPU、事件循环或下游依赖。
慢客户端为什么会拖垮实时服务
慢客户端并不一定断线。它可能仍保持 TCP 连接,只是接收窗口缩小、网络抖动严重,或者应用线程处理消息太慢。若服务端为每个连接无限缓存待发送消息,这类连接会持续占用内存,并把垃圾回收、事件循环和调度压力扩散到正常客户端。
更稳妥的策略是为单连接设置有界待发送队列,并明确高水位后的行为:允许丢弃可替代的旧状态、合并中间状态、降低推送频率,或者在超过发送超时后主动断开。选择哪一种取决于消息语义;聊天消息通常不能静默丢失,而行情快照、在线状态这类“新值覆盖旧值”的数据更适合合并。
修复后用斜率而不是单点值验收
修复后至少观察一个完整的业务高峰窗口。健康状态不是“队列变成 0”,而是生产速率升高时队列可以短时上涨,随后发送速率追平并使队列回落;单连接高水位不会无限增长;端到端消息延迟的高分位也能恢复到目标范围。
如果扩容后总队列仍按相同斜率增长,说明瓶颈并不在实例数量;如果限制慢客户端后总延迟明显下降,而少量异常连接被隔离,则定位方向基本正确。排查的关键是把每一层的“进入、排队、离开”对应起来,而不是根据一条错误日志猜根因。