
FPGA 与数字 IC 设计 / 系统课时
实现基础 SPI 主机
实现基础 SPI 主机
本节完成一个可综合、可仿真的 8 位 SPI 主机:由系统时钟分频生成 SCLK,事务期间控制片选与 MOSI,并在正确边沿采样 MISO。重点是把 CPOL、CPHA 转换成明确的领先边沿、滞后边沿和数据稳定规则,再用统一逻辑覆盖四种模式。
学习目标
- 根据 CPOL、CPHA 判断 SCLK 空闲电平、数据更新边沿与采样边沿
- 用半周期计数器和事务状态统一控制 SCLK、CS_N、MOSI 与 MISO
- 通过 Mode 0 回环仿真验证一笔 8 位传输的发送、采样和结束时序
把四种 SPI 模式化成边沿规则
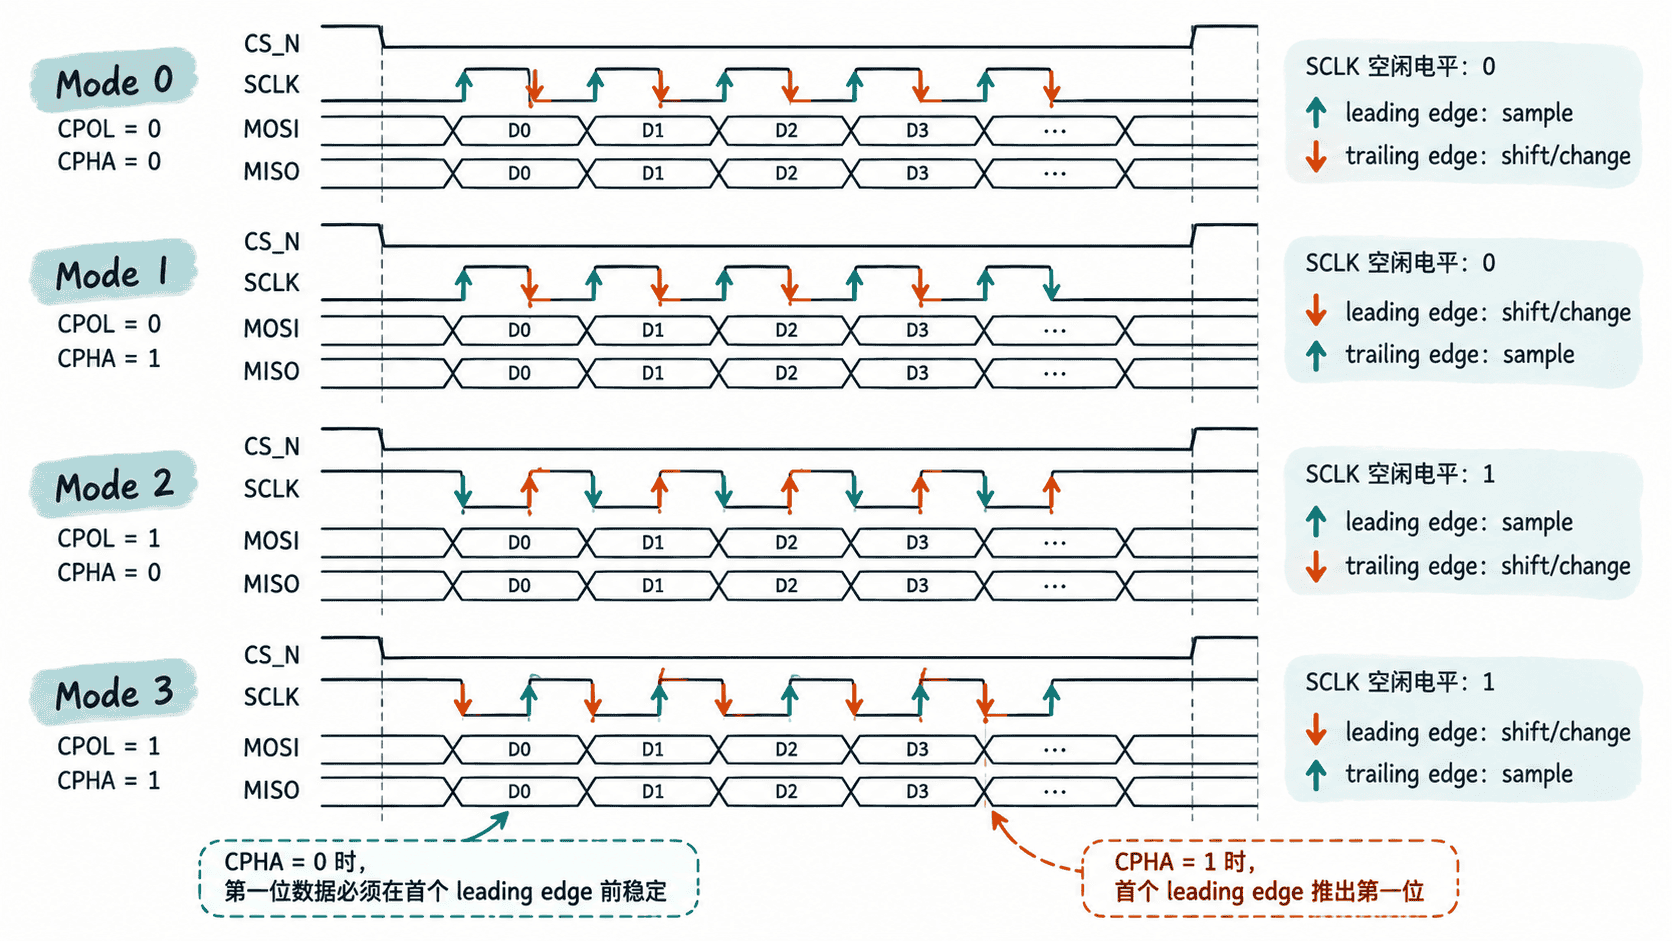
SPI 主机至少控制 SCLK、CS_N 和 MOSI,并从 MISO 采样返回数据。CPOL 决定 SCLK 的空闲电平:0 时空闲为低,1 时空闲为高。每个比特周期都有“领先边沿”和“滞后边沿”,用相对边沿描述可以让四种模式共享同一套控制逻辑。
| CPOL | CPHA | 空闲电平 | 领先边沿 | 采样边沿 | 数据更新边沿 |
|---|---|---|---|---|---|
| 0 | 0 | 低 | 上升沿 | 领先边沿 | 滞后边沿 |
| 0 | 1 | 低 | 上升沿 | 滞后边沿 | 领先边沿 |
| 1 | 0 | 高 | 下降沿 | 领先边沿 | 滞后边沿 |
| 1 | 1 | 高 | 下降沿 | 滞后边沿 | 领先边沿 |
CPHA=0 还有一个关键约束:第一位 MOSI 必须在第一个领先边沿到来前已经稳定;CPHA=1 则允许在第一个领先边沿到来时推出第一位数据。
用半周期节拍驱动一笔事务
把 SCLK 的每次翻转看成一个“半周期事件”。当计数器累计 CLK_DIV 个系统时钟后翻转一次 SCLK,因此 。事务开始时拉低 CS_N,把 SCLK 放到 CPOL 指定的空闲电平,并清零采样计数。
每次半周期事件到来时,若当前 SCLK 等于空闲电平,则下一次翻转形成领先边沿;否则形成滞后边沿。CPHA 再决定哪个边沿采样、哪个边沿更新数据。下面的主示例固定为 8 位、MSB first,CLK_DIV 必须大于等于 1;测试平台将 MISO 直接回接到 MOSI,因此接收结果应与发送字节一致。
`timescale 1ns/1ps

module spi_master_8bit #(
    parameter CPOL = 1'b0,
    parameter CPHA = 1'b0,
    parameter integer CLK_DIV = 2
)(
    input  wire       clk,
    input  wire       rst_n,
    input  wire       start,
    input  wire [7:0] tx_data,
    input  wire       miso,
    output reg        sclk,
    output reg        cs_n,
    output reg        mosi,
    output reg  [7:0] rx_data,
    output reg        busy,
    output reg        done
);

    reg [31:0] div_count;
    reg [7:0]  tx_shift;
    reg [7:0]  rx_shift;
    reg [3:0]  sample_count;

    always @(posedge clk or negedge rst_n) begin
        if (!rst_n) begin
            sclk         <= CPOL;
            cs_n         <= 1'b1;
            mosi         <= 1'b0;
            rx_data      <= 8'h00;
            busy         <= 1'b0;
            done         <= 1'b0;
            div_count    <= 32'd0;
            tx_shift     <= 8'h00;
            rx_shift     <= 8'h00;
            sample_count <= 4'd0;
        end else begin
            done <= 1'b0;

            if (!busy) begin
                sclk      <= CPOL;
                cs_n      <= 1'b1;
                div_count <= 32'd0;

                if (start) begin
                    busy         <= 1'b1;
                    cs_n         <= 1'b0;
                    tx_shift     <= tx_data;
                    rx_shift     <= 8'h00;
                    sample_count <= 4'd0;

                    // CPHA=0 要求首个采样边沿到来前,最高位已经稳定在 MOSI。
                    if (CPHA == 1'b0)
                        mosi <= tx_data[7];
                end
            end else if (div_count == CLK_DIV - 1) begin
                div_count <= 32'd0;

                if (sclk == CPOL) begin
                    // 当前处于空闲电平,翻转后形成 leading edge。
                    sclk <= ~sclk;

                    if (CPHA == 1'b0) begin
                        rx_shift     <= {rx_shift[6:0], miso};
                        sample_count <= sample_count + 1'b1;
                    end else begin
                        mosi     <= tx_shift[7];
                        tx_shift <= {tx_shift[6:0], 1'b0};
                    end
                end else begin
                    // 当前处于活动电平,翻转后形成 trailing edge。
                    sclk <= ~sclk;

                    if (CPHA == 1'b0) begin
                        if (sample_count == 4'd8) begin
                            rx_data <= rx_shift;
                            busy    <= 1'b0;
                            done    <= 1'b1;
                            cs_n    <= 1'b1;
                            sclk    <= CPOL;
                        end else begin
                            tx_shift <= {tx_shift[6:0], 1'b0};
                            mosi     <= tx_shift[6];
                        end
                    end else begin
                        rx_shift     <= {rx_shift[6:0], miso};
                        sample_count <= sample_count + 1'b1;

                        if (sample_count == 4'd7) begin
                            rx_data <= {rx_shift[6:0], miso};
                            busy    <= 1'b0;
                            done    <= 1'b1;
                            cs_n    <= 1'b1;
                            sclk    <= CPOL;
                        end
                    end
                end
            end else begin
                div_count <= div_count + 1'b1;
            end
        end
    end
endmodule

module tb;
    reg clk = 1'b0;
    reg rst_n = 1'b0;
    reg start = 1'b0;
    reg [7:0] tx_data = 8'hA5;

    wire sclk;
    wire cs_n;
    wire mosi;
    wire miso = mosi;
    wire [7:0] rx_data;
    wire busy;
    wire done;

    always #5 clk = ~clk;

    spi_master_8bit #(
        .CPOL(1'b0),
        .CPHA(1'b0),
        .CLK_DIV(2)
    ) dut (
        .clk(clk),
        .rst_n(rst_n),
        .start(start),
        .tx_data(tx_data),
        .miso(miso),
        .sclk(sclk),
        .cs_n(cs_n),
        .mosi(mosi),
        .rx_data(rx_data),
        .busy(busy),
        .done(done)
    );

    initial begin
        #30 rst_n = 1'b1;
        @(negedge clk);
        start = 1'b1;
        @(negedge clk);
        start = 1'b0;

        wait(done);
        $display("rx_data=0x%02h", rx_data);
        if (rx_data == 8'hA5)
            $display("PASS");
        else
            $display("FAIL");

        $finish;
    end
endmodule
预期结果:
编译成功;Mode 0 回环结束时 rx_data=8'hA5,done 仅拉高一个系统时钟周期,CS_N 回到高电平,SCLK 回到低电平。将主机与测试平台保存为 spi_master_tb.v 后执行:
iverilog -g2012 -o spi_tb spi_master_tb.v
vvp spi_tb
预期输出:
rx_data=0xa5
PASS
实际仿真时间会因工具设置不同而变化,但回环接收值应保持为 0xA5。
检查事务结束边界
发送和采样正确还不够,事务边界也必须明确。CS_N 应在整个 8 位传输期间保持为低,最后一个有效采样完成后再回到高电平;SCLK 在空闲阶段必须稳定在 CPOL 指定的电平。若过早释放片选,从设备可能忽略最后一位,或者把下一次时钟误判为新事务的一部分。
接到真实外设前确认约束
首先核对从设备数据手册中的 SPI mode,不能只看“支持 SPI”就假定 Mode 0。其次确认最大 SCLK 频率以及 CS_N 的建立、保持时间;如果外设要求片选拉低后等待若干纳秒,主机状态机应增加等待阶段。最后确认位序,本例固定为 MSB first;若外设要求 LSB first,需要同时调整 MOSI 推送和 MISO 拼接方向。
把设计约束成“半周期事件 + leading/trailing edge + CPHA 规则”后,四种 SPI 模式可以共享同一套控制框架。之后扩展到多字节事务、可编程位宽或连续片选时,仍要保持采样边沿、数据稳定窗口和片选边界一致。