
FPGA 与数字 IC 设计 / 系统课时
用流水与结构调整修复时序
用流水与结构调整修复时序
实现后出现负裕量时,真正要修的是关键路径上的组合深度、扇出或布线压力,而不是先放宽约束。本篇继续遵守课程既定的 Verilog-2005 基线,用一个可仿真的流水化例子说明如何切断长组合路径,并给出结构重构与重新验收的判断顺序。
学习目标
- 能从关键路径报告区分逻辑级数、布线延迟与高扇出问题
- 能用寄存器流水、平衡结构和局部控制复制缩短单周期路径
- 能在增加流水级后同步处理数据延迟与控制信号,并重新验收时序
先定位真正限制频率的路径
时序修复应从实现后的关键路径开始。对一条寄存器到寄存器路径,负裕量意味着数据到达时间晚于要求时间。先看起点、终点、逻辑级数、单元延迟、布线延迟和扇出,再决定改 RTL 还是改结构。
如果逻辑延迟占大头,常见原因是长加法链、大比较链、优先级多路选择或乘加全部压在一个周期;如果布线延迟占比很高,则要重点检查高扇出控制、跨区域连接和布局拥塞。只看到 WNS 为负就盲目插寄存器,可能把问题从逻辑延迟变成新的路由瓶颈。
用流水线切断长组合深度
流水化的核心是把“一个周期完成很多级组合计算”改成“多个周期各完成较短的一段”。吞吐量通常仍可保持为每拍接收一组数据,但首个结果会晚若干拍出现,因此与数据绑定的 valid、使能、标签或地址也必须按相同级数延迟。
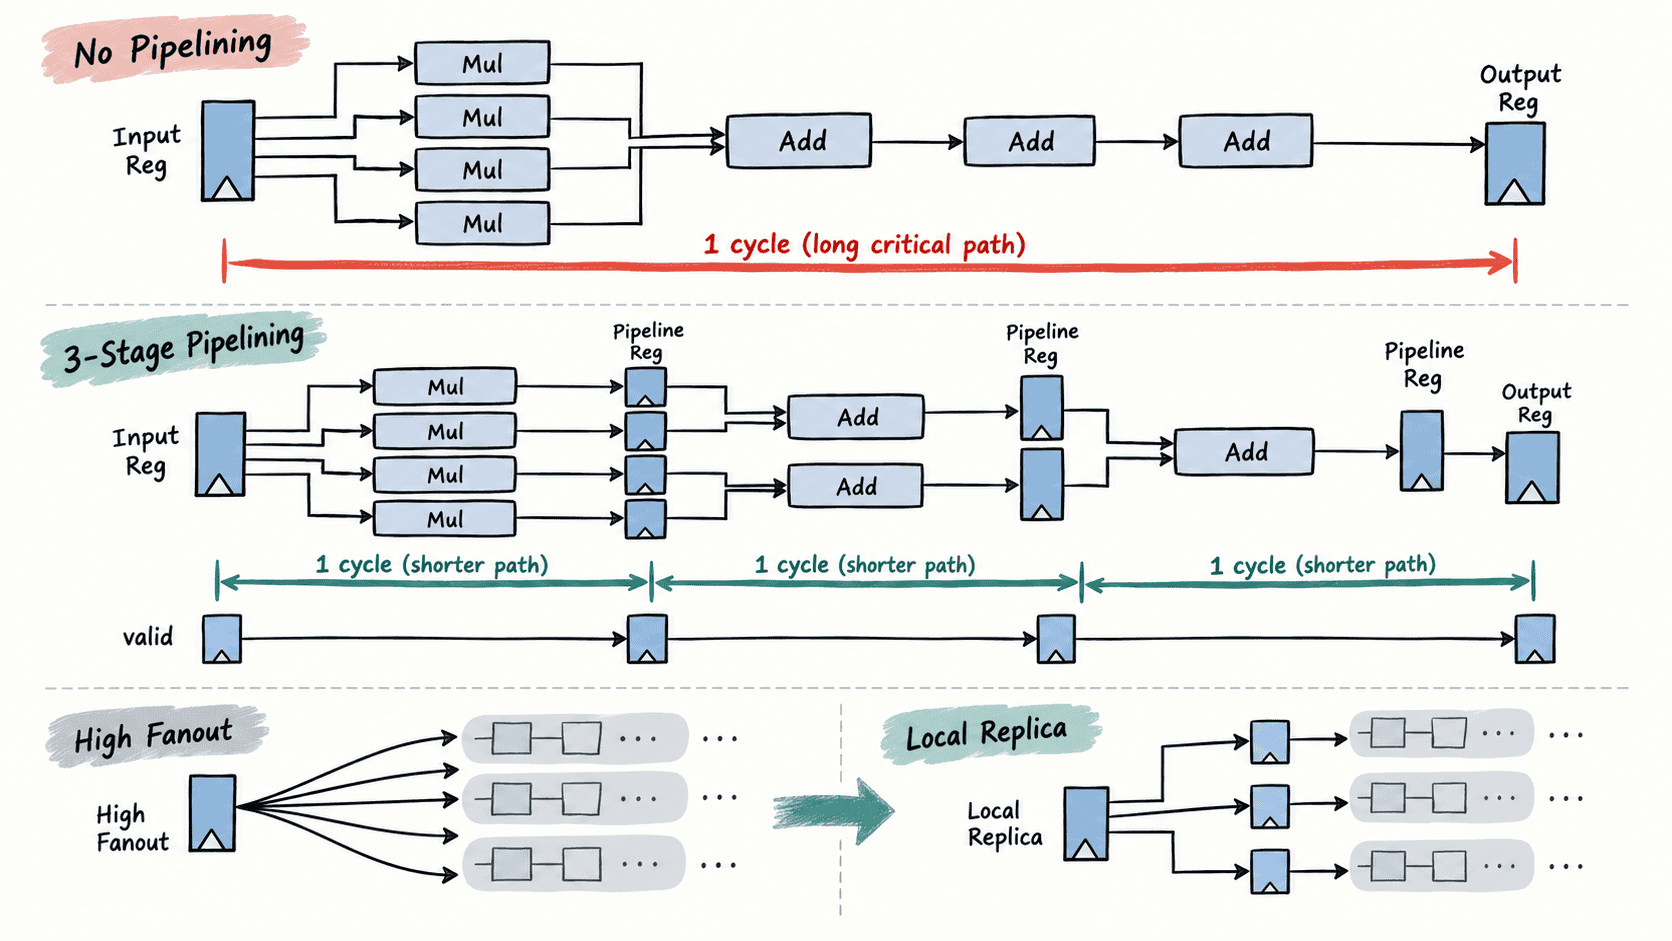
课程在前文已固定 Verilog-2005 工具与语法基线,因此这里不再使用 SystemVerilog 的 logic、always_ff、端口 .* 或 .sv 文件。下面把同一个三级流水思路写成 Verilog-2005:第一级寄存四个乘积,第二级完成两组加法,第三级完成最终求和,同时让 valid_i 穿过相同的三级寄存链。
`timescale 1ns/1ps

module pipelined_dot4 (
    input             clk,
    input             rst_n,
    input             valid_i,
    input      [7:0]  a0, b0, a1, b1, a2, b2, a3, b3,
    output reg        valid_o,
    output reg [17:0] sum_o
);
    reg [15:0] p0, p1, p2, p3;
    reg [16:0] s0, s1;
    reg v1, v2;

    always @(posedge clk) begin
        if (!rst_n) begin
            p0 <= 16'd0; p1 <= 16'd0; p2 <= 16'd0; p3 <= 16'd0;
            s0 <= 17'd0; s1 <= 17'd0; sum_o <= 18'd0;
            v1 <= 1'b0; v2 <= 1'b0; valid_o <= 1'b0;
        end else begin
            // 每一级寄存器只承接一小段组合逻辑,降低单周期逻辑深度。
            p0 <= a0 * b0;
            p1 <= a1 * b1;
            p2 <= a2 * b2;
            p3 <= a3 * b3;
            s0 <= p0 + p1;
            s1 <= p2 + p3;
            sum_o <= s0 + s1;

            // 控制信号与数据使用相同的三级寄存链,保持拍数对齐。
            v1 <= valid_i;
            v2 <= v1;
            valid_o <= v2;
        end
    end
endmodule

module tb;
    reg clk;
    reg rst_n;
    reg valid_i;
    reg [7:0] a0, b0, a1, b1, a2, b2, a3, b3;
    wire valid_o;
    wire [17:0] sum_o;

    pipelined_dot4 dut (
        .clk(clk), .rst_n(rst_n), .valid_i(valid_i),
        .a0(a0), .b0(b0), .a1(a1), .b1(b1),
        .a2(a2), .b2(b2), .a3(a3), .b3(b3),
        .valid_o(valid_o), .sum_o(sum_o)
    );

    always #5 clk = ~clk;

    initial begin
        clk = 1'b0;
        rst_n = 1'b0;
        valid_i = 1'b0;
        a0 = 8'd0; b0 = 8'd0; a1 = 8'd0; b1 = 8'd0;
        a2 = 8'd0; b2 = 8'd0; a3 = 8'd0; b3 = 8'd0;

        repeat (2) @(posedge clk);
        rst_n = 1'b1;

        // 在下降沿准备输入,保证下一个上升沿稳定采样。
        @(negedge clk);
        a0 = 8'd2; b0 = 8'd3;
        a1 = 8'd4; b1 = 8'd5;
        a2 = 8'd6; b2 = 8'd7;
        a3 = 8'd1; b3 = 8'd2;
        valid_i = 1'b1;

        @(negedge clk);
        valid_i = 1'b0;

        // 等待与结果同步的 valid_o,而不是依赖固定仿真延时。
        wait (valid_o == 1'b1);
        if (sum_o !== 18'd70) begin
            $display("ERROR sum=%0d", sum_o);
            $finish;
        end
        $display("sum=%0d", sum_o);
        $finish;
    end
endmodule
将代码保存为 pipeline_tb.v,再用 Icarus Verilog 的 Verilog-2005 模式编译并运行:
iverilog -g2005 -o pipeline_tb pipeline_tb.v
vvp pipeline_tb
预期输出:
sum=70这说明流水化没有改变数学结果,且 valid_o 与对应结果同时到达。这里验证的是功能与控制对齐;实际最高频率仍必须以目标 FPGA 综合和实现后的时序报告为准。若接口协议要求固定延迟,还应在系统级测试中继续检查每笔输入与输出的拍数关系。
结构重构不只是增加寄存器
有些关键路径不适合继续增加接口延迟,这时要降低每拍内部的结构复杂度。串行求和 (((a+b)+c)+d) 往往比平衡树 (a+b)+(c+d) 具有更深的逻辑级数;复杂条件链也可以拆成局部比较后再汇总。对乘加、移位和存储访问,还要确认综合器是否能映射到目标器件的 DSP、BRAM 或专用进位资源。
高扇出控制是另一类常见问题。一个 enable 或状态位同时驱动大量远端寄存器时,布线和缓冲会成为关键路径。可以让综合或物理优化工具做寄存器复制,也可以在 RTL 中生成语义等价的局部控制副本,但必须保证副本位于同一时钟域并在同一周期更新,不能复制时钟本身来“分担扇出”。
重新实现并按四项验收
修复完成后,至少重新检查四件事:关键路径是否真的变短,WNS/TNS 是否满足目标,资源与功耗是否出现不可接受的增长,以及功能延迟是否仍符合接口协议。新增流水寄存器会增加触发器并改变延迟,高扇出复制也可能增加面积,因此不能只以“WNS 转正”作为唯一成功标准。
如果关键路径仍由长组合逻辑主导,继续做流水或平衡结构;如果逻辑已很浅却布线延迟占大头,应转向扇出、布局和物理优化。只有当路径在功能上确实不需要按普通单周期关系检查时,才进入例外时序约束的讨论,不能用例外约束替代结构修复。