
PostgreSQL / 系统课时
理解应用连接池复用
理解应用连接池复用
应用连接池把昂贵的 PostgreSQL 连接从“每次请求新建、用完销毁”改成“集中创建、按需借用、用完归还”。本课重点是看懂连接获取、归还、空闲和创建之间的关系,并明确 max、min、等待超时分别控制什么。
学习目标
- 能描述一个连接从创建到归还的完整生命周期
- 能区分连接池容量、空闲保活与等待超时三个参数
- 能根据并发量判断连接池是否可能成为瓶颈
连接池复用的本质
数据库连接不是普通对象。建立连接通常涉及网络握手、认证、会话初始化以及服务端资源分配,因此把连接长期复用起来,通常比请求级反复创建更稳定。
连接池维护的是一组可借用的连接。业务线程或协程请求连接时,如果存在空闲连接,就直接取出;没有空闲连接但总连接数尚未达到上限,则创建新连接;已经达到上限时,新请求进入等待状态,直到其他请求归还连接或等待超时。
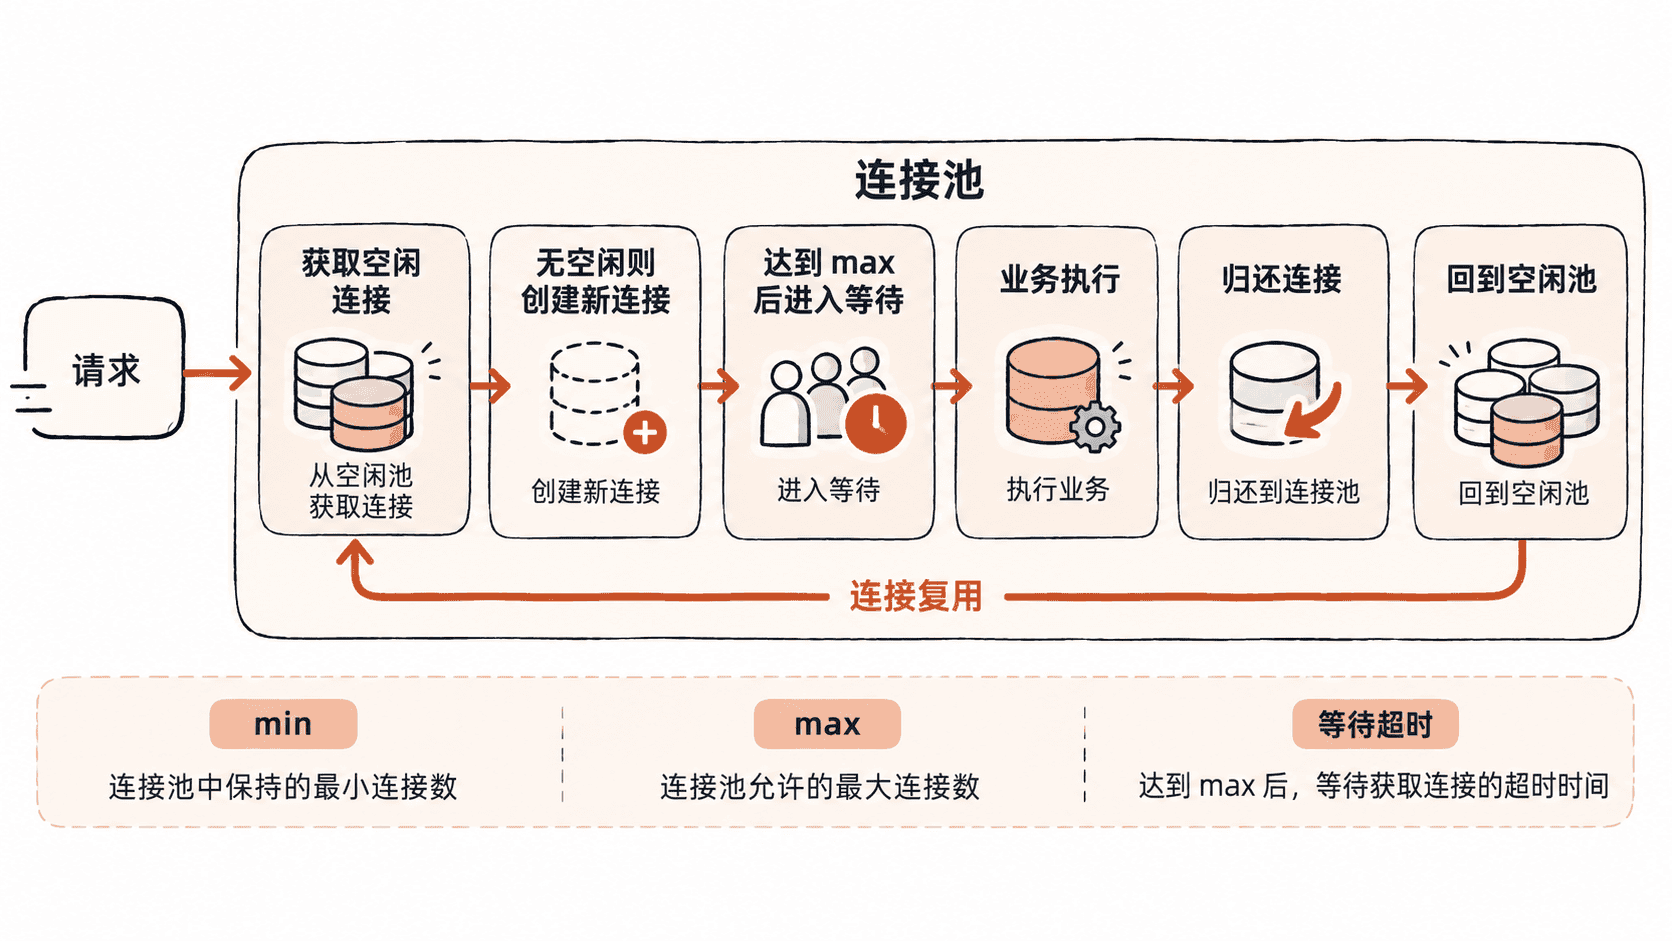
“归还”不是关闭数据库连接。正常情况下,归还只是把连接重新放回池中,后续请求继续复用;只有连接失效、池关闭或满足淘汰条件时,池才会真正关闭并重新创建物理连接。这一区别决定了连接池能否真正降低建连成本。
max、min 与等待超时的边界
max 表示池允许同时持有的最大物理连接数。它首先是一个容量上限,而不是吞吐保证。把 max 调得很大并不会线性提高吞吐,反而可能让 PostgreSQL 同时承受更多活跃查询、内存和锁竞争。
min 的语义取决于具体连接池实现。有些实现会主动维持最小连接数,有些实现只保证已有空闲连接不会轻易缩减到更低水平。因此配置 min 之前必须先确认所用连接池的实现语义,不能把它一概理解成“启动时立刻创建 min 个连接”。
等待超时控制的是“拿不到连接时最多等多久”,它通常不是 PostgreSQL 查询超时,也不是网络连接建立超时。一个请求可能成功拿到连接,但 SQL 执行很慢,此时等待超时并不会中断正在执行的 SQL。
| 参数 | 主要控制 | 不代表 |
|---|---|---|
max |
池的最大物理连接数 | 数据库可承受的最大并发 |
min |
最小保有或预热策略,取决于实现 | 一定会预先建立固定数量连接 |
| 等待超时 | 无连接可借用时的最长等待 | SQL 执行最长时间 |
用一个最小池观察复用
下面以 Python 的 psycopg_pool 为例。示例设置 max_size=4,连续两次借用连接并查询同一个数据库连接标识。实际连接池还会根据连接空闲时间和生命周期策略回收失效连接。
from psycopg_pool import ConnectionPool

pool = ConnectionPool(
    "postgresql://app:password@127.0.0.1:<PORT>/appdb",
    min_size=1,
    max_size=4,
    timeout=2.0,
)

try:
    with pool.connection() as conn:
        with conn.cursor() as cur:
            cur.execute("select pg_backend_pid()")
            first_pid = cur.fetchone()[0]
            print(f"first connection pid={first_pid}")

    with pool.connection() as conn:
        with conn.cursor() as cur:
            cur.execute("select pg_backend_pid()")
            second_pid = cur.fetchone()[0]
            print(f"second connection pid={second_pid}")
finally:
    pool.close()
预期输出:
first connection pid=<PID>
second connection pid=<PID>
两次请求都可能得到同一个 <PID>,因为连接已经归还到池中并被再次复用;<PID> 是实际 PostgreSQL 后端进程号,每次运行的值可能不同。示例重点不是保证两个请求永远拿到同一连接,而是说明“归还后可再次借用”是连接池的核心复用机制。
连接池为什么会耗尽
当同时占用连接的请求数达到 max 后,后续请求不会自动获得更多连接,只能等待已有连接归还。于是一个慢 SQL、长事务或业务代码忘记归还连接,都可能把局部延迟放大成连接池等待。
因此排查连接池耗尽时,不应只看 max 是否太小,还应同时看活跃连接数、等待请求数、单次连接占用时间以及数据库侧的活动会话。真正需要治理的是“连接被占用多久”和“为什么迟迟没有归还”,而不只是继续把池容量调大。