
PostgreSQL / 系统课时
演练连接风暴定位
演练连接风暴定位
本课通过一次可控的连接风暴演练,建立从应用连接池、代理层到 PostgreSQL 会话的逐层取证方法。重点不是先杀连接,而是沿着数量、等待和时间三个维度还原触发点,以及每一层如何把问题进一步放大。
学习目标
- 能区分应用池、代理层和 PostgreSQL 会话三个观测层,并明确各层证据的用途。
- 能用连接数量、空闲状态和等待信息定位连接风暴的主要触发点。
- 能把观测结果串成“触发→排队→放大”的因果链,而不是只看数据库当前连接数。
先建立三层证据链
连接风暴通常不是 PostgreSQL 单点突然产生大量会话,而是上游异常通过多个层次逐级放大。定位时应先回答“谁在增加连接”,再回答“这些连接为什么没有及时释放”,最后判断数据库是否已经进入资源争用。
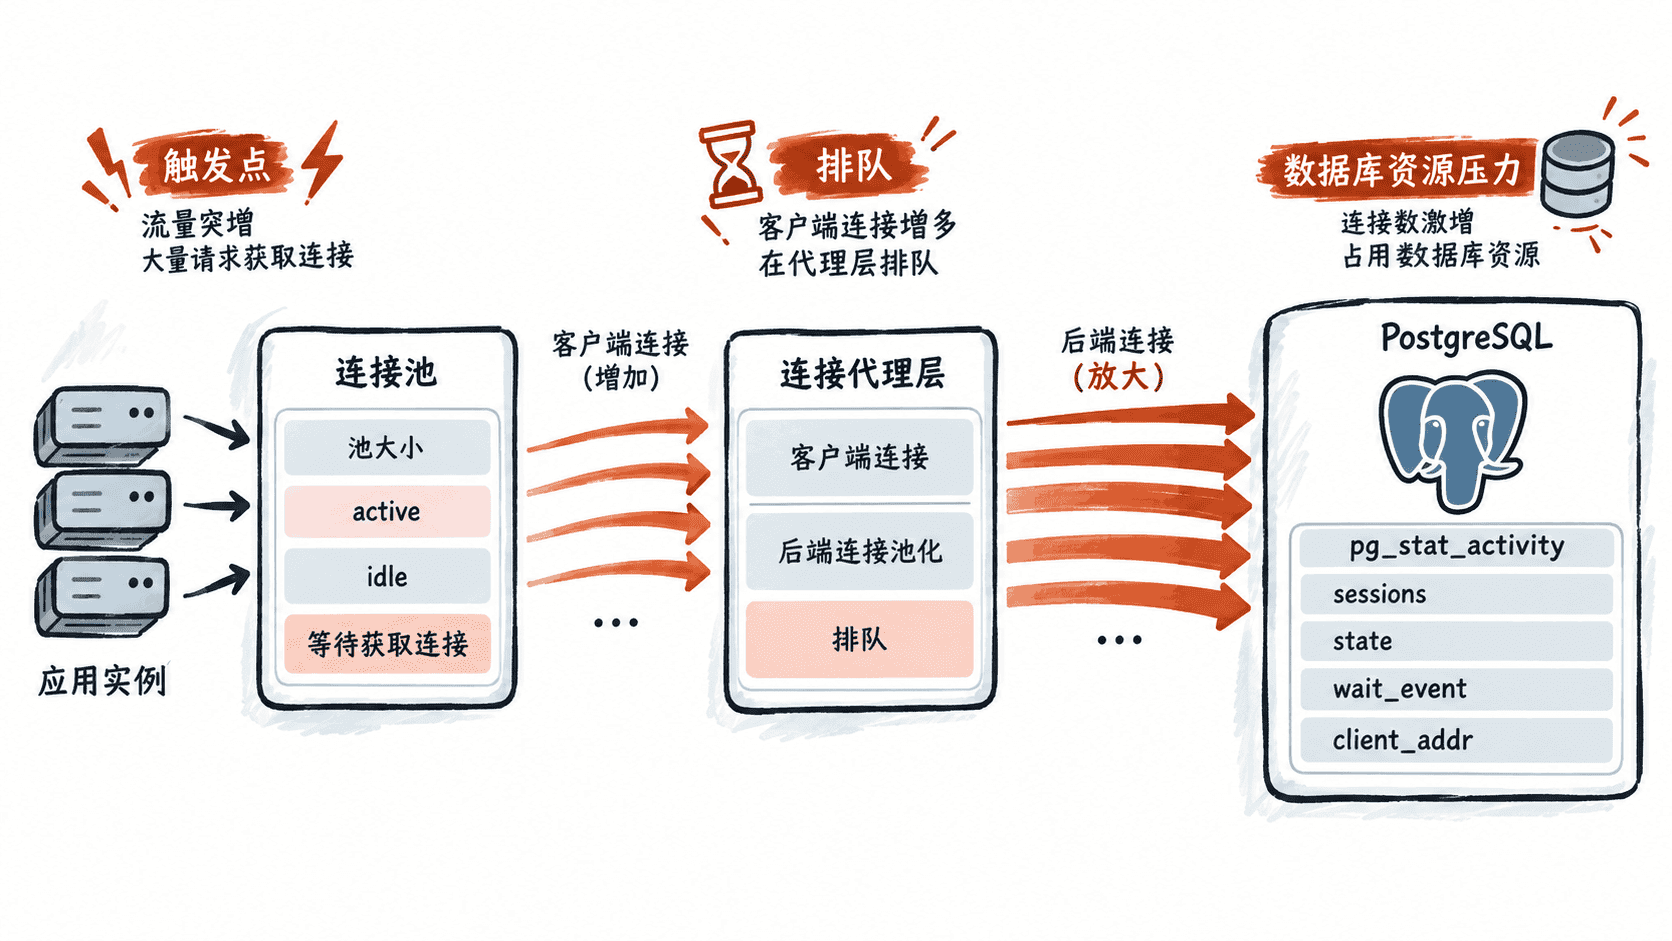
应用层最有价值的证据是连接池正在做什么。记录活跃连接、空闲连接、等待获取连接的请求数,以及池上限和实例数量。假设单实例池上限为 50、实例数为 10,那么理论上游侧可以同时持有约 500 个数据库连接;这只是容量上限,不代表数据库实际会话一定达到该数量。
代理层要确认两个问题:客户端连接是否在增加,以及代理到 PostgreSQL 的后端连接是否同步增加。若客户端连接暴增而后端连接基本稳定,问题可能主要发生在代理层排队;若两者同时增长,则需要继续向数据库侧取证。
PostgreSQL 侧怎么看增长来源
首先查看当前会话分布,不要只执行一个总数查询。state 可以帮助区分正在运行、空闲和事务中空闲的会话;client_addr 和 application_name 则用于追溯连接来源。
SELECT
    COALESCE(application_name, '') AS application_name,
    state,
    COUNT(*) AS sessions
FROM pg_stat_activity
WHERE pid <> pg_backend_pid()
GROUP BY application_name, state
ORDER BY sessions DESC;
预期结果
 application_name | state               | sessions
------------------+---------------------+----------
 api               | idle                | 180
 api               | active              | 24
 worker             | idle in transaction | 8
实际输出的应用名、状态和值会因环境而不同。这里最重要的不是绝对数量,而是观察是否存在某个应用的大量会话集中在单一状态,以及这种分布是否与应用池指标同步变化。
接着按客户端地址观察来源,帮助确认连接是否集中来自少数实例或节点。
SELECT
    COALESCE(client_addr::text, 'local') AS client_addr,
    COUNT(*) AS sessions
FROM pg_stat_activity
WHERE pid <> pg_backend_pid()
GROUP BY client_addr
ORDER BY sessions DESC;
预期结果
 client_addr | sessions
-------------+----------
 10.0.0.21   | 96
 10.0.0.22   | 91
 10.0.0.23   | 8
当某个实例的会话数远高于其他实例时,应回到该实例核对连接池配置、实例重启、请求流量和连接获取等待,而不是直接认定 PostgreSQL 出现连接泄漏。
判断连接为什么没有被释放
连接数持续升高只说明“占用没有下降”,不能直接证明是连接泄漏。常见原因包括请求突增、连接池上限过大、SQL 执行变慢、事务未结束,或者代理层排队使连接生命周期变长。
优先检查 state 与 wait_event 的组合。大量 active 且伴随等待,通常更值得关注数据库内部资源争用;大量 idle in transaction 则要检查业务事务边界;大量普通 idle 则更像池中保留连接,而不是数据库正在执行大量工作。
SELECT
    pid,
    usename,
    application_name,
    state,
    wait_event_type,
    wait_event,
    now() - state_change AS state_age,
    left(query, 100) AS query_sample
FROM pg_stat_activity
WHERE pid <> pg_backend_pid()
ORDER BY state_age DESC
LIMIT 20;
预期结果
 pid   | usename | application_name | state               | wait_event_type | wait_event | state_age | query_sample
-------+---------+------------------+---------------------+-----------------+------------+-----------+-------------
 <PID> | app     | api              | idle in transaction | Client          | ClientRead | <TIME>    | <SQL>
 <PID> | app     | api              | active              | Lock            | <VALUE>   | <TIME>    | <SQL>
state_age 只是说明当前状态持续多久,不等于整个连接存活时间。要判断是不是异常长生命周期,还需要结合连接池创建时间、事务开始时间和业务请求耗时一起看。
还原触发点与放大链路
把三个层次的数据按时间对齐,就能从“现象”还原成“因果”。例如某次发布后,请求耗时先升高,随后应用池 active 上升并出现大量等待;代理后端连接开始扩张;最后 PostgreSQL 出现更多 active 会话和锁等待。此时更合理的假设是请求变慢导致连接占用时间拉长,连接池再通过补充连接把压力向数据库传递。
真正的演练结论应至少包含四个证据:最先变化的指标、随后增长的连接层、主要会话状态、最终资源等待。只有这四项能够按时间串起来,才能把连接风暴定位到具体触发点,而不是停留在“数据库连接很多”的表象。